📑 Mục lục chi tiết bài viết (31 mục)
- Amazon thay Sonnet 4.6 bằng Strands Decider E4B để gắn nhãn ticket nội bộ
- Hệ thống ticketing nội bộ lớn nhất của Amazon và 20 loại nhãn ticket
- Sonnet 4.6 gắn nhãn ticket trước đây bằng cách nào
- Decider E4B gắn nhãn ticket hiện tại bằng cách nào
- Con số rẻ hơn 98% tính trên giá list, phần nào chưa đếm vào phép tính
- Bảng giá list Bedrock và SageMaker làm cơ sở cho phép tính 22.200 USD so với 500 USD
- Từ 4.215 ms xuống 897 ms, token từ 6.724 xuống 2.010 theo số đo của Amazon
- Phần chi phí vẫn chưa đếm vào phép so sánh 98%
- Strands Decider E4B, model không sinh text chạy trên nền Gemma 4 của Google
- Decision model không sinh text, chỉ chọn đáp án và trả xác suất
- Vì sao bản E4B chọn nền Gemma 4 của Google thay vì Qwen 2B
- Bốn cỡ Gemma 4 trên bảng JevBench, E4B đúng 187 trên 231
- Phép so sánh của Amazon chỉ đúng khi gắn nhãn ticket 20 loại
- Sonnet 4.6 ra tháng 02/2026 và đã bị Sonnet 5 thay thế từ 30/06/2026
- Việc gắn nhãn 20 loại lặp đi lặp lại, đúng đất cho decision model thắng
- Decision model bùng nổ thành danh mục mới từ Jev ngày 15/09/2026 đến 09/10/2026
- Hacker News tranh luận hai phía về Amazon thay Sonnet bằng Decider
- Phe nghi ngờ cho rằng bài gốc AWS tự khen mình, giá list 3 USD khác giá Amazon thực trả
- Phe classifier truyền thống nói dùng LLM làm classifier là lãng phí
- Phe thực dụng nói LLM khởi động nhanh rồi distill thành classifier chuyên dụng
- Bốn điểm cần đọc kỹ trước khi tin con số 98% của Amazon
- Số liệu Amazon tự đo tự báo trên blog AWS, một nguồn duy nhất chưa kiểm chứng độc lập
- Sonnet 4.6 đã cũ, đã bị Sonnet 5 thay thế từ 30/06/2026
- Tiết kiệm hàng triệu USD không có số tuyệt đối vì thiếu tổng ticket mỗi năm
- Giảm 98% chi phí chỉ đúng khi chọn đáp án trong danh mục cố định
- Team nhỏ áp dụng mô hình Amazon và thử Strands Decider E4B ngay hôm nay
- Quy trình 2 giai đoạn LLM seed nhãn rồi thay bằng decision model khi đủ quy mô
- Công tắc 3 chiều BEDROCK DUAL DECIDER và cách revert trong 45 giây của Amazon
- Thử Strands Decider E4B ngay hôm nay với pip install và checkpoint trên Hugging Face
- Ba cái bẫy khi thử Decider E4B, từ context 4.096 token tới cutoff confidence
- Amazon tiết kiệm 98% chi phí gắn nhãn ticket, team nhỏ học được cách thay model
Amazon vừa công bố một con số nghe rất kêu, thay Claude Sonnet 4.6 bằng Strands Decider E4B thì chi phí gắn nhãn ticket giảm từ khoảng 22.200 USD xuống khoảng 500 USD cho mỗi triệu ticket, tức rẻ hơn 98%, mà toàn bộ số liệu này đều là số hãng tự đo, đăng trên blog AWS ngày 09/11/2026, chưa có kiểm chứng độc lập nào. Nghe thì sướng tai đấy.
Kết luận nhanh cho anh em bận rộn: đây là một ca thay model rất đáng học, nhưng con số tiết kiệm chỉ đúng trong phạm vi giá list và đúng một việc duy nhất là gắn nhãn ticket, còn độ tin cậy thì vẫn treo ở một nguồn duy nhất là chính AWS, chưa có ai đo lại.
Amazon thay Sonnet 4.6 bằng Strands Decider E4B để gắn nhãn ticket nội bộ
Con số 98% nghe rất kêu, nhưng trước khi tin thì anh em cần biết Amazon thay cái gì bằng cái gì, trong hệ thống nào, vì chỉ một chi tiết sai ở đây là cả phép so sánh đổi nghĩa.
Hệ thống ticketing nội bộ lớn nhất của Amazon và 20 loại nhãn ticket
Hai kỹ sư Amazon là Carr và Mehul thay Sonnet 4.6 bằng Decider E4B để gắn nhãn ticket nội bộ, bài gốc đăng trên blog Strands Agents ngày 09/11/2026, mỗi ticket xếp vào 1 trong 20 loại, như leo thang khách hàng, yêu cầu dung lượng, cảnh báo tự động hay phát hiện bảo mật. Ticket đi vào SQS queue, queue kích hoạt Lambda, Lambda đọc dữ liệu ticket rồi gọi endpoint SageMaker AI, AppConfig giữ công tắc, CloudWatch giữ log và metric, stack định nghĩa bằng CDK với ba stage Beta, Gamma, Prod.
Sonnet 4.6 gắn nhãn ticket trước đây bằng cách nào
Trước khi thay, Sonnet 4.6 chạy với system prompt dài trên mỗi ticket, sinh JSON và suy luận theo tập nhãn cố định, mỗi ticket tốn input 6.554 token và output 170 token, tổng 6.724 token, mỗi cuộc gọi 4.215 ms, chi phí 0,0222 USD. Giá list trên Bedrock là 3 USD input và 15 USD output mỗi triệu token, cách làm này lãng phí cho việc lặp lại nhưng giúp team chạy ngay mà không cần dataset gắn nhãn. Mình thấy cách này hợp lúc khởi động, vì team chạy ngay được mà chưa phải lo dataset.
Decider E4B gắn nhãn ticket hiện tại bằng cách nào
Decider E4B nhận ticket làm state, nhận 20 nhãn viết lại thành tiêu chí 1 đến 2 câu làm lựa chọn của một câu hỏi duy nhất, cộng thêm lựa chọn none, rồi trả xác suất kèm điểm confidence, không sinh text. Sau khi thay, token mỗi ticket còn 2.010, giảm 70%, thời gian mỗi cuộc gọi còn 897 ms, giảm 78%, thời gian thực thi Lambda trung bình giảm 74%, chi phí còn khoảng 0,0005 USD mỗi ticket. Hạ tầng là SageMaker ml.g5.xlarge, 1 GPU A10G 24 GB mỗi instance, model dùng khoảng 19 GiB, một request khoảng 640 ms, endpoint tự autoscale, mạng cô lập không cho truy cập ra ngoài.
Con số rẻ hơn 98% tính trên giá list, phần nào chưa đếm vào phép tính
Tới đây mới là phần đáng tiền nhất, vì 98% chỉ đúng khi hiểu đúng phạm vi của nó, mà phạm vi này nằm ở giá list và thông lượng giả định, chứ chưa phải hoá đơn thật Amazon phải trả. Đọc kỹ mới thấy khác.
Bảng giá list Bedrock và SageMaker làm cơ sở cho phép tính 22.200 USD so với 500 USD
Theo bài gốc, chi phí mỗi triệu ticket là Sonnet khoảng 22.200 USD, Decider khoảng 500 USD, rẻ hơn khoảng 44 lần, giảm 98%, phép tính này đúng trên giá list công khai. Giá list Sonnet 4.6 trên Bedrock là 3 USD input và 15 USD output mỗi triệu token, còn giá Decider trên SageMaker ml.g5.xlarge là 1,408 USD mỗi instance giờ, giá us-east-1 on-demand. Giá 1,408 USD mỗi giờ đã được kiểm chứng độc lập ở dev.to, wring.co và carpentries-incubator, anh em đừng trộn với giá EC2 g5.xlarge 1,006 USD mỗi giờ. Giá list vẫn khác giá Amazon thực trả, nên con số 98% nên đọc là rẻ hơn 98% trên giá list, chưa phải rẻ hơn 98% trên hoá đơn thật. Mình đọc tới đây thì chốt lại một câu, 98% là rẻ trên giá list, chứ chưa phải rẻ trên hoá đơn.
| Chỉ số | Sonnet 4.6 | Decider E4B |
|---|---|---|
| Thời gian mỗi cuộc gọi | 4.215 ms | 897 ms |
| Token mỗi ticket | 6.724 token | 2.010 token |
| Chi phí mỗi ticket | 0,0222 USD | khoảng 0,0005 USD |
| Chi phí mỗi triệu ticket | khoảng 22.200 USD | khoảng 500 USD |
Từ 4.215 ms xuống 897 ms, token từ 6.724 xuống 2.010 theo số đo của Amazon
Thời gian mỗi cuộc gọi giảm từ 4.215 ms xuống 897 ms, tức giảm 78%, thời gian thực thi Lambda trung bình giảm 74% trong ngày tắt Sonnet. Token mỗi ticket thì input giảm từ 6.554 xuống 2.009, output giảm từ 170 xuống 1, tổng từ 6.724 xuống 2.010, tức giảm 70%, tất cả đều là số Amazon tự đo tự báo trên blog của chính AWS, chưa có bên thứ ba nào đo lại. Thông lượng Decider cũng ghi rõ điều kiện đo, một instance xử lý khoảng 5.600 ticket mỗi giờ ở mức 640 ms mỗi request, tương đương 250 USD cho 1 triệu ticket khi dùng hết công suất, thực tế team tính khoảng 500 USD vì giữ dự phòng cho đợt cao điểm.
Phần chi phí vẫn chưa đếm vào phép so sánh 98%
Cả hai đầu vào đều là giá list, khác giá Amazon thực trả, phép so sánh chưa gồm chi phí vận hành trọn gói như endpoint chạy 24/7, Lambda, giám sát, nhân sự, nên 98% chỉ so sánh chi phí token và chi phí máy theo giá list, chưa phải tổng chi phí sở hữu của cả hệ thống. Phần tiết kiệm tuyệt đối còn mờ hơn, bài gốc không công bố tổng số ticket mỗi năm hay tổng chi phí trước và sau, nên cụm tiết kiệm hàng triệu USD là ước tính nội bộ, không kiểm chứng được từ bên ngoài.
Strands Decider E4B, model không sinh text chạy trên nền Gemma 4 của Google
Hiểu được Decider là gì thì mới thấy 98% hợp lý ở chỗ nào, vì Decider là một lớp model khác hẳn LLM, bỏ khả năng viết text để đổi lấy tốc độ và xác suất cho đúng việc chọn đáp án.
Decision model không sinh text, chỉ chọn đáp án và trả xác suất
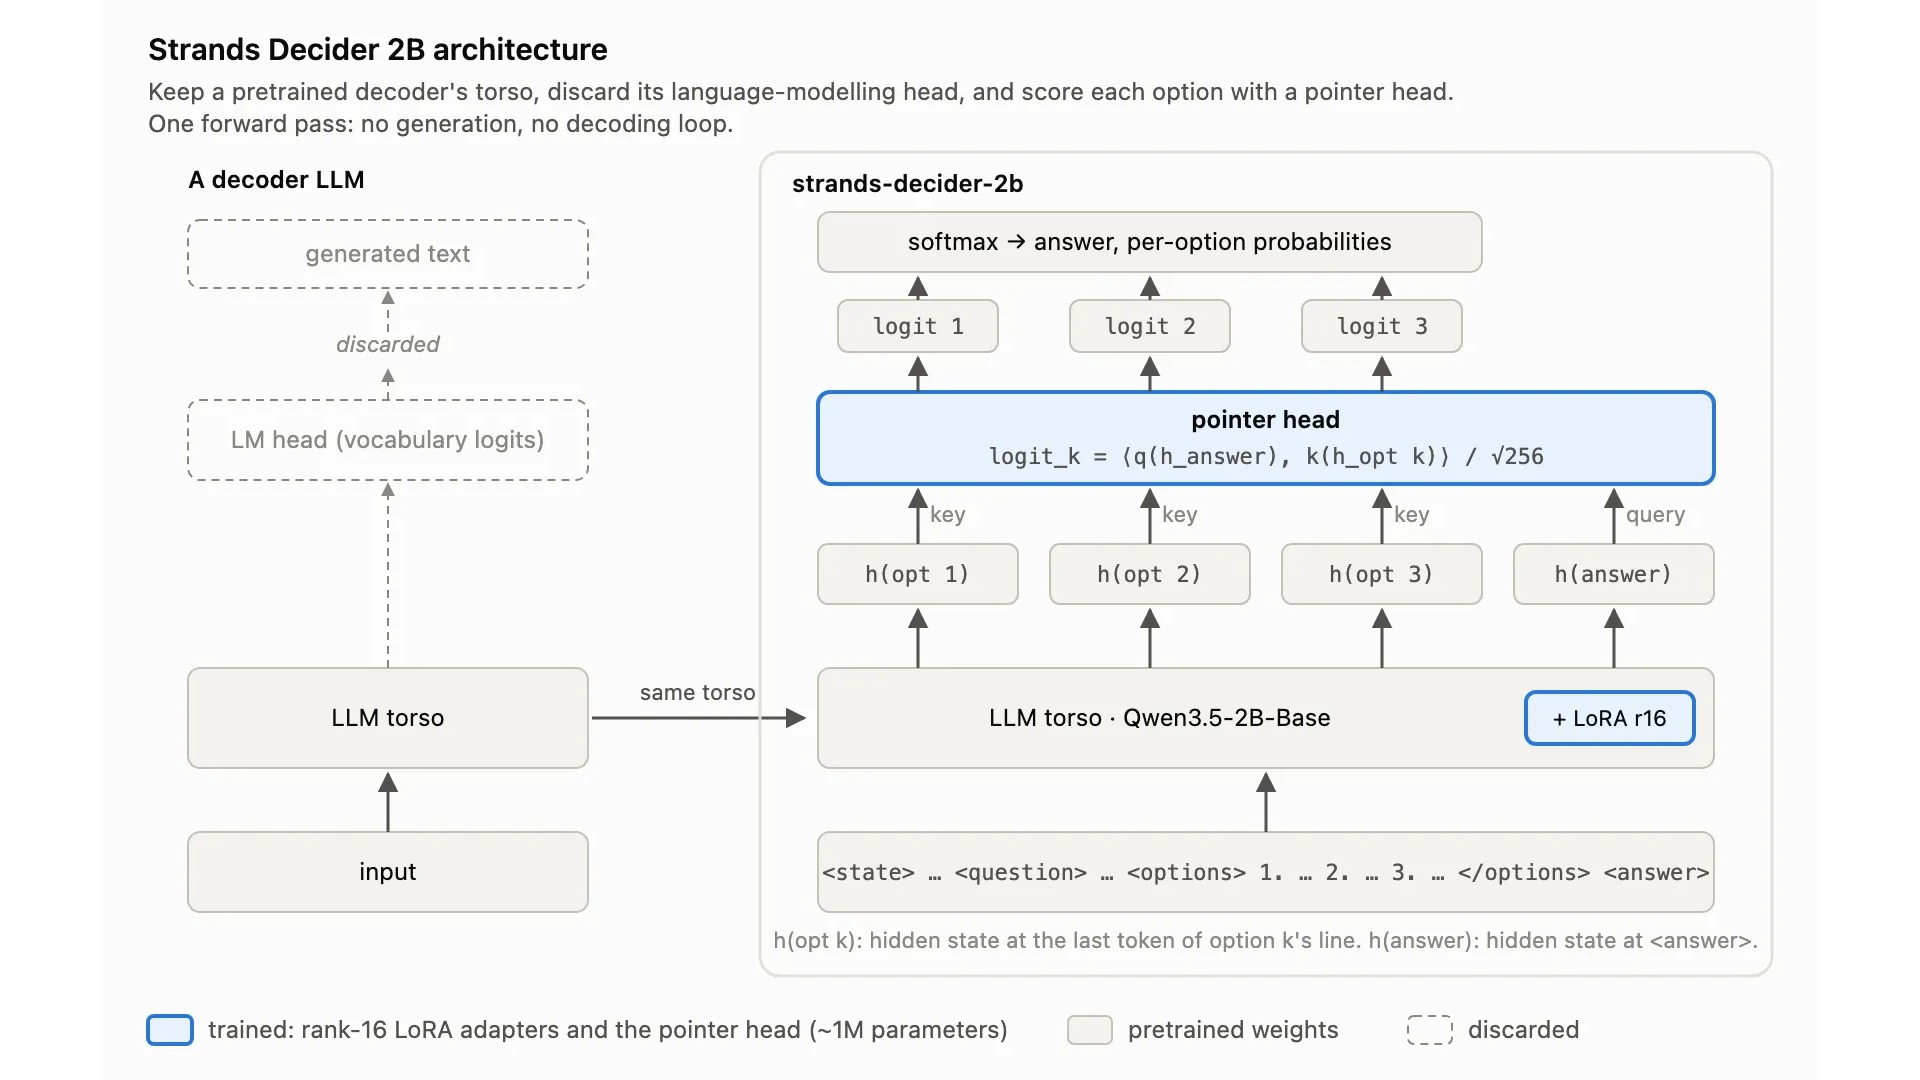
Strands Decider 2B ra mắt 01/10/2026 bởi Strands Labs, tác giả là Marc Brooker, Mike Chambers, Fabio Nonato de Paula, giấy phép Apache 2.0 cho code, adapter và head. Bản chất của nó là decision model, còn gọi là System One model, không sinh text, chỉ chọn một trong các lựa chọn cho sẵn và trả xác suất kèm điểm confidence. Kiến trúc bản 2B lấy torso của Qwen3.5-2B-Base, bỏ LM head, thay bằng pointer head khoảng 1 triệu tham số, một forward pass trả xác suất cho mỗi lựa chọn, khỏi vòng lặp decode từng token của LLM, nên nó nhanh chính vì nó trả đáp án trong một lần chạy. Nguồn gốc dự án là dự án cá nhân Hobson của Marc Brooker, checkpoint ra mắt là hobson-v19. Anh em đừng nhầm Decider với Strands Agents SDK, vì SDK là bộ công cụ xây agent còn Decider là decision model.
Vì sao bản E4B chọn nền Gemma 4 của Google thay vì Qwen 2B
Bốn cỡ Gemma 4 của Strands Decider phát hành 15/10/2026, gồm E2B, E4B, 12B, 26B-A4B, xây trên nền Gemma 4 instruction-tuned của Google, mỗi cỡ có adapter và readout head riêng. Checkpoint dùng trong vụ Amazon là strands-decider-E4B-gemma4-v1-2610, trên nền google/gemma-4-E4B-it. Gemma 4 gốc của Google ra 31/03/2026, riêng E4B khoảng 4,5 tỉ tham số hiệu dụng. Bản prototype dùng Qwen 3.5 2B, bản production dùng Gemma 4 vì chính xác hơn, cả hai đều mang tên Strands Decider, nên độc giả hay nhầm hai bản này là hai model khác nhau.
Bốn cỡ Gemma 4 trên bảng JevBench, E4B đúng 187 trên 231
Bảng JevBench v1, 231 tác vụ public, cửa sổ 4.096 token, median latency trên một NVIDIA H100 80 GB, cho thấy E2B đúng 180/231, tỷ lệ 77,9%, Brier 0.313, 102 ms, E4B đúng 187/231, tỷ lệ 81,0%, Brier 0.243, 139 ms, 12B đúng 200/231, tỷ lệ 86,6%, Brier 0.173, 136 ms, 26B-A4B đúng 207/231, tỷ lệ 89,6%, Brier 0.162, 245 ms. Đọc bảng này thì nhớ ghi kèm tên checkpoint, cửa sổ token và máy đo cho mỗi con số, đừng viết gọn thành Decider đạt X điểm. FactualMinds cảnh báo chênh lệch dưới 10 tác vụ JevBench chưa kết luận được, cutoff 0.9 chỉ đúng cho short classification, còn VentureBeat và Stackness nhắc email và biểu đồ của AWS không chứng minh Decider thắng Jev nói chung, biểu đồ còn gắn nhãn sai hai điểm của model khác tên decider-2B. Và JevBench không trả lời được Decider có chính xác hơn Jev trên ticket của bạn không, chỉ tập nhãn của chính bạn mới trả lời được.
| Cỡ Gemma 4 | Đúng trên JevBench v1 | Tỷ lệ | Brier (điểm hiệu chuẩn, thấp hơn là tốt hơn) | Median latency trên H100 80 GB |
|---|---|---|---|---|
| E2B | 180/231 | 77,9% | 0.313 | 102 ms |
| E4B | 187/231 | 81,0% | 0.243 | 139 ms |
| 12B | 200/231 | 86,6% | 0.173 | 136 ms |
| 26B-A4B | 207/231 | 89,6% | 0.162 | 245 ms |
Phép so sánh của Amazon chỉ đúng khi gắn nhãn ticket 20 loại
Nếu chỉ đọc tiêu đề thì dễ tưởng đây là trận thắng tuyệt đối của model nhỏ trước model lớn, nhưng tuổi của Sonnet 4.6 và bản chất hẹp của việc gắn nhãn ticket kể một câu chuyện khác hẳn.
Sonnet 4.6 ra tháng 02/2026 và đã bị Sonnet 5 thay thế từ 30/06/2026
Sonnet 4.6 phát hành tháng 02/2026, đa số nguồn ghi 17/02/2026, có nguồn ghi 15/02/2026, nên bài này ghi tháng 02/2026, context 1 triệu token đang beta, giá 3 USD input và 15 USD output mỗi triệu token. Đến 30/06/2026 thì Sonnet 5 ra mắt, thay thế Sonnet 4.6 làm model Sonnet được khuyên dùng và mặc định trên Free và Pro, đạt 63,2% SWE-bench Pro so với 58,1% của Sonnet 4.6, giá khởi điểm 2 USD và 10 USD. Bài gốc tự gọi Sonnet 4.6 là model 9 tháng tuổi, sznio hỏi vì sao không nâng cấp lên Sonnet mới hơn, Zanfa đoán có thể do thiếu hỗ trợ batch API, chỉ là đoán của cộng đồng, chưa có xác nhận từ Amazon. Mình thấy câu hỏi này của sznio là đúng chỗ, vì nó phá vỡ ấn tượng đây là trận thắng trước model mới nhất.
Việc gắn nhãn 20 loại lặp đi lặp lại, đúng đất cho decision model thắng
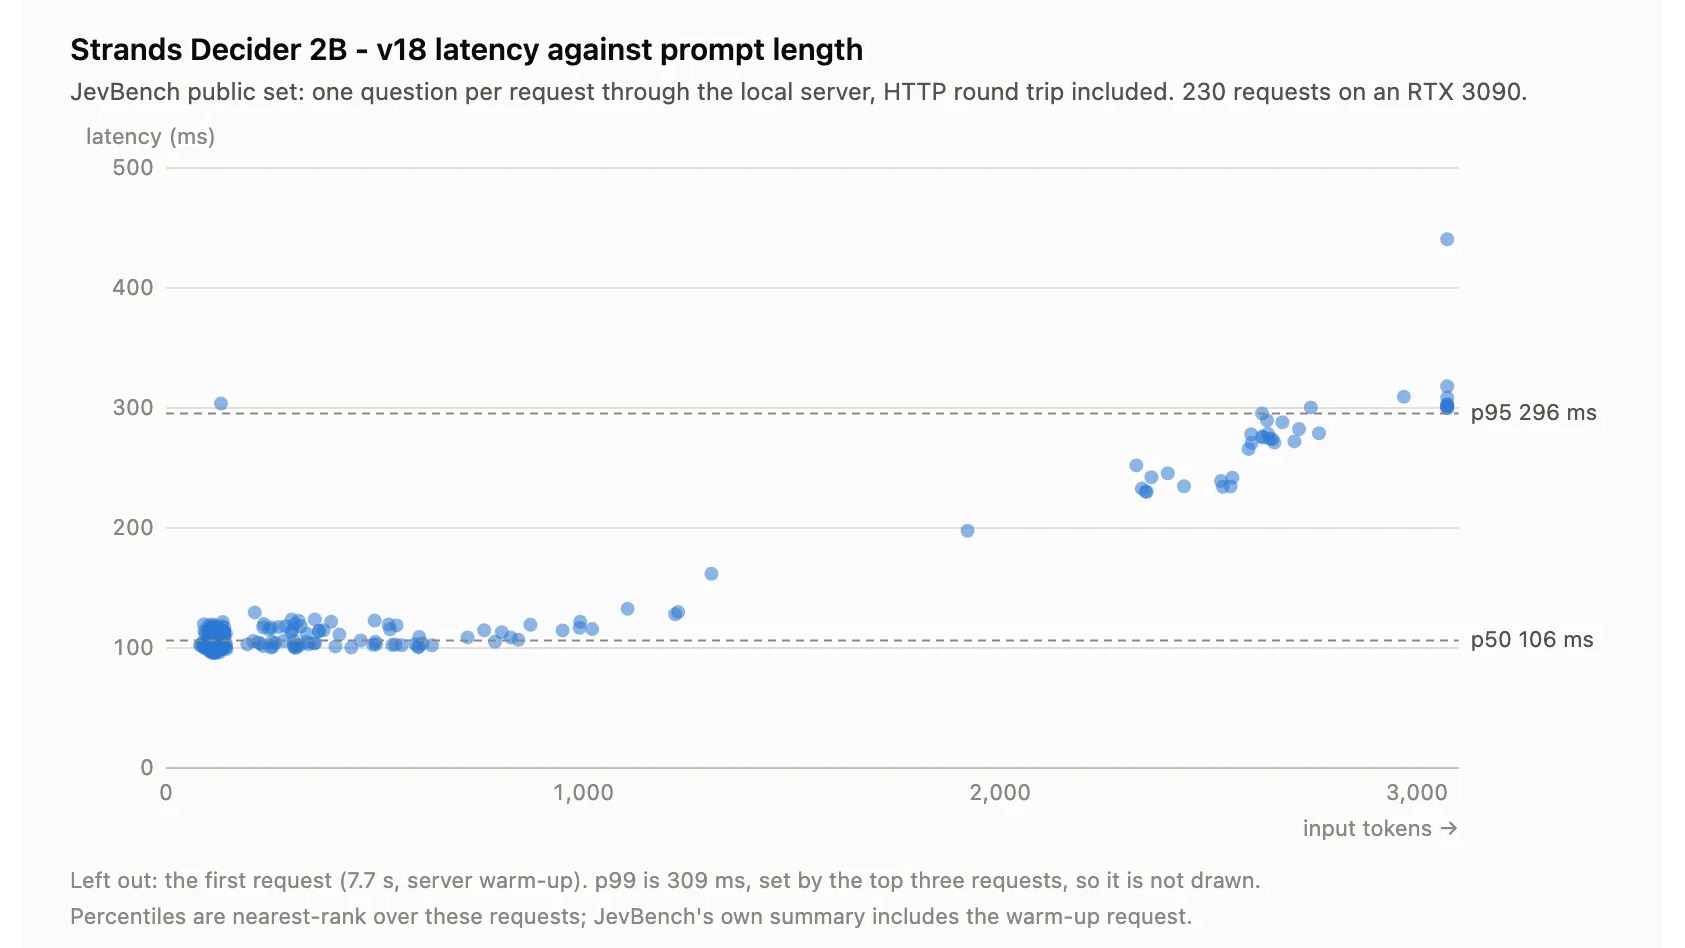
Nhiệm vụ này là lựa chọn trong một danh mục cố định, khối lượng lớn, độ trễ quan trọng, không cần giải thích bằng text, danh mục ổn định, bối cảnh nhét vừa vài nghìn token, đúng ba điều kiện bài gốc tự nêu để decision model thay được LLM. Giới hạn tự nhận trong bài gốc cũng nói rõ, nhãn cần giải thích bằng text, danh mục thay đổi hàng tuần, hoặc không nhét đủ bối cảnh vào vài nghìn token thì decision model không thay được LLM. Độ trễ địa phương của Decider 2B thì median khoảng 115 ms mỗi câu hỏi trên RTX 3090, p95 299 ms, khoảng 153 ms cho tác vụ nhỏ trên MacBook M3 Pro, trên CPU thì câu hỏi 256 token mất 3,5 giây. Anh em ở Việt Nam thì cứ hình dung việc phân loại đơn hàng, ticket hỗ trợ, CRM, lặp lại hàng nghìn lần mỗi ngày, đó chính là đất cho decision model.
Decision model bùng nổ thành danh mục mới từ Jev ngày 15/09/2026 đến 09/10/2026
Chỉ trong chưa đầy một tháng, Jev của TypeSafe AI ra 15/09/2026, Laya ra 18/09/2026, OpenAI giới thiệu Decisions API tại DevDay 29/09/2026, Decider 2B của AWS, Clef và Clef-flash của Cloudflare cùng decider mở của Perplexity ra 01/10/2026, OpenAI mở Decisions API public beta 06/10/2026, Microsoft ra Microsoft-Decision-1 và TypeSafe huy động 870 triệu USD ở định giá 7,5 tỉ USD, cùng ngày 09/10. OpenRouter lập trang xếp hạng Decision Model riêng, đến 11/10 Jev 1.13 đạt khoảng 1,05 tỉ request, Vercel báo gần 13% paid team dùng Jev trong 24 giờ đầu. Giá để so sánh thì Jev và Microsoft-Decision-1 cùng 0,042 USD cho 1 triệu input token, OpenAI 0,10 USD, Strands Decider miễn phí nếu tự host, chỉ trả tiền máy. Đặt vụ Amazon vào xu hướng lớn hơn thì đây là bằng chứng thực tế đầu tiên ở quy mô lớn cho thấy danh mục này không chỉ là demo, và anh em có thể đọc thêm bài về Muse Ember, model rẻ nhất của Meta dành cho agent.
Hacker News tranh luận hai phía về Amazon thay Sonnet bằng Decider
Phần hay nhất của vụ này không nằm trong blog của AWS mà nằm ở thread Hacker News, nơi 197 bình luận mổ xẻ cả hai phía, từ nghi ngờ quảng cáo đến kinh nghiệm seed nhãn bằng LLM rồi thay bằng classifier. Phần này mới hay.
Phe nghi ngờ cho rằng bài gốc AWS tự khen mình, giá list 3 USD khác giá Amazon thực trả
Thread Hacker News item 50436640, người đăng aloukissas, link về blog Strands, lúc khoảng 23:25 giờ VN ngày 10/11/2026 đạt 552 điểm và 197 bình luận, lên front page, chỉ có một bản tin tổng hợp AI Daily đăng lại, không báo chí lớn nào đưa tin riêng. Nhóm nghi ngờ quảng cáo thì swiftcoder viết thẳng đây là quảng cáo, oofbey hiểu sai, tưởng Strands là startup bên ngoài đang thu 2% của hàng triệu USD, rồi mcintyre1994 sửa lại Strands là model mở của chính AWS. coolgoose nghi ngờ giá thị trường 3 USD cho 1 triệu token của Sonnet 4.6, hàm ý giá list khác giá Amazon thực trả, và mình đồng tình một phần, vì toàn bộ số liệu do AWS tự đo, tự báo trên blog của chính mình. Đây là chi phí nội bộ chuyển từ Bedrock sang hạ tầng tự vận hành, tiền vẫn nằm trong hệ thống của Amazon.
Phe classifier truyền thống nói dùng LLM làm classifier là lãng phí
armcat viết không có lý do gì để dùng LLM làm classifier, chỉ có dân hype không có kiến thức kỹ thuật mới đẩy việc này dù nó chậm hơn và đắt hơn 1000 lần, đây là ý kiến cá nhân của một commenter, Amazon hay AWS chưa từng nói vậy. floro bổ sung xây SVM không khó nhưng cần data scientist và tập dữ liệu gắn nhãn cẩn thận, IanCal nói SVM với TF-IDF rất nhanh nhưng đôi khi phân loại rất tệ theo cách mà hệ thống đó không sửa được. Bằng chứng lịch sử thì dự án Linnaeus, arxiv 2103.06927, pipeline phân loại log bằng SVM, train mất vài phút, phân loại mất vài mili giây, làm việc tương tự từ 6 năm trước. Phe này đúng về hiệu năng dài hạn, classifier chuyên dụng chạy việc lặp lại vừa nhanh vừa rẻ hơn LLM rất nhiều, nhưng sai về chi phí khởi động, vì nhiều team lúc bắt đầu không có dataset gắn nhãn lẫn data scientist.
Phe thực dụng nói LLM khởi động nhanh rồi distill thành classifier chuyên dụng
wodenokoto nói có thể dùng LLM khởi động giải pháp phân loại trong khoảng 5 phút mà vẫn làm khá tốt, còn cryptonym tóm tắt chạy đắt hơn 1000 lần vẫn có thể rẻ hơn tổng thể vì tránh chi phí train và tuning ban đầu, tất cả tùy thuộc quy mô.
Nhóm đề xuất quy trình hybrid thì miki123211 kể đã gắn nhãn tay rất nhiều dataset chỉ để xây PoC, sẽ giao việc đó cho LLM rồi fine-tune kết quả, không muốn LLM nằm trong vòng lặp inference cho thứ classifier đơn giản làm được. Cùng người này giải thích transfer learning là dùng nhãn chất lượng cao từ prompt của LLM để distill thành dataset fine-tune cho model nhỏ hơn nhiều, và ctxc đề xuất route vấn đề đã biết cho classifier đơn giản trong nhà, vấn đề confidence thấp đẩy cho model kiểu Jev hoặc LLM. Mình đồng tình đây là lập trường đúng nhất cho độc giả thực tế, Amazon vừa đi đúng quy trình này, dùng LLM khởi động, có đủ nhãn thật rồi thay bằng decision model thay vì SVM, và hai phe không mâu thuẫn nhau, vì model lớn tạo nhãn để train model nhỏ, model nhỏ chạy việc lặp lại rẻ hơn.
Bốn điểm cần đọc kỹ trước khi tin con số 98% của Amazon
Trước khi qua phần làm theo ngay, anh em cần giữ lại bốn điểm này trong đầu, vì chúng không làm con số 98% sai phép tính mà làm rõ phạm vi đúng của nó.
Số liệu Amazon tự đo tự báo trên blog AWS, một nguồn duy nhất chưa kiểm chứng độc lập
Toàn bộ số liệu về vụ Amazon là Amazon tự đo, tự báo trên blog của chính AWS, một nguồn gốc duy nhất, chưa có kiểm chứng độc lập, không có bên thứ ba nào đo lại, chỉ có một bản tin tổng hợp AI Daily đăng lại. Stackness, FactualMinds, VentureBeat đều giữ chuẩn mực này, mọi con số JevBench phải ghi kèm tên checkpoint, cửa sổ token và máy đo.
Sonnet 4.6 đã cũ, đã bị Sonnet 5 thay thế từ 30/06/2026
Sonnet 4.6 là model tháng 02/2026, đã bị Claude Sonnet 5 thay thế từ 30/06/2026, nên phép so sánh này chỉ đúng với một model đã 9 tháng tuổi. Câu hỏi vì sao không nâng cấp lên Sonnet 5 trước thì chỉ có câu trả lời đoán về batch API, chưa có xác nhận từ Amazon. Anh em muốn xem dòng Claude đã đi xa tới đâu thì nghía qua bài về Claude Fable 5.2, model Claude mới nhất vừa ra mắt, còn bối cảnh hãng này đang được định giá ra sao thì có trong bài về Anthropic IPO với giá 70 đến 78 USD mỗi cổ phiếu.
Tiết kiệm hàng triệu USD không có số tuyệt đối vì thiếu tổng ticket mỗi năm
Bài gốc chỉ viết will save millions of dollars of token costs in a year, không công bố tổng số ticket mỗi năm hay tổng chi phí trước và sau, nên cụm hàng triệu USD là ước tính nội bộ, không kiểm chứng được từ bên ngoài. Cũng thiếu số tuyệt đối ở kết quả chính xác, E4B beating production Sonnet không kèm con số accuracy tuyệt đối nào trên ticket thật, chỉ nói vượt trên một tập ticket riêng biệt sau khi tinh chỉnh ngưỡng confidence.
Giảm 98% chi phí chỉ đúng khi chọn đáp án trong danh mục cố định
Decision model với LLM là hai lớp model khác bản chất nhiệm vụ, một bên chỉ chọn đáp án, một bên sinh text tự do, nên giảm 98% chi phí chỉ có nghĩa Decider rẻ hơn rất nhiều cho đúng việc chọn đáp án trong danh mục cố định. Giá list 3 USD và 15 USD cùng giá 1,408 USD mỗi giờ đều là giá công khai, khác giá Amazon thực trả, chi phí vận hành trọn gói chưa tính hết, mà model lớn với model nhỏ cũng không mâu thuẫn nhau, model lớn tạo nhãn để train model nhỏ, model nhỏ chạy việc lặp lại rẻ hơn.
Team nhỏ áp dụng mô hình Amazon và thử Strands Decider E4B ngay hôm nay
Số liệu bóc tách xong rồi, giờ đến phần đáng tiền nhất cho anh em làm hệ thống, vì Amazon để lại cả một mẫu chuyển đổi an toàn và một checkpoint mở miễn phí, nên đọc xong là thử được ngay. Đáng thử thật.
Quy trình 2 giai đoạn LLM seed nhãn rồi thay bằng decision model khi đủ quy mô
Quy trình này được cả hai phe Hacker News thừa nhận, dùng LLM khởi động nhanh và sinh nhãn chất lượng cao, rồi distill thành classifier chuyên dụng khi đủ quy mô, Amazon vừa đi đúng bước thứ hai, nhưng bằng decision model thay vì SVM. Điều kiện để thay được LLM bằng decision model thì bài gốc nêu rất rõ, danh mục cố định và ổn định, khối lượng lớn và lặp lại, độ trễ và chi phí quan trọng, đã có đủ nhãn thật từ giai đoạn LLM, không cần giải thích bằng text. Khi nào nhất định không nên thay thì cũng rõ không kém, nhãn cần giải thích bằng text, danh mục thay đổi hàng tuần, không nhét đủ bối cảnh vào vài nghìn token, khối lượng thấp chưa bù được chi phí train và tuning. Mô hình 3 tầng đề xuất từ miki123211 và ctxc thì rất dễ áp vào việc thật, rule cho vấn đề đã biết, decision model cho vấn đề thường gặp, LLM cho trường hợp khó hoặc confidence thấp.
Công tắc 3 chiều BEDROCK DUAL DECIDER và cách revert trong 45 giây của Amazon
Team Amazon không tắt Sonnet ngay mà dùng công tắc 3 chiều trong AppConfig, BEDROCK chỉ dùng Sonnet gắn nhãn, DUAL chạy song song cả hai để so sánh trên lưu lượng thật, DECIDER chỉ dùng Decider gắn nhãn, ở chế độ DUAL thì hệ thống gọi cả hai song song và lấy kết quả Sonnet áp lên ticket để so sánh. Chạy song song rồi xét từng trường hợp bất đồng cho biết nhiều hơn eval offline, và quay lui chỉ là thay đổi config 45 giây, đây là mô hình chuyển đổi an toàn áp dụng được cho mọi lần thay model trong hệ thống đang chạy.
Thử Strands Decider E4B ngay hôm nay với pip install và checkpoint trên Hugging Face
Cách cài theo bài gốc là pip install strands-decider, gọi lệnh strands-decider ask với state và choice, ví dụ trong bài gốc chọn team billing với confidence 0.768, checkpoint dùng trong vụ Amazon là strands-decider-E4B-gemma4-v1-2610, trên nền google/gemma-4-E4B-it, tải trên Hugging Face. Chạy như local HTTP server POST /v1/systemone, cổng 8099 trong ví dụ, chạy được trên CUDA, Apple MPS, MLX hoặc CPU, không có GGUF chính thức, llama.cpp gốc không chạy được bản GGUF cộng đồng, server không có xác thực nên chỉ nên chạy trên 127.0.0.1, phần này mình ghi theo tài liệu chính thức, chưa thử tận tay trên mọi phần cứng.
Phần cứng tham khảo từ vụ Amazon là SageMaker ml.g5.xlarge 1,408 USD mỗi giờ, 1 GPU A10G 24 GB mỗi instance, model dùng khoảng 19 GiB, một request khoảng 640 ms, còn local thì median khoảng 115 ms mỗi câu hỏi trên RTX 3090, p95 299 ms, và không có hosted API, chỉ có model mở để tải về. Tích hợp agent tham khảo thì Strands Agents SDK có intervention API với các action Proceed, Deny, Guide, Confirm, Transform, ngưỡng 0.45 trong ví dụ chỉ là con số chọn tay để minh họa.
Ba cái bẫy khi thử Decider E4B, từ context 4.096 token tới cutoff confidence
Cái bẫy 1 là context 4.096 token, mô tả nhãn production dài hơn cửa sổ này nên team Amazon phải viết lại 20 nhãn thành tiêu chí 1 đến 2 câu, anh em chuẩn bị nhãn thì viết ngắn ngay từ đầu. Cái bẫy 2 là nhạy cảm thứ tự lựa chọn, thứ tự key trong JSON làm xác suất đầu ra lệch tối đa 0,19 với cùng nội dung, team Amazon sắp xếp key trước khi gửi mỗi request, một commenter Hacker News đổi thứ tự thì billing rơi từ 0,843 xuống 0,470, nên anh em cố định thứ tự lựa chọn rồi mới đo. Cái bẫy 3 là cutoff confidence, cutoff 0.9 từ band Qwen v19 không dùng cho Gemma, ngưỡng 0.45 trong ví dụ intervention API chỉ là con số chọn tay để minh họa, nên anh em đừng lấy 0.9 hay 0.45 làm chuẩn cứng, mà tự tinh chỉnh ngưỡng trên tập nhãn của chính mình, và kiểm tra license trước khi fine-tune cho sản phẩm.
Amazon tiết kiệm 98% chi phí gắn nhãn ticket, team nhỏ học được cách thay model
Con số 98% có thật trong phạm vi của nó, nhưng giá trị lâu dài của vụ này nằm ở cách Amazon thay model, từ LLM khởi động nhanh đến decision model chạy việc lặp lại, và cách đó thì team nhỏ nào cũng làm theo được ngay hôm nay. Ba con số cốt lõi là chi phí từ khoảng 22.200 USD xuống khoảng 500 USD mỗi triệu ticket, thời gian từ 4.215 ms xuống 897 ms, token từ 6.724 xuống 2.010, kèm bốn điểm cần giữ trong đầu là một nguồn duy nhất, Sonnet 4.6 đã cũ, hàng triệu USD không có số tuyệt đối, và so sánh táo với cam. Tin có chừng mực thôi.
Làm theo ngay: bắt đầu bằng LLM để seed nhãn trong 5 đến 10 phút khi chưa có dataset, thử Strands Decider E4B bằng pip install strands-decider và checkpoint strands-decider-E4B-gemma4-v1-2610, áp mô hình 3 tầng rule, decision model, LLM, chuyển đổi bằng công tắc 3 chiều BEDROCK, DUAL, DECIDER và giữ khả năng revert trong 45 giây. Khi thử thì anh em nhớ chia sẻ trải nghiệm thật khi chạy Decider trên tập nhãn của chính mình, vì chỉ tập nhãn của chính bạn mới trả lời được Decider có chính xác hơn LLM trên việc của bạn không.
Nguồn tham khảo
- Blog Strands Agents về vụ Amazon thay Sonnet bằng Decider: https://strandsagents.com/blog/amazon-saves-millions-replacing-sonnet-with-strands-decider/
- Blog Strands Agents giới thiệu Strands Decider: https://strandsagents.com/blog/introducing-strands-decider/
- Hacker News, thread về vụ Amazon thay Sonnet bằng Decider: https://news.ycombinator.com/item?id=50436640
- Stackness phân tích Strands Decider 2B: https://stackness.dev/blog/strands-decider-2b-what-it-is-and-where-it-sits-in-an-agent-harness
- FactualMinds so sánh Strands Decider 2B với Jev: https://www.factualminds.com/blog/strands-decider-2b-vs-jev-2026/
- PyPI gói strands-decider: https://pypi.org/project/strands-decider/
- Bài về Claude Sonnet 4.6: https://evermx.com/case/claude-sonnet-4-6-1m-context-coding-computer-use
- Bài về Claude Sonnet 5: https://claudefa.st/blog/models/claude-sonnet-5
- 5thDev về decision model sau Jev: https://www.5thdev.ai/blog/decisions-are-becoming-data
- Kai Waehner về decision model thành danh mục mới: https://www.kai-waehner.de/blog/2026/10/20/how-decision-models-became-a-new-ai-category-after-jev/
- Aliteq chạy Gemma 4 local: https://aliteq.com/run-gemma-4-locally
- Dev.to về giá SageMaker: https://dev.to/cloudwiseteam/how-sagemaker-actually-bills-a-breakdown-for-engineers-1cb7

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- DeepMind dùng AlphaProof Code chứng minh toán học mã hóa Signal trong 4 tuần
- Anthropic chốt khoảng giá IPO 70-78 USD, chào bán 825 triệu cổ phiếu, placement 26 tỷ USD từ Google và NVIDIA
- Fireworks AI lộ billing và weights chưa hoàn chỉnh, Notion xác nhận dưới 1% workspace có thể bị ảnh hưởng
Bình luận & Trao đổi