📑 Mục lục chi tiết bài viết (27 mục)
- Muse Ember là model muse-ember-1.0 ra mắt 09/11/2026 với giá 0,10 USD input
- Ember đứng ở đâu trong đội hình Muse gồm Wonder, Spark và Glimmer
- Giá niêm yết 0,10 USD input và chi phí 0,14 USD cho mỗi task benchmark
- Context 1.048.576 token, output 524.288 token và 6 nấc reasoning effort của Ember
- Việc agent nào nên giao cho Muse Ember, việc nào giữ lại cho model lớn
- Tool call, routing, trích xuất và đọc tài liệu dài là việc hợp nhất với Muse Ember
- Code thật cần merge và hỏi đáp kiến thức từ trí nhớ là việc đừng giao cho Muse Ember
- Activepieces chạy thử 3 task qua OpenRouter, Ember đúng cả 3 nhưng chậm hơn GPT-5.4-mini
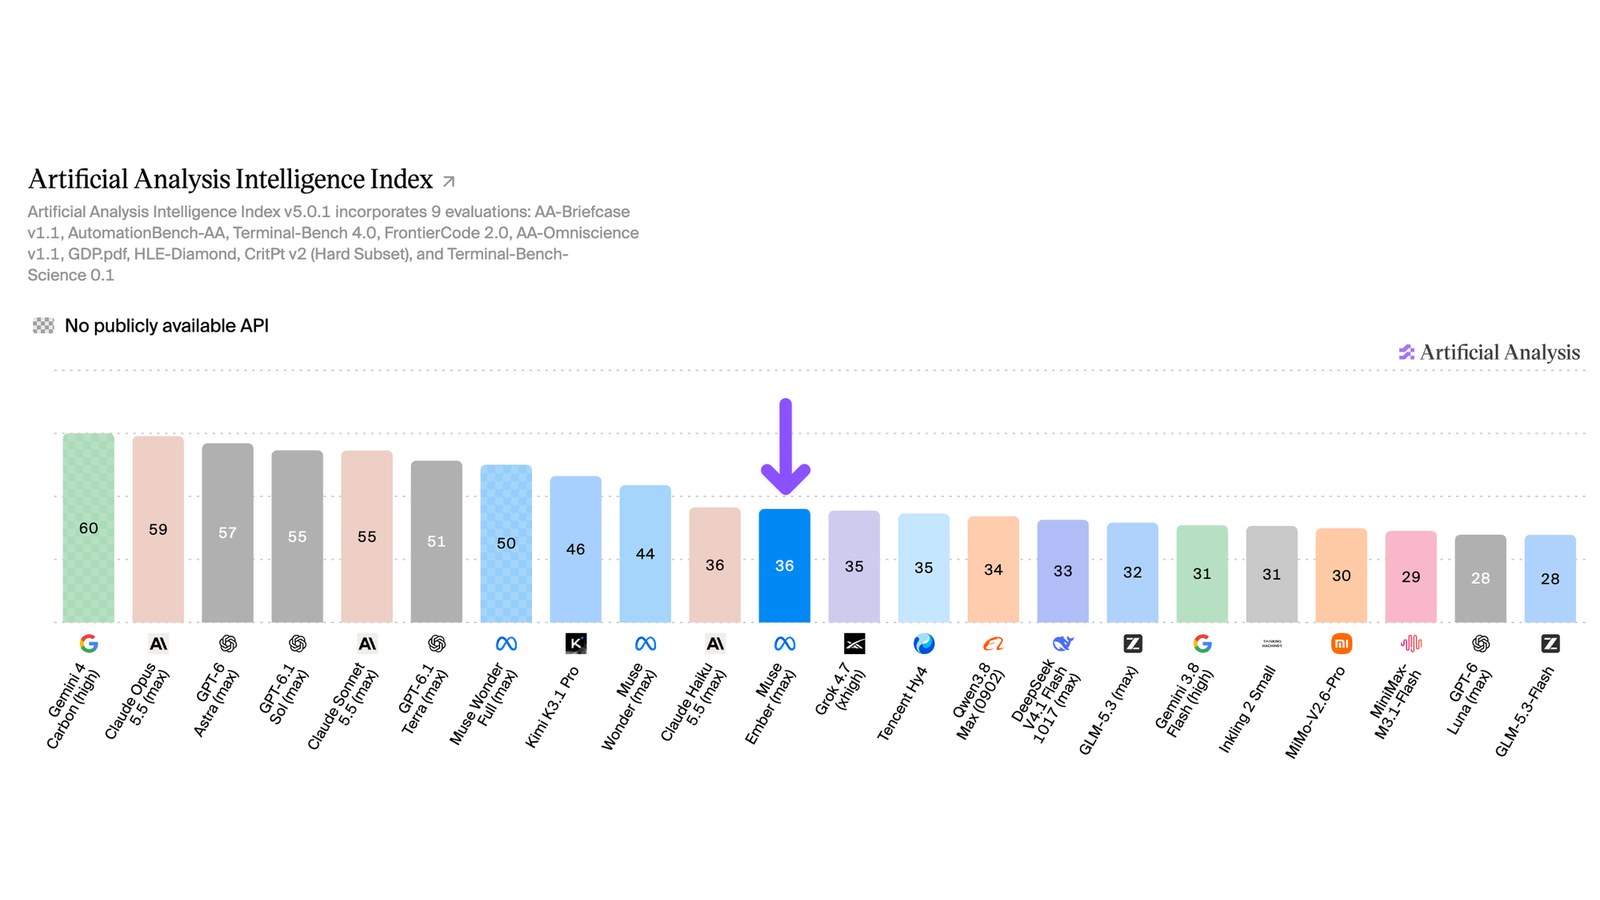
- Muse Ember đấu Claude Haiku 5.5 và GPT-6 Luna trên Intelligence Index 36 điểm
- Intelligence Index 36 điểm của Ember, Haiku 5.5 và GPT-6 Luna khác nhau ở bảng thành phần
- AutomationBench 37,8% hay 68,1%, hai con số cùng ngày trả lời hai câu hỏi khác nhau
- Giá token y hệt nhau, Ember rẻ hơn ở chi phí mỗi task và ở nấc reasoning xhigh
- Muse Ember thua rõ ở AA-Omniscience 21,1% và FrontierCode 27,2%
- AA-Omniscience 21,1% và tỉ lệ từ chối 64% câu hỏi kiến thức của Muse Ember
- FrontierCode 27,2% của Muse Ember so với Haiku 34,9% và AA-Briefcase Elo 1521 so với 1574
- Cộng đồng nghi ngờ benchmark hãng tự chọn và việc Ember không mở weights
- Thử Muse Ember ngay bằng Meta Model API, Muse Code và OpenRouter
- Gọi Muse Ember qua Meta Model API với model muse-ember-1.0
- Đổi sang Muse Ember trong Muse Code bằng lệnh /model muse-ember-1.0
- Thử Muse Ember qua OpenRouter với slug meta/muse-ember và số liệu throughput, latency, availability lúc mình đọc
- Bẫy giá 200.000 token và 4 nhầm lẫn về Muse Ember trước khi đổi model
- Ngưỡng 200.000 token input làm giá tăng gấp 3 cho toàn bộ request
- Không có weights, không chạy local, không fine-tune Muse Ember
- Contributor mode trong Muse Code và nhầm lẫn gói Maximum 100 USD với Maximum Usage 200 USD
- Đừng nhầm Muse Ember với tin Muse lên đồng hồ cùng tuần
- Nên dùng Muse Ember ngay cho việc có giới hạn, chờ kiểm chứng trước khi đưa vào production
- Nguồn tham khảo
Meta công bố Muse Ember ngày 09/11/2026 với giá 0,10 USD input và 0,50 USD output mỗi triệu token, còn Artificial Analysis ước tính mỗi task benchmark chỉ tốn khoảng 0,14 USD, so với 0,41 USD của Claude Haiku 5.5. Vậy đổi sang Ember thì hóa đơn tháng sau giảm bao nhiêu, và anh em phải trả giá bằng chất lượng ở chỗ nào?
Muse Ember (
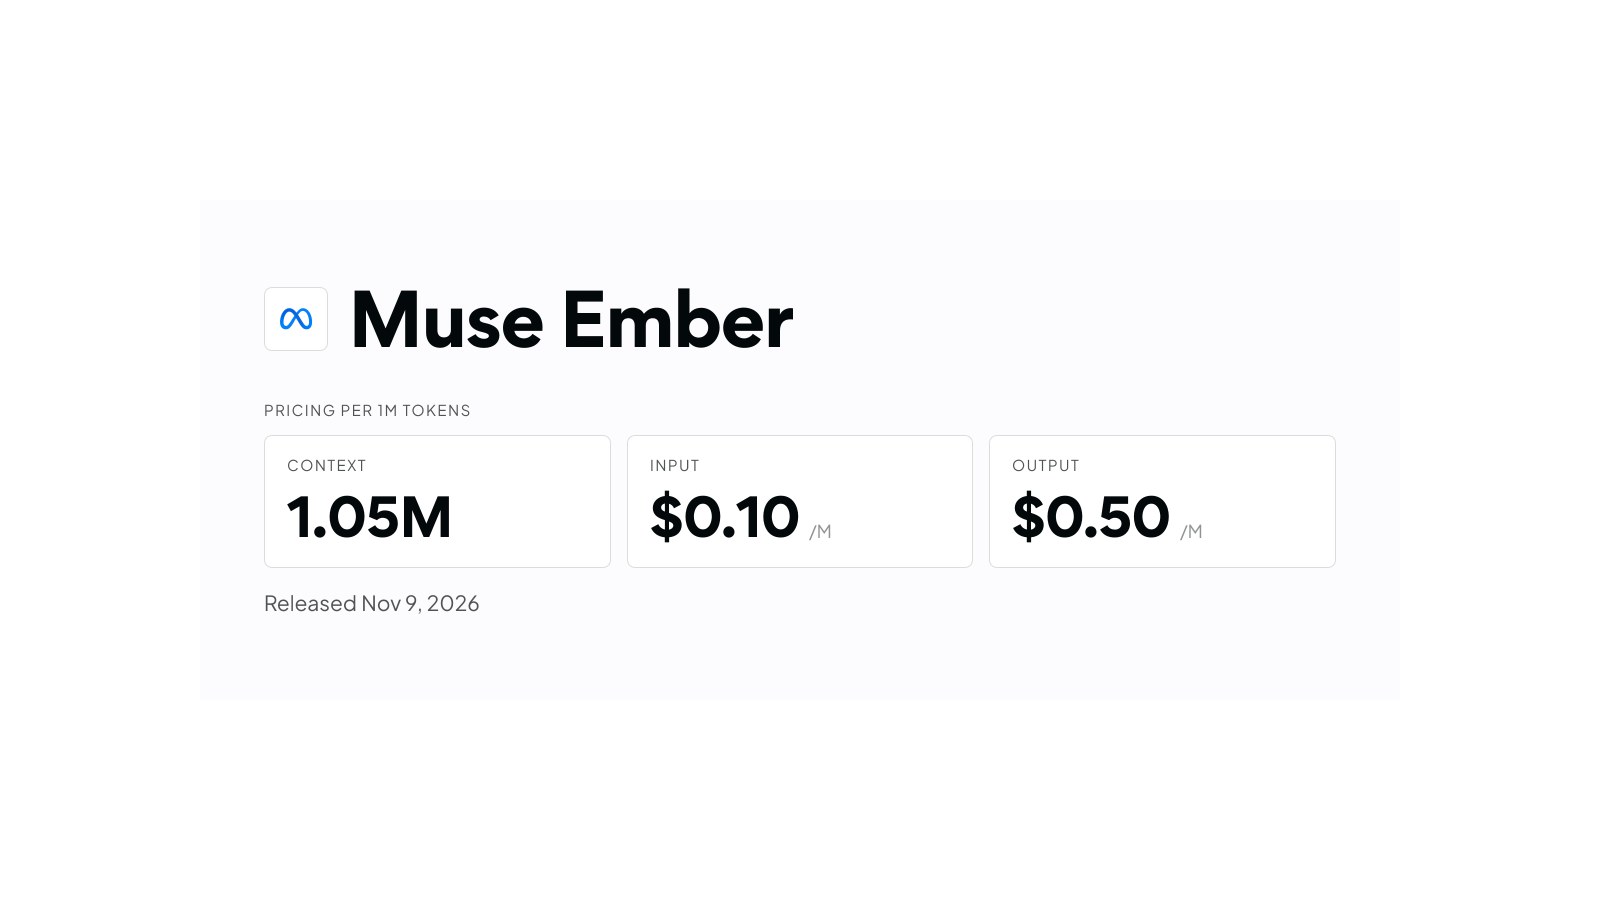
muse-ember-1.0), ra mắt 09/11/2026. Giá tới 200.000 token input: 0,10 USD input / 0,004 USD cached input / 0,50 USD output mỗi triệu token. Context 1.048.576 token, output tối đa 524.288 token. Chi phí ước tính 0,14 USD/task benchmark, so với Haiku 5.5 là 0,41 USD. Chưa có bản miễn phí cho người dùng cuối, dùng qua Meta Model API, Muse Code hoặc OpenRouter.
Muse Ember là model muse-ember-1.0 ra mắt 09/11/2026 với giá 0,10 USD input
Meta gọi Ember là model nhỏ nhất dòng Muse, Wonder lo bài khó nhất, Ember lo task lặp lại ở quy mô lớn.
Ember đứng ở đâu trong đội hình Muse gồm Wonder, Spark và Glimmer
Ember là model thứ 4 dòng Muse, sau Spark tháng 4/2026, Glimmer tháng 8/2026 và Wonder ngày 12/10/2026. Đây là model đầu tiên được train bằng Muse Wonder Full. Spark lo coding và agentic workflow, còn Ember lo task lặp lại ở quy mô lớn. Mình đọc blog Meta thì thấy Ember có mặt ngay ngày ra mắt trên Meta Model API, Muse Code, OpenRouter, Google Cloud và Oracle Cloud. Trước đó Meta đã đưa Active Memory và Active Focus từ Muse Wonder xuống mọi người dùng, mình đã viết trong bài về Active Memory và Active Focus từ Muse Wonder.
Giá niêm yết 0,10 USD input và chi phí 0,14 USD cho mỗi task benchmark
Giá tới 200.000 token input là 0,10 USD input, 0,004 USD cached input và 0,50 USD output mỗi triệu token. Chi phí ước tính là 0,136 USD một task, làm tròn 0,14 USD. Haiku 5.5 tốn 0,411 USD một task, Luna tốn 0,152 USD ở mức max. Ember rẻ ở chi phí mỗi task vì cache read rẻ hơn 60% và nó chỉ dùng khoảng một phần ba output token của Haiku. Nhớ đây là con số benchmark, chưa phải hóa đơn thật.
Context 1.048.576 token, output 524.288 token và 6 nấc reasoning effort của Ember
Context của Ember là 1.048.576 token, output tối đa 524.288 token, gấp 4 lần mức trần 128K của Haiku và Luna. Ember nhận text, image, audio, video và PDF, trả ra text, hỗ trợ tool calling, structured output qua JSON schema và Responses API. Có 6 nấc reasoning effort là minimal, low, medium, high, xhigh và max, mặc định là max, còn none thì không hỗ trợ và sẽ trả HTTP 400. Reasoning token tính vào ngân sách output và tính tiền như output token. Dùng Ember mà không chỉnh gì là chạy ở mức tốn kém nhất.
Việc agent nào nên giao cho Muse Ember, việc nào giữ lại cho model lớn
Điểm tổng 36 trên Intelligence Index nghe như Ember làm được mọi việc ngang Haiku, nhưng bóc từng bảng thành phần thì lệch hẳn.
Tool call, routing, trích xuất và đọc tài liệu dài là việc hợp nhất với Muse Ember
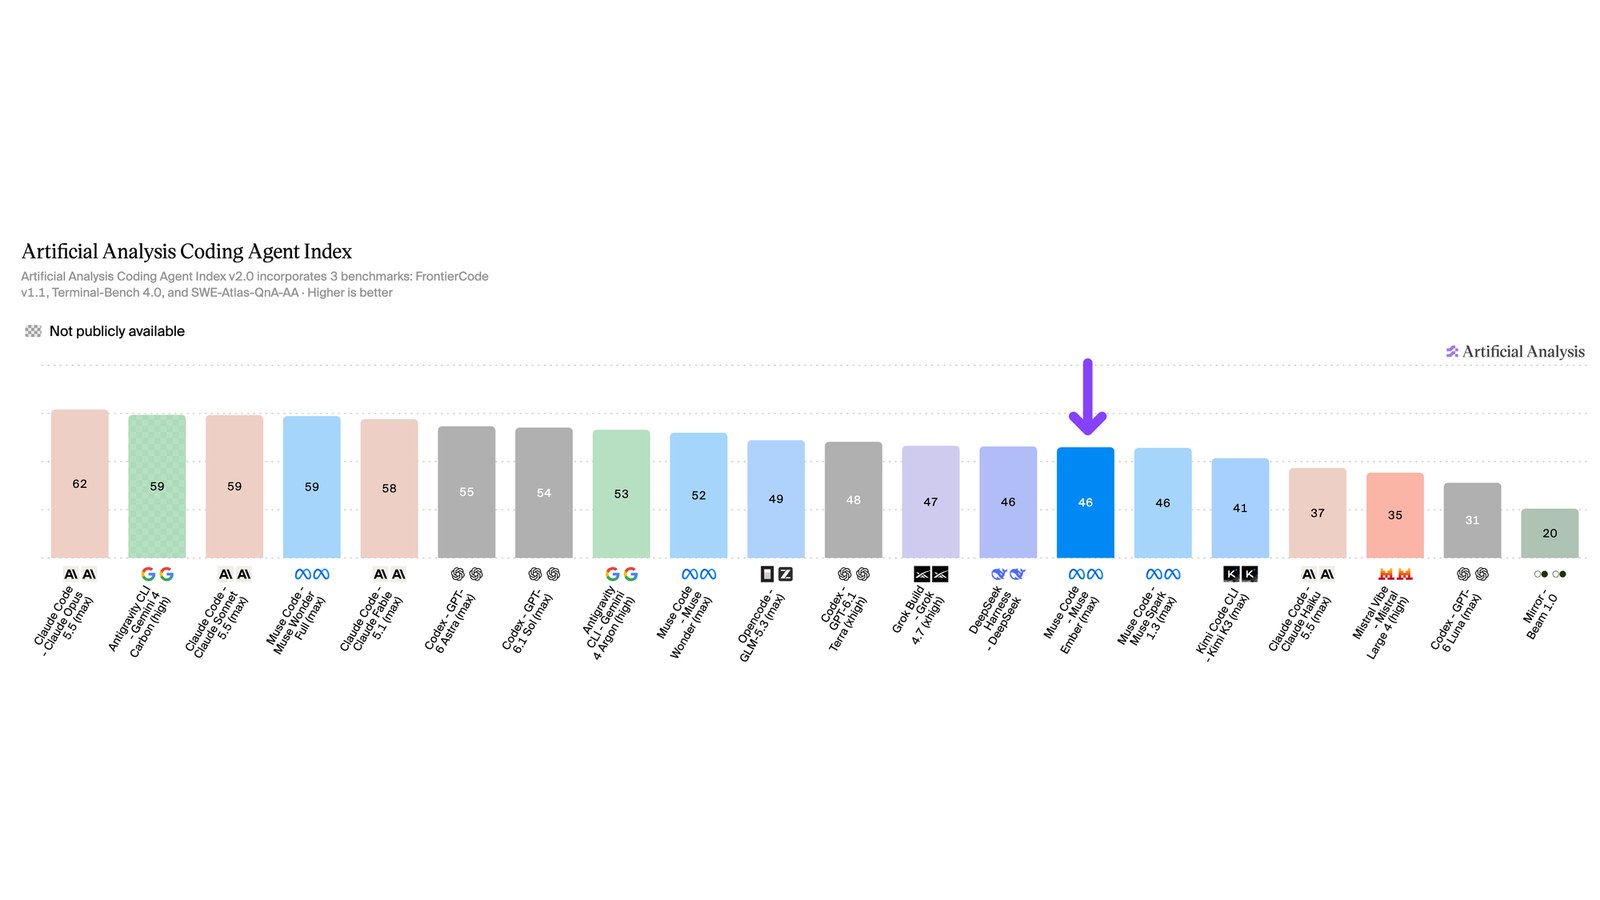
Ember hợp nhất với tool call, routing, trích xuất, đọc tài liệu dài, subtask code có khuôn mẫu và workflow kinh doanh lặp lại. Bằng chứng là AutomationBench đạt 37,8%, trong khi Haiku chỉ 13,9% và Luna 20,2% ở thước strict pass@1. Terminal-Bench đạt 40,9%, và con số này giữ nguyên ở cả harness của Meta lẫn harness riêng của Artificial Analysis.
Đối tác Box kể Ember chấm hợp đồng theo từng điều khoản playbook. Cloudflare thì ghi Ember nhanh hơn tới 30% ở phần đuôi so với model họ đối chiếu, còn You.com hoàn thành mọi coding task với p95 2,2 giây. Nói nôm na như dọn kho theo danh sách có sẵn: món nào đúng ô, đúng mã thì Ember làm nhanh và đều tay. Nhưng đây là tuyên bố đối tác trong bài của Meta, chưa phải test độc lập. Cứ chạy thử trên workload của mình rồi đo lại.
Code thật cần merge và hỏi đáp kiến thức từ trí nhớ là việc đừng giao cho Muse Ember
Đừng giao cho Ember code thật cần merge. FrontierCode 2.0 của Ember chỉ 27,2%, Haiku lên tới 34,9%. Cũng đừng giao hỏi đáp kiến thức từ trí nhớ. AA-Omniscience của Ember chỉ 21,1% và nó từ chối tới 64% câu hỏi. Việc thiếu tiêu chí kiểm tra rõ hay workflow desktop không giám sát thì cũng khoan giao cho Ember. CellCog gọi Ember là người làm việc trên tài liệu và tool được giao, nên trong agent thì từ chối rồi leo thang lên model lớn là hành vi tốt.
Activepieces chạy thử 3 task qua OpenRouter, Ember đúng cả 3 nhưng chậm hơn GPT-5.4-mini
Activepieces chạy ngày 09/11/2026 qua OpenRouter trên 3 task là phân loại ticket, trích trường hóa đơn và tóm tắt email. Ember đúng cả 3 nhưng GPT-5.4-mini nhanh hơn trong mỗi task. Câu hỏi khi đổi model là độ chính xác có đáng để chờ lâu hơn hay không. Đây chỉ là 3 task, 1 lần chạy, không dùng làm kết luận hiệu năng.
Muse Ember đấu Claude Haiku 5.5 và GPT-6 Luna trên Intelligence Index 36 điểm
Giá token niêm yết của cả ba model y hệt nhau, nên câu rẻ hơn của Ember nằm ở số token nó dùng để xong một việc.
Intelligence Index 36 điểm của Ember, Haiku 5.5 và GPT-6 Luna khác nhau ở bảng thành phần
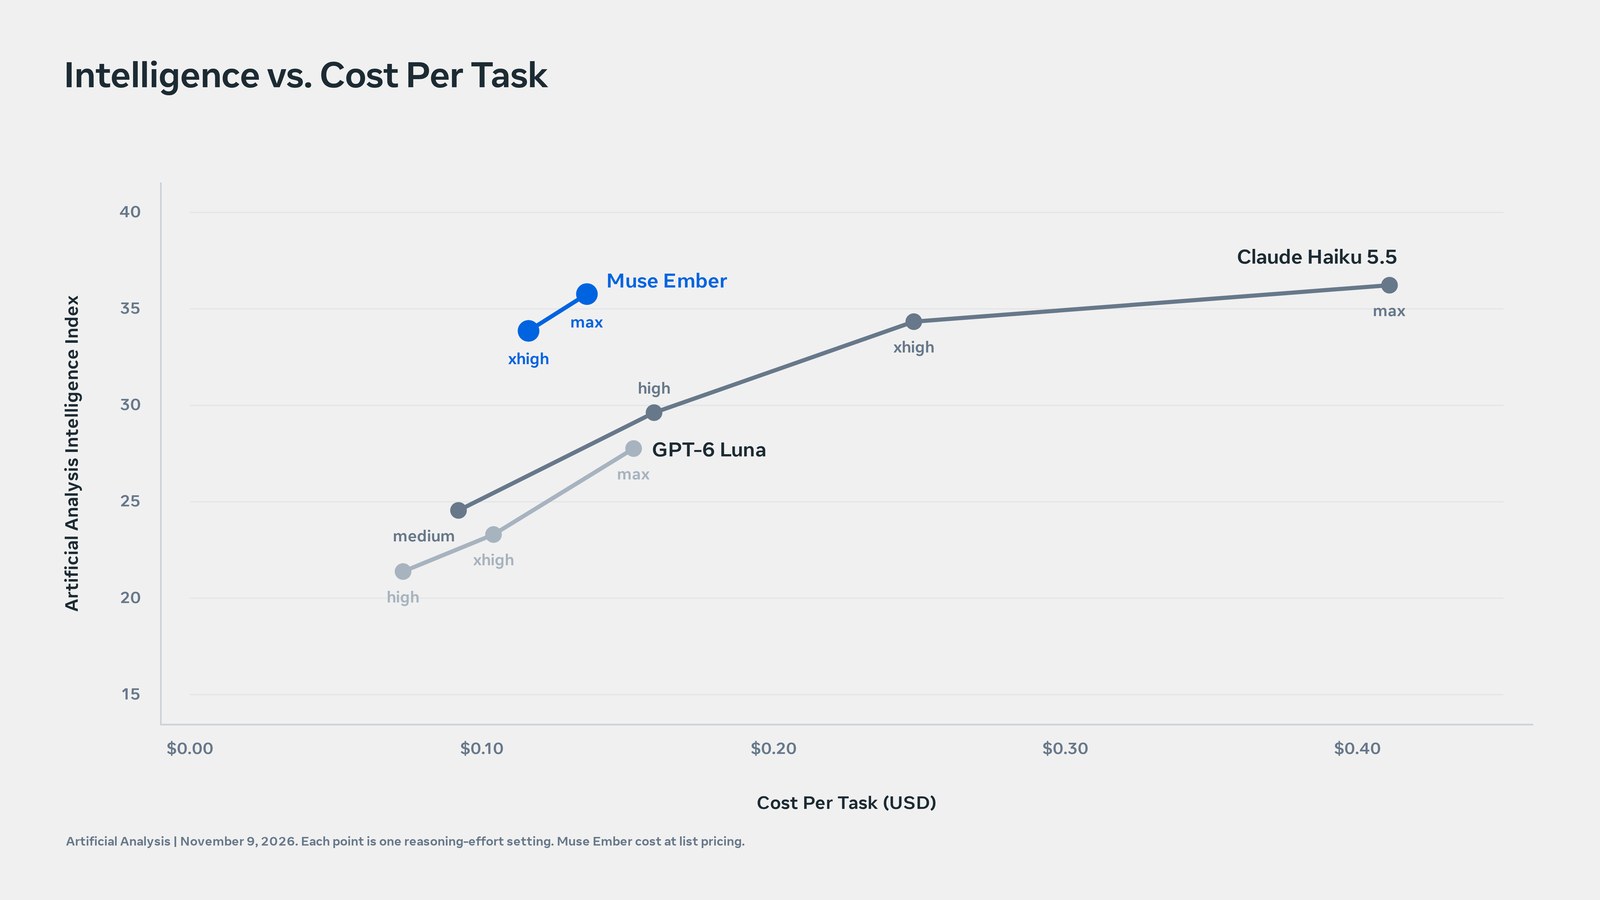
Nhắc lại: đây là số hãng tự đo. Ở Intelligence Index v5, Ember đạt 36 điểm, thực ra 35,8 chưa làm tròn. Haiku 5.5 đạt 36,2 và Luna đạt 27,8. Nhìn điểm tổng thì Ember với Haiku gần như ngang nhau. Mình bóc bảng thành phần thì Ember thắng lớn ở AutomationBench với 37,8% trong khi Haiku chỉ 13,9%. Rồi Ember lại thua ở FrontierCode, 27,2% trước 34,9% của Haiku, và ở AA-Briefcase Elo 1521 trước 1574 của Haiku. Haiku từng 43 điểm trên index v4 cũ nhưng chỉ còn 36 điểm trên v5. Nên không được so điểm khác phiên bản index.
AutomationBench 37,8% hay 68,1%, hai con số cùng ngày trả lời hai câu hỏi khác nhau
Bảng của Meta ghi AutomationBench là 37,8%, thread của Artificial Analysis ghi 68,1%. Mình đối chiếu hai con số này thì thấy chúng trả lời hai câu hỏi khác nhau. Con 37,8% là tỉ lệ hoàn thành trọn vẹn task ở lần thử đầu, tức strict pass@1. Con 68,1% là thước headline tính điểm từng mục tiêu con. Với workflow chỉ tính là xong khi mọi bước hoàn tất thì con 37,8% mới là con liên quan. Lệch tương tự ở Terminal-Bench của Haiku, 39,2% trong bảng Meta so với 32,8% trong harness riêng của Artificial Analysis.
Giá token y hệt nhau, Ember rẻ hơn ở chi phí mỗi task và ở nấc reasoning xhigh
Giá token niêm yết của Ember y hệt Haiku 5.5 và GPT-6 Luna. Ember rẻ hơn ở chi phí mỗi task nhờ cache rẻ và output ngắn. Cụ thể Ember tốn 0,136 USD một task, còn Haiku tốn 0,411 USD và Luna 0,152 USD ở mức max. Ngay cả khi hạ reasoning xuống xhigh, Ember vẫn đạt 33,9 điểm với 0,116 USD một task, thắng cả mức tốt nhất của Luna là 27,8 điểm với 0,152 USD.
Cơ mà bậc giá đối thủ cũng nhảy theo: Haiku tăng lên 0,50/2,50 USD khi prompt trên 100.000 token, còn Luna tăng gấp đôi giá input khi trên 272K token. So sang model mở thì MiMo-V2.6-Flash của Xiaomi chỉ tốn khoảng 0,13 USD một task với 27 điểm và weights giấy phép MIT. DeepSeek V4.1 Flash tốn 0,60 USD một task, còn GLM-5.3-Flash tốn 0,58 USD một task.
Muse Ember thua rõ ở AA-Omniscience 21,1% và FrontierCode 27,2%
Điểm tổng 36 điểm che mất điểm yếu lớn nhất của Ember, phần nhiều bài tin nhanh bỏ qua.
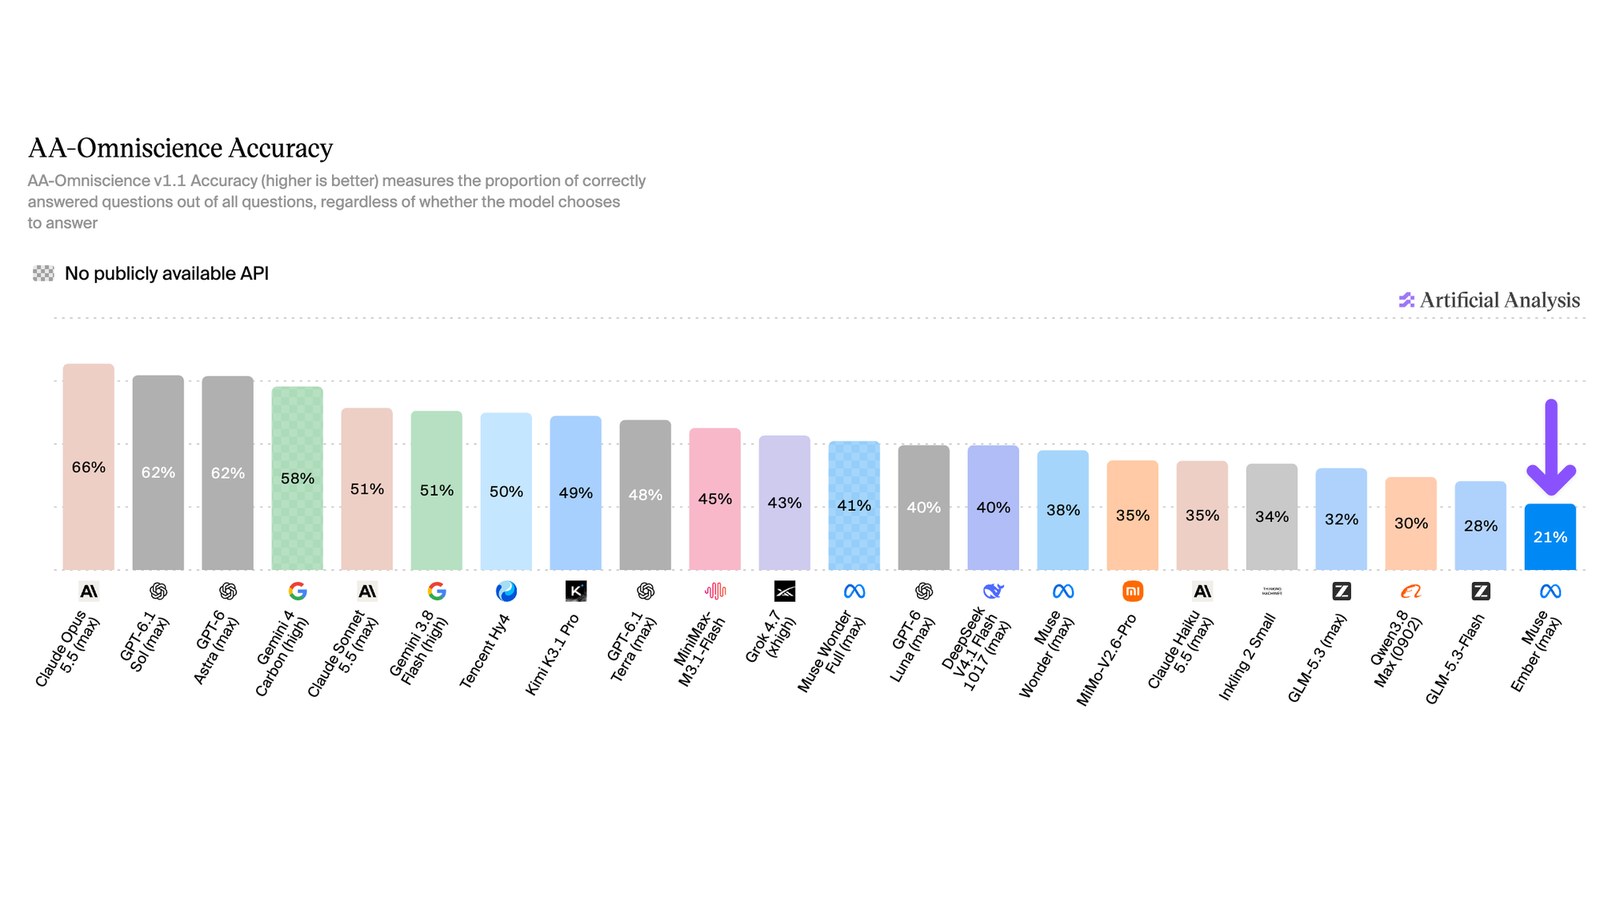
AA-Omniscience 21,1% và tỉ lệ từ chối 64% câu hỏi kiến thức của Muse Ember
Trên AA-Omniscience, Ember chỉ đúng 21,1% câu hỏi kiến thức, thấp nhất nhóm model cùng tầm điểm. Haiku đạt 34,7% và Gemini 3.8 Flash ở mức high đạt 50,5%. Ember từ chối tới 64% câu hỏi. Đổi lại tỉ lệ hallucination chỉ 17,4%. CellCog diễn giải Ember là người làm việc trên tài liệu và tool được giao. Mình thấy workflow leo thang khi gặp trường hợp từ chối lên model lớn sẽ hưởng lợi từ hành vi thận trọng này.
FrontierCode 27,2% của Muse Ember so với Haiku 34,9% và AA-Briefcase Elo 1521 so với 1574
Sang FrontierCode 2.0, Ember chỉ đạt 27,2%, còn Haiku đạt 34,9% và Luna 25,2%. Đây là ngoại lệ duy nhất trong 9 trên 10 bài Meta công bố. AA-Briefcase thì Ember đạt Elo 1521 so với Haiku 1574. OSWorld 2.1 cho thấy điểm binary của Ember chỉ 33,8% so với partial 69,5%. Haiku đạt 27,8% binary và 68,9% partial. Điểm binary thấp nghĩa là nhiều task làm gần xong nhưng chưa xong hẳn. Đừng giao trọn workflow desktop không giám sát cho Ember.
Cộng đồng nghi ngờ benchmark hãng tự chọn và việc Ember không mở weights
Phía Meta và Artificial Analysis thì Ember là model rẻ nhất đạt 36 điểm Intelligence Index. Zuckerberg nói Ember cho intelligence per dollar cao hơn các model cùng hạng. Phía cộng đồng thì khác hẳn. Thread Hacker News 50429024 đạt 263 đến 266 điểm với 111 bình luận, nhiều người nghi ngờ chuyện reasoning càng nhiều thì càng tốt, qua thử vẽ bồ nông đạp xe bằng SVG. Mức minimal với 10 reasoning token cho hình đẹp nhất, còn mức max phải chờ 27 giây.
Reddit r/LocalLLaMA chê Meta hứa open source Muse Spark 1.2 nhưng cứ ra thêm model đóng. Daily.dev tổng hợp phản ứng cộng đồng thì 32% tích cực, 45% lẫn lộn và 23% hoài nghi. Một bình luận trên Hacker News nghi Ember chính là model stealth “crouton alpha” trên OpenRouter.
Thử Muse Ember ngay bằng Meta Model API, Muse Code và OpenRouter
Không có bản miễn phí cho người dùng cuối, nhưng thử Ember không tốn nhiều, một request thử đầu chỉ tốn khoảng một đến hai cent nếu giữ input dưới ngưỡng 200.000 token.
Gọi Muse Ember qua Meta Model API với model muse-ember-1.0
Làm theo ngay: Meta Model API là đường vào trực tiếp nhất. Base URL là https://api.meta.ai/v1, model muse-ember-1.0, dùng qua SDK OpenAI bằng cách đổi base URL. Ember hỗ trợ endpoint Responses, Chat Completions, Messages, chỉ có chế độ Standard. Nội dung API ở chế độ Standard thì không dùng để train model. Theo ví dụ của AlphaSignal, request 100.000 input thường và 10.000 output tốn khoảng 0,015 USD. Nếu toàn bộ input được tính giá cache thì chỉ khoảng 0,0054 USD.
Đổi sang Muse Ember trong Muse Code bằng lệnh /model muse-ember-1.0
Muse Code thì cài bằng curl -fsSL https://dev.meta.ai/install.sh | bash, rồi đổi model bằng /model muse-ember-1.0 từ CLI 1.4.5. Gói Muse Code gồm Everyday 5, High 15, Power 50 và Maximum Usage 200 USD một tháng. Nhưng chưa xác thực độc lập là Ember có trong mọi gói hay không. Hiện chỉ có 1 nguồn thứ cấp nói “every plan”. Đừng mặc định cứ mua gói rẻ nhất là có Ember. Mặc định reasoning là max, nên hạ xuống low hoặc xhigh cho task đơn giản.
Thử Muse Ember qua OpenRouter với slug meta/muse-ember và số liệu throughput, latency, availability lúc mình đọc
Còn OpenRouter thì dùng slug meta/muse-ember, giá y hệt giá Meta, API tương thích OpenAI. Cộng thêm phí riêng của OpenRouter nữa đấy. Cache Write 0,125 USD cho 1 triệu token và Web Search 2,50 USD cho 1.000 lần gọi. Số liệu vận hành live lúc mình đọc là throughput 159 token một giây, latency 2,15 giây ở P50, availability 99,18% trong 3 ngày. Top app là pi.dev 1,76 tỉ token, Hermes Agent 1,6 tỉ token và Claude Code 397 triệu token. Số live có thể đổi.
Bẫy giá 200.000 token và 4 nhầm lẫn về Muse Ember trước khi đổi model
Blog ra mắt của Meta chỉ ghi giá 0,10 và 0,50 USD mà không nhắc tới bậc giá 200.000 token, bậc này chỉ VentureBeat, Xenospectrum và EconoTimes nêu ra.
Ngưỡng 200.000 token input làm giá tăng gấp 3 cho toàn bộ request
Cảnh báo nhỏ: dưới ngưỡng 200.000 token input thì giá là 0,10/0,004/0,50 USD. Trên ngưỡng thì giá tăng gấp ba thành 0,30/0,012/1,50 USD. Mức giá mới áp cho toàn bộ request. Token cache lẫn lịch sử hội thoại qua previous_response_id đều tính vào ngưỡng. Theo ví dụ của VentureBeat, request 200.000 input và 10.000 output tốn 2,5 cent. Thêm đúng một token input nữa thì tốn khoảng 7,5 cent. Chỉ một token mà hóa đơn nhảy gấp ba. Vì vậy context 1M token của Ember chỉ rẻ ở 200.000 token đầu.
Không có weights, không chạy local, không fine-tune Muse Ember
Meta không công bố số tham số, không phát hành weights. Ember chỉ chạy hosted, không chạy local hay bản quant. Khác hẳn Glimmer với giấy phép Apache 2.0 và Spark Open với 816 tỉ tham số, 42 tỉ active mỗi token, checkpoint 4-bit khoảng 537 GB. Anh em nào cần tự host hay fine-tune thì Ember không phải lựa chọn. Trên Hacker News có bình luận tiếc vì không có weights và muốn Meta phát hành model để chạy local.
Contributor mode trong Muse Code và nhầm lẫn gói Maximum 100 USD với Maximum Usage 200 USD
Muse Code mặc định bật Contributor mode. Meta có thể dùng nội dung của anh em để train đổi lại thêm hạn mức. Tắt trong /settings thì hạn mức giảm không rõ bao nhiêu. Trong khi nội dung API ở chế độ Standard thì không dùng để train model. Anh em làm việc với code công ty thì kiểm tra /settings ngay sau khi cài. Gói Maximum 100 USD một tháng là của Muse agent tiêu dùng, còn Maximum Usage 200 USD một tháng mới là của Muse Code.
Đừng nhầm Muse Ember với tin Muse lên đồng hồ cùng tuần
Cùng tuần Ember ra mắt, Meta còn đưa Muse Agent lên Apple Watch và Wear OS. Đó là tin tiêu dùng, khác với Ember là model API cho agent chạy việc. Cùng ngày Anthropic ra Claude Fable 5.2, giá 8 USD input và 40 USD output, gấp 80 lần Ember. Anthropic dùng 1.000 agent Fable 5.2 để formalize chứng minh Định lý Fermat trong 30 giờ. Nhưng đó là cuộc đua flagship, còn Ember đấu ở tầng model nhỏ cho việc lặp lại. Xem thêm bài Claude Fable 5.2 trên ThuThuatAI để đối chiếu hai tầng giá.
Nên dùng Muse Ember ngay cho việc có giới hạn, chờ kiểm chứng trước khi đưa vào production
Câu trả lời không phải là đổi hết sang Ember hay bỏ qua Ember, mà là đổi ở đâu thì tiền giảm thật và giữ ở đâu thì chất lượng không sụt.
Dùng ngay cho việc có giới hạn, có tiêu chí kiểm tra rõ. Đo chi phí thật trên workload của mình. Ví dụ, 10.000 ticket một tháng tính trước với 0,14 USD một task, tức khoảng 1.400 USD một tháng. Đối chiếu với hóa đơn thật, vì tiết kiệm thật phụ thuộc cache hit, độ dài output và số lần thử lại. Còn chưa nên đưa Ember vào production cho việc quan trọng khi toàn bộ số hiệu năng vẫn là số của Meta và Artificial Analysis, chưa có kiểm chứng độc lập quy mô lớn, ngoài Activepieces chạy 3 task.
Mình thì dùng ngay nếu có việc lặp lại có kiểm tra, còn không nên nếu cần kiến thức từ trí nhớ, code cần merge hay tự host. Anh em nào chạy thử rồi thì chia sẻ giúp mình trải nghiệm thật và hóa đơn thật.
Nguồn tham khảo

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Fireworks AI lộ billing và weights chưa hoàn chỉnh, Notion xác nhận dưới 1% workspace có thể bị ảnh hưởng
- Gemini đưa email và file Drive của bạn cho người đánh giá đọc
- Anthropic gửi bankers giá IPO 70-80 USD rồi thu hồi ngay trong đêm, trước thềm roadshow 10/11
Bình luận & Trao đổi