📑 Mục lục chi tiết bài viết (30 mục)
- Bốn hệ TPU thế hệ 8 Google ra trong năm 2026
- Chip TPU 8t và TPU 8i tháng 4/2026
- Google ráp hệ thống mới quanh silicon đã có từ tháng 4/2026
- Bảng 4 hệ TPU thế hệ 8, mỗi hệ làm một việc
- TPU 8tx chạy model nhạy cảm mà dữ liệu vẫn được bảo vệ
- CPU AMD EPYC thế hệ 5 và cơ chế AMD SEV của TPU 8tx
- Fine-tune, chưng cất và train agent trên cùng hệ TPU 8tx
- TPU 8tx hứa độ trễ thấp hơn tới 2 lần, attestation vẫn thiếu tài liệu
- TPU 8i Max gấp đôi compute, HBM chỉ tăng 33 phần trăm
- Số tuyệt đối của TPU 8i Max qua họp báo Mark Lohmeyer
- 1 triệu token là của Gemini, giới hạn của 8i Max chưa công bố
- Nghẽn KV cache trên 8i Max thì tính theo 33% HBM
- TPU 8tx và TPU 8i Max có hàng năm 2027, chưa có giá
- Amin Vahdat nói TPU 8tx và 8i Max có hàng năm 2027
- Phần mềm đi kèm ngày 09/11, TorchTPU mở mã nguồn từ 20/10
- Giá tham chiếu Ironwood, TPU v6e và v5e chưa áp cho 2 hệ mới
- Con số TPU rẻ hơn GPU Nvidia 30 phần trăm là ước tính của Mandeep Singh
- Ước tính 30 phần trăm của Singh và dự báo TPU vượt 135 tỉ USD năm 2028
- Jump Trading dùng hàng nghìn TPU nhưng vẫn chủ yếu dùng Nvidia
- Nguồn cung TPU của Google hiện tại đã có khách đặt hết
- Cổ phiếu Nvidia giảm ngày 09/11/2026 trong ngày có tin điều tra Jensen Huang
- Diễn biến cổ phiếu Nvidia trong phiên 09/11/2026
- Tin HĐQT Nvidia mở điều tra về Jensen Huang tối 08/11/2026
- Mức đóng cửa cổ phiếu Nvidia ngày 09/11, các nguồn ghi khác nhau
- Người đọc Việt Nam dùng AI qua cloud làm gì hôm nay
- Người đọc Việt Nam không mua được chip TPU lẻ
- Bốn mốc theo dõi tiếp theo cho 8tx và 8i Max
- Phản ứng lạnh nhạt trên Hacker News thread 50425018
- Kết luận
- Nguồn tham khảo
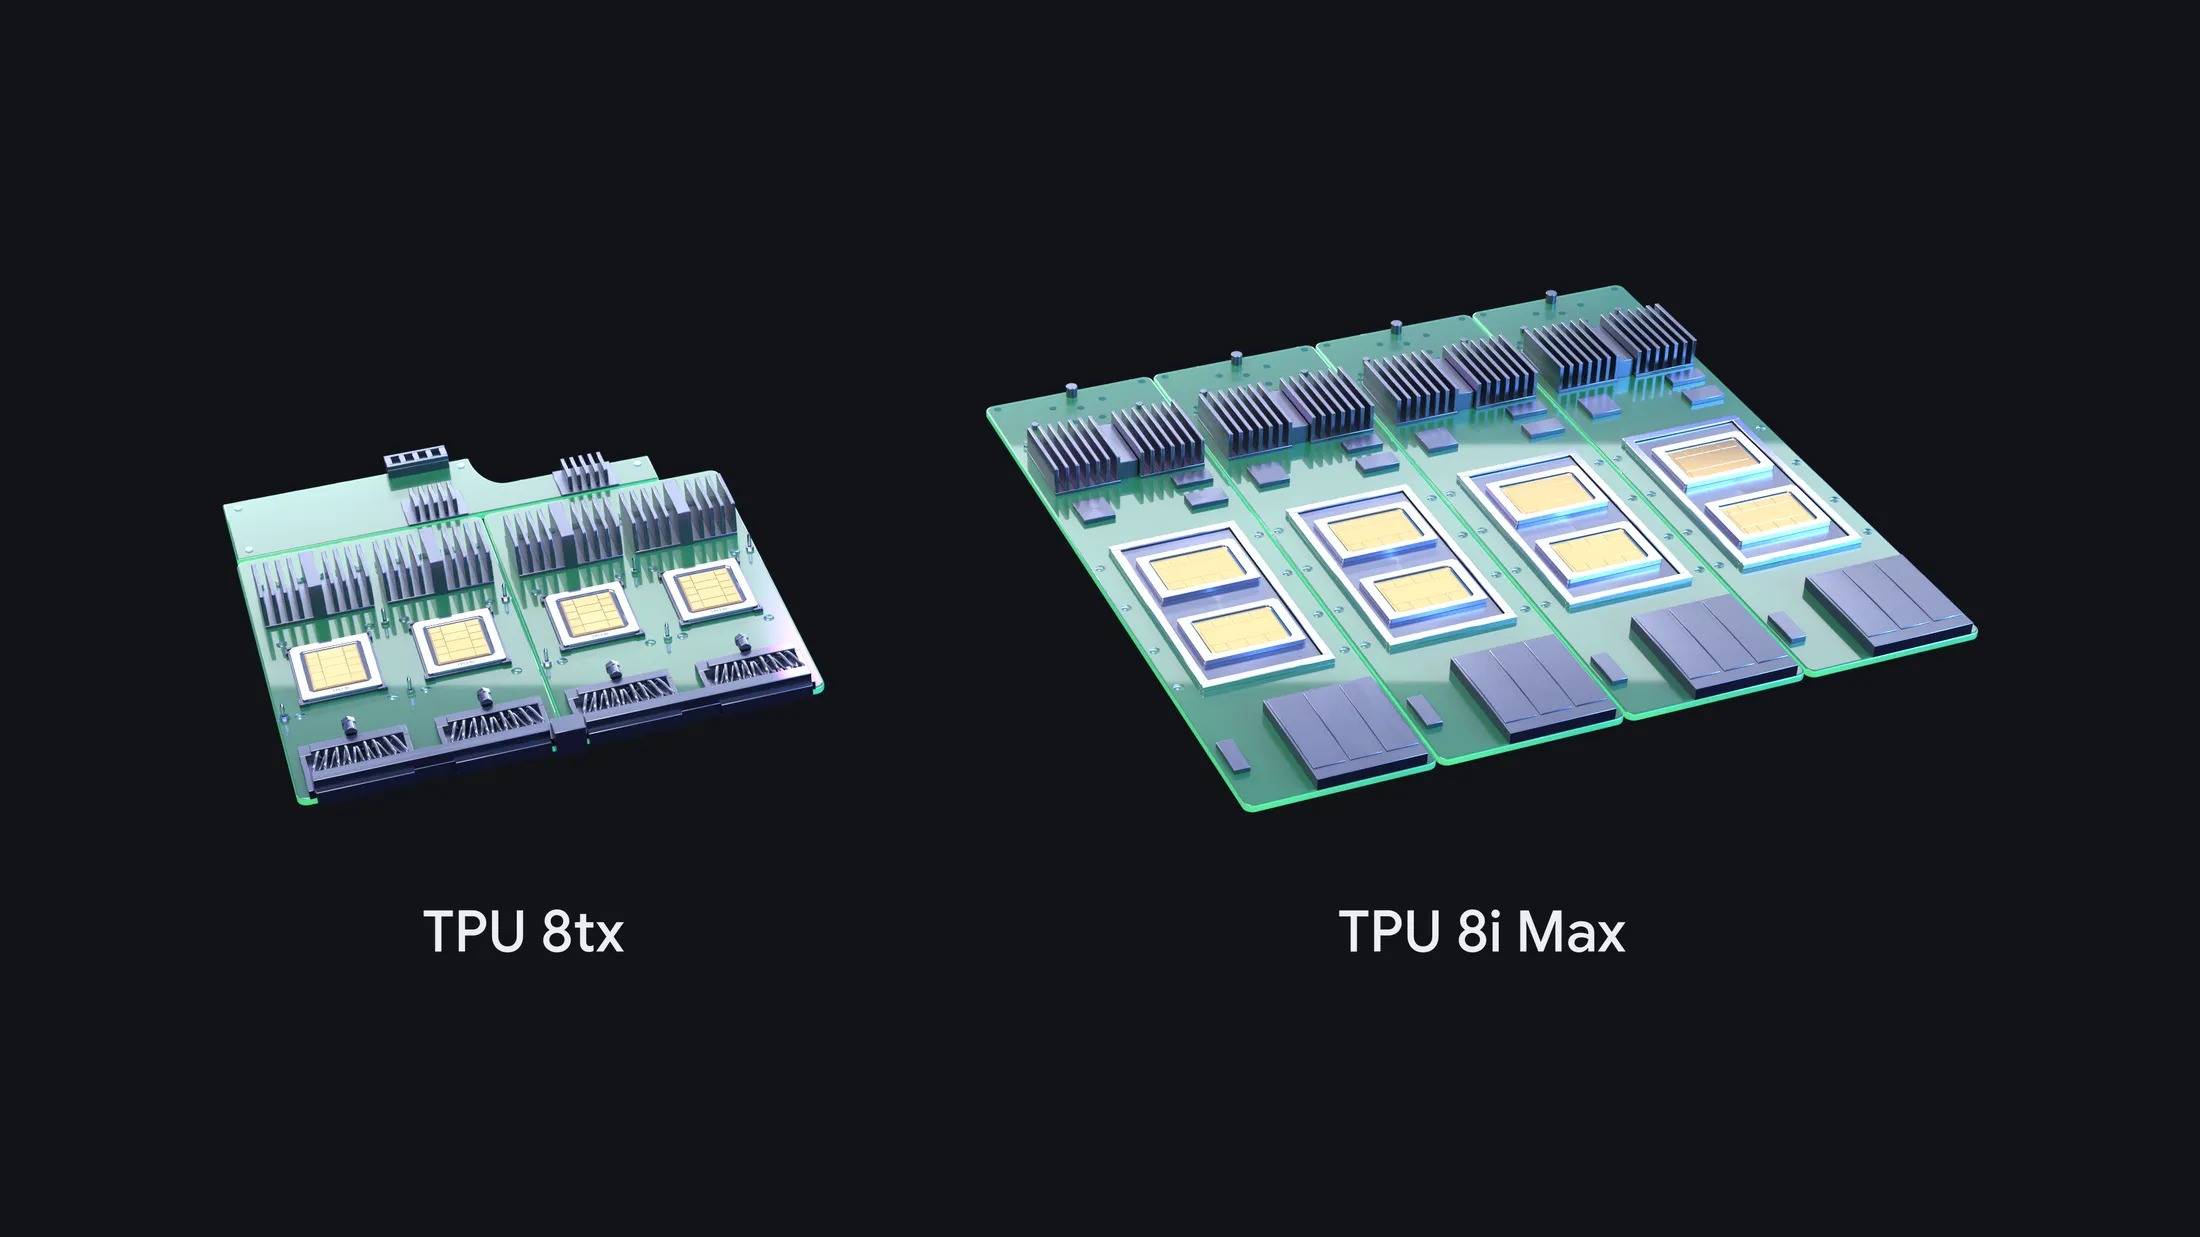
Ngày 09/11/2026, Google công bố TPU 8tx và TPU 8i Max, trong đó 8tx đánh vào mảng suy luận bảo mật, chỗ Nvidia chưa mạnh. Mình đọc xong thì thấy rõ, người Việt Nam chưa mua được gì hôm nay, chưa có giá, chưa có ngày GA, hàng về năm 2027 qua cloud.
4 hệ TPU trong năm 2026 gồm 8t, 8i, 8tx và 8i Max. TPU 8tx làm suy luận bảo mật cho ngân hàng và cơ quan nhà nước. TPU 8i Max làm context dài và mật độ compute cao trên rack. Hàng về trong năm 2027 qua Google Cloud và Oracle Cloud. Chưa có giá và chưa có ngày GA cụ thể.
Bốn hệ TPU thế hệ 8 Google ra trong năm 2026
Bốn hệ trong một năm, nhiều bài đã gọi nhầm hệ thống mới thành chip mới. Mình đọc tới 4 hệ trong 1 năm thì khựng lại. Amin Vahdat viết trên blog Google ngày 09/11/2026: “This is the first time we have introduced four TPU systems in a single year”. Đáng theo dõi, chưa đáng mua.
Chip TPU 8t và TPU 8i tháng 4/2026
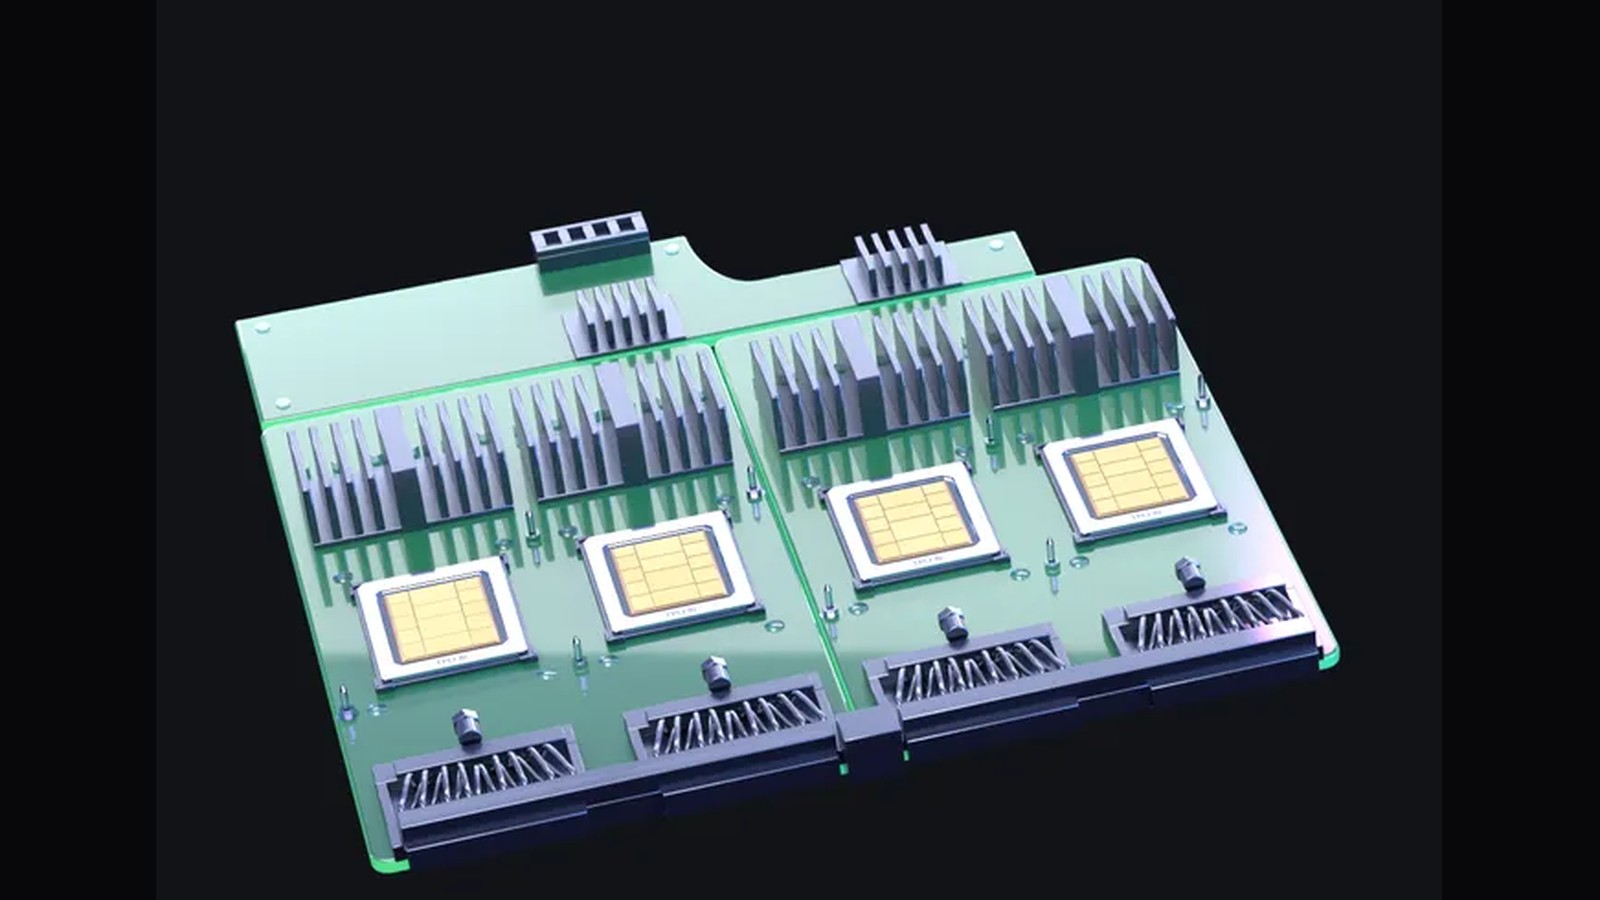
Tháng 4/2026, Google ra 2 chip thế hệ 8: 8t tên mã Sunfish cho train quy mô lớn, 8i tên mã Zebrafish cho suy luận thời gian thực, cả 2 GA cuối năm 2026 theo Google. 8t đạt 12,6 PFLOPS FP4, 216 GB HBM, 128 MB SRAM, băng thông 6.528 GB/s, superpod 9.600 chip, 121 ExaFlops FP4, 2 petabyte HBM, goodput trên 97%, hơn thế hệ trước 2,7 lần hiệu năng train.
8i đạt 10,1 PFLOPS FP4, 288 GB HBM, 384 MB SRAM gấp 3 lần thế hệ trước, băng thông 8.601 GB/s, pod 1.152 chip, hơn 80% hiệu năng suy luận trên giá. Mạng Boardfly hop tối đa 7 so với 16 của torus. Nhắc lại: đây là số hãng tự đo.
Google ráp hệ thống mới quanh silicon đã có từ tháng 4/2026
Làm chip mới tốn nhiều năm vì phải làm lại transistor trên wafer, còn ráp hệ thống mới chỉ ráp lại compute, mạng, bộ nhớ, lưu trữ và bảo mật quanh chip đã có, nên ra trong vài tháng.
TPU 8tx là silicon 8t cộng host AMD EPYC thế hệ 5 cộng mạng Boardfly của 8i. TPU 8i Max là 2 chip 8i gộp vào 1 package.
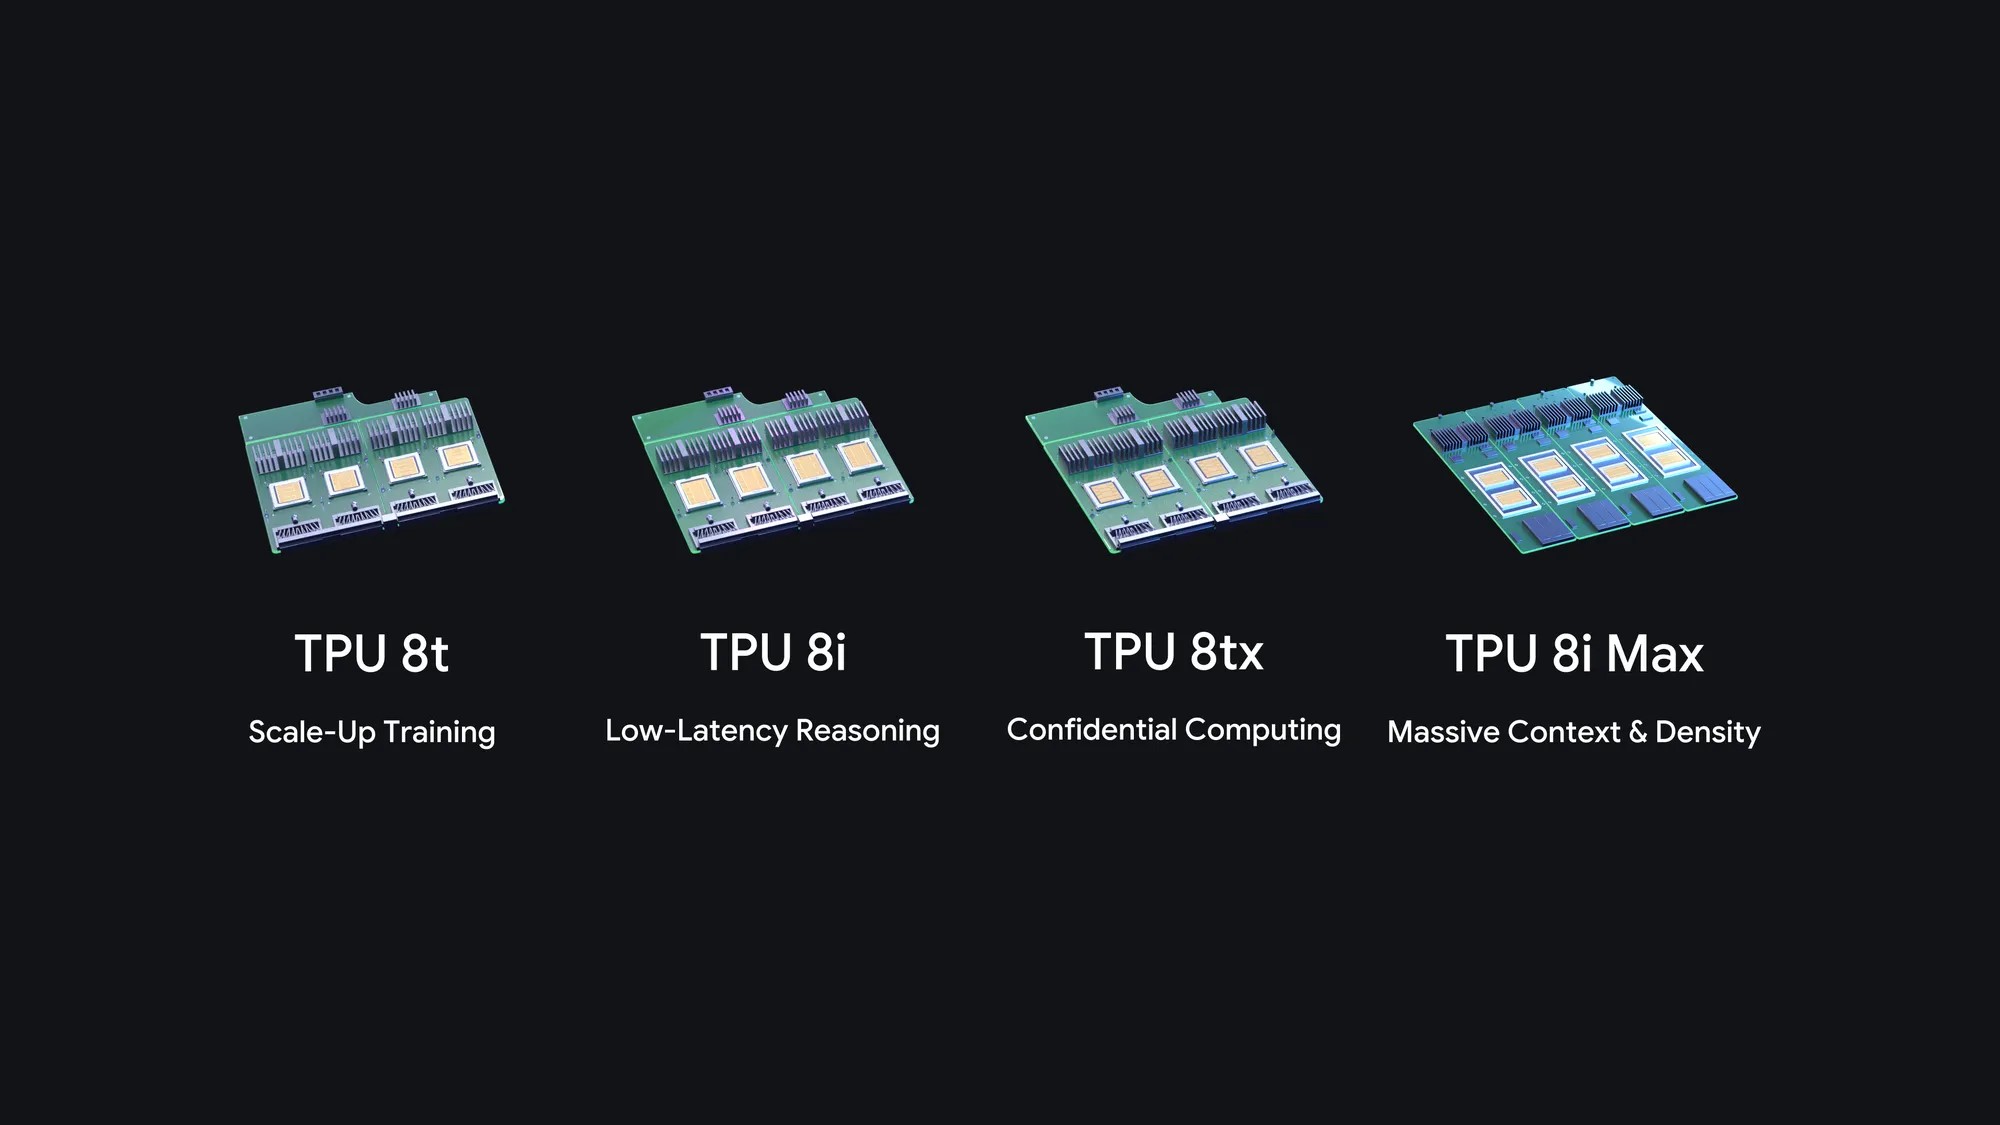
Bảng 4 hệ TPU thế hệ 8, mỗi hệ làm một việc
| Hệ TPU | Việc chính | Cấu hình cốt lõi |
|---|---|---|
| TPU 8t | Train mở rộng | Silicon train, mạng torus 3D |
| TPU 8i | Suy luận độ trễ thấp | Silicon suy luận, mạng Boardfly |
| TPU 8tx | Confidential computing | Silicon 8t cộng host AMD EPYC thế hệ 5 cộng mạng Boardfly |
| TPU 8i Max | Context window lớn và mật độ compute trên rack cao nhất | 2 chip 8i trong 1 package |
TPU 8tx chạy model nhạy cảm mà dữ liệu vẫn được bảo vệ
8tx đáng chú ý nhất vì đánh vào chỗ Nvidia chưa mạnh: suy luận bảo mật. Dữ liệu bình thường phải giải mã mới xử lý được, giống mở két ra mới đếm được tiền, còn 8tx hứa đếm tiền trong két khóa.
CPU AMD EPYC thế hệ 5 và cơ chế AMD SEV của TPU 8tx
8tx dùng cùng silicon với 8t, ghép host CPU AMD EPYC thế hệ 5 tên mã Turin, dual-socket cho 128 làn PCIe Gen5, đủ cho 4 TPU và NIC tốc độ cao, không bị oversubscription I/O.
Hệ dùng AMD SEV trong CPU EPYC, TPU mở rộng bảo vệ ra ngoài CPU tới accelerator. Trước khi accelerator truy cập bộ nhớ được bảo vệ, hệ xác minh danh tính và cấu hình bảo mật của nó. Prompt, trọng số model và dữ liệu trung gian mã hóa trong bộ nhớ CPU và khi di chuyển giữa host và accelerator, theo AMD.
Fine-tune, chưng cất và train agent trên cùng hệ TPU 8tx
8tx tối ưu cho suy luận bảo mật, để doanh nghiệp chịu quản lý và cơ quan nhà nước chạy model frontier hoặc model độc quyền cùng dữ liệu nhạy cảm. Cùng 1 hệ làm được fine-tune trên dữ liệu riêng, chưng cất model lớn thành nhỏ, train agent bằng reinforcement learning, khỏi chuyển dữ liệu nhạy cảm sang cụm khác.
TPU 8tx hứa độ trễ thấp hơn tới 2 lần, attestation vẫn thiếu tài liệu
Độ trễ thấp hơn tới 2 lần so với 8t, gần như không mất hiệu năng vì lớp bảo mật, làm mình dừng lại. Đó là số hãng tự đo. Phép so sánh lấy 8tx so với 8t, tức chip train, trong khi 8i mới là chip suy luận. Một phần độ trễ giảm có thể đến từ mạng Boardfly.
Lohmeyer nói tại họp báo toàn bộ hệ thống được attested, nhưng đó chỉ là 1 câu. Bài Google không nêu tên công nghệ TEE, không có thiết kế attestation công bố, không có audit độc lập, không rõ thế hệ SEV, HBM trên TPU hay link chip-chip.
Khảo sát IDC với hơn 600 lãnh đạo IT: xác minh attestation là thách thức áp dụng, tỉ lệ 84%. Tài liệu Google mâu thuẫn nhau: Confidential VM nói không gắn được TPU vào Confidential VM, trong khi bảng máy TPU lại đánh dấu Confidential Computing hỗ trợ trên v6e.
Câu hỏi còn mở: thế hệ SEV nào, có gồm bảo vệ toàn vẹn bộ nhớ của SEV-SNP không, HBM trên TPU có mã hóa không, link chip-chip có bảo vệ không, ai giữ key. Ai xác minh bằng chứng attestation mà không cần tin một dịch vụ của Google.
TPU 8i Max gấp đôi compute, HBM chỉ tăng 33 phần trăm
Compute gấp đôi mà HBM chỉ tăng 33 phần trăm, đó là chỗ 8i Max dễ bị đọc nhầm nhất. Mình đọc tới 384 GB thì thấy cái bẫy nằm ở dung lượng.
Số tuyệt đối của TPU 8i Max qua họp báo Mark Lohmeyer
8i Max, hệ thứ 4 của thế hệ 8, gộp 2 chip 8i vào 1 package, gấp đôi compute, SRAM, băng thông HBM so với 8i. Số tuyệt đối: 384 GB HBM, băng thông 17,2 TB/s, SRAM 768 MB. Con số này chỉ có qua họp báo của Lohmeyer, không nằm trong blog chính thức. HBM nhiều hơn 33 phần trăm so với 288 GB của 8i, Network World đăng 06/11, cập nhật 09/11.
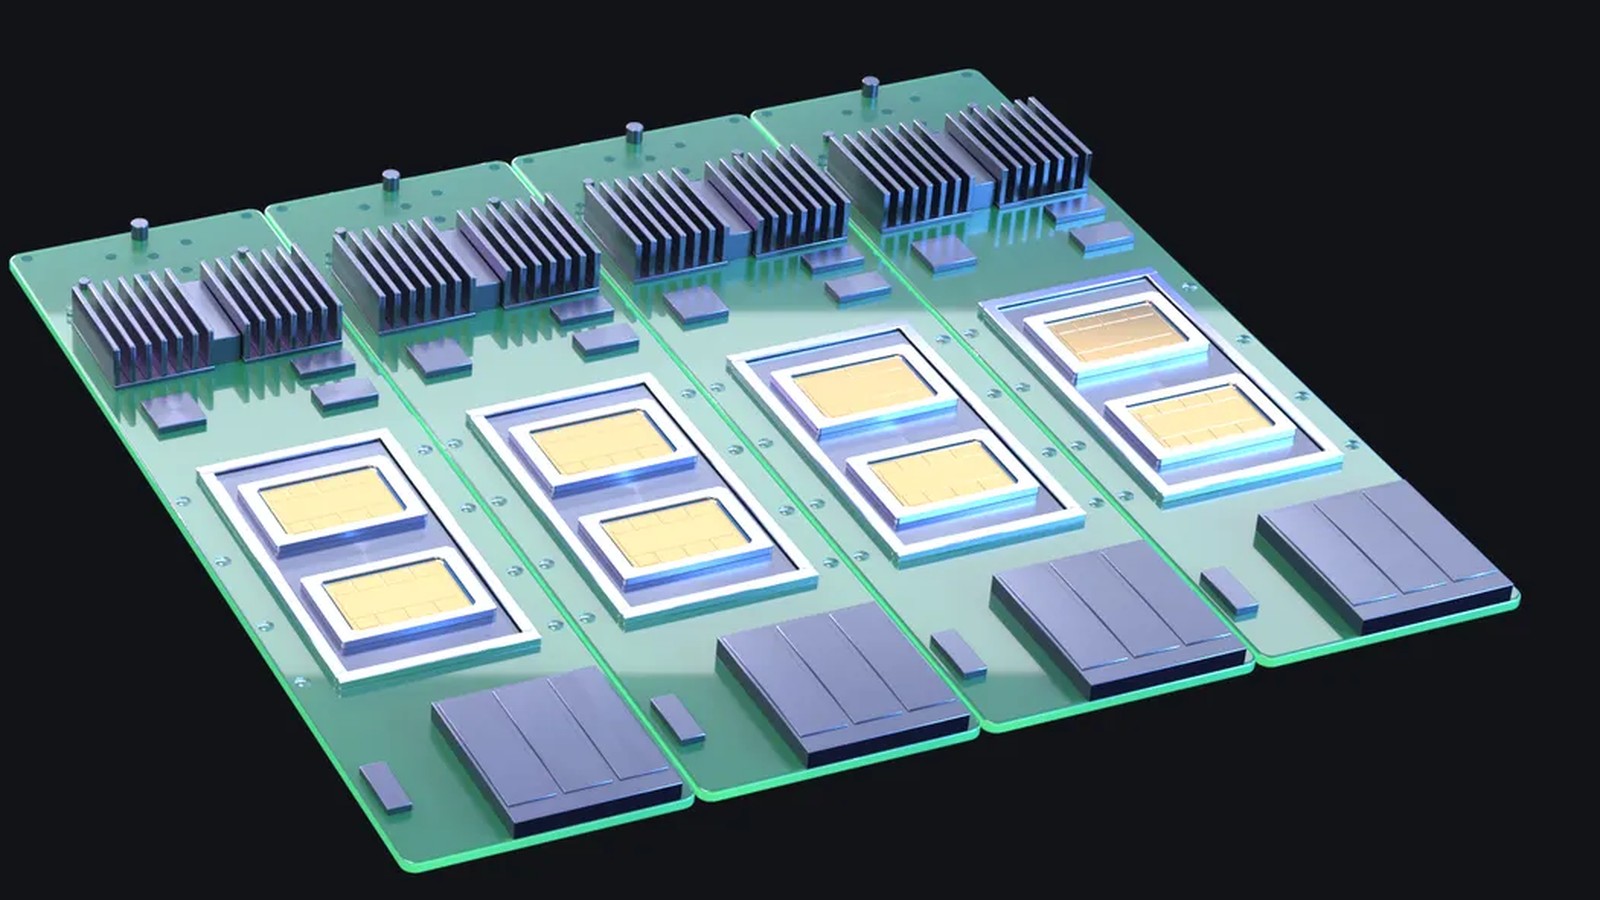
1 triệu token là của Gemini, giới hạn của 8i Max chưa công bố
8i Max nhắm tới context window lớn và mật độ compute trên rack cao nhất, ứng dụng là code, toán, khám phá thuốc, agent làm việc trên codebase hoặc video nhiều giờ.
8i Max đi cùng đợt đẩy context window lớn cho model Gemini frontier, hỗ trợ 1 triệu token, tương đương 750.000 từ hay 1.500 trang, nhưng Google không công bố giới hạn token cho 8i Max. Patrick Moorhead nhận xét khoảng 2 phần 3 compute AI đổ vào inference, chuyên môn hóa phần cứng inference là quyết định đúng.
Nghẽn KV cache trên 8i Max thì tính theo 33% HBM
Cái bẫy nằm ở con số gấp đôi: 8i Max đánh vào bức tường bộ nhớ, khi hàng chục agent làm trên codebase hoặc video nhiều giờ, băng thông bộ nhớ thành nút thắt. Cảnh báo nhỏ: HBM chỉ tăng 33 phần trăm, từ 288 GB lên 384 GB, nên ai bị nghẽn bởi dung lượng KV cache thì tính theo con số 33 phần trăm.
TPU 8tx và TPU 8i Max có hàng năm 2027, chưa có giá
Vẫn còn đó câu hỏi bao giờ mới dùng được, qua kênh nào, và trước đó thì làm gì.
Amin Vahdat nói TPU 8tx và 8i Max có hàng năm 2027
Bloomberg đăng tin sáng 09/11/2026 giờ Mỹ, Vahdat nói 2 biến thể có hàng trong 2027. Tháng 10/2026, Oracle ký thỏa thuận cho khách dùng TPU lần đầu từ 2027. Một số khách chọn lọc được cài TPU 8tx tại trung tâm dữ liệu của họ, theo Lohmeyer.
Phần mềm đi kèm ngày 09/11, TorchTPU mở mã nguồn từ 20/10
TorchTPU mở mã nguồn từ 20/10/2026 theo Apache 2.0, code PyTorch và model Hugging Face chạy native trên TPU, không cần viết lại code, backend native cho vLLM và SGLang. TPU Agent Suite mã nguồn mở, preview, cắm vào Claude Code, Cursor và Google Antigravity. Bộ này onboard TPU trong vài phút, chẩn đoán bottleneck, tự tune kernel bằng ngôn ngữ thường.
XLA Serving Engine mở mã nguồn, train bằng Python, phục vụ trong runtime C++ trên TPU, GPU và CPU. TPU Sync chuyển KV cache ra khỏi chip trong mili giây, giảm độ trễ truyền KV và thời gian tới token đầu tiên hơn 90%, số hãng tự đo, dùng được cho TPU v7, v6, v5.
Cloud Pathways GA trên GKE ngày 09/11 cho TPU v5e, v5p, v6e và Ironwood, liệt kê JAX 0.10.1 trở lên, không nhắc PyTorch hay phần cứng thế hệ 8. GKE dynamic slicing khởi động job nhanh tới 5 lần, phục hồi lỗi nhanh hơn tới 4,5 lần, số hãng tự đo.
Cảnh báo nhỏ: số InferenceX và AgentX không có con số, các bài test công khai test Ironwood, khác 2 hệ mới. SemiAnalysis đo trên Ironwood, ở 100 token/giây/người dùng, Ironwood tốn khoảng 0,181 USD/triệu token, so với 0,222 USD của B200 và 0,276 USD của B300. Nhưng chỉ đo 1 model Qwen3.5 397B FP8, input 8k/output 1k, theo giả định chi phí hyperscaler. GB300 NVL72 vẫn giữ lợi thế khoảng 30% hiệu năng trên giá ở giữa dải độ trễ.
Giá tham chiếu Ironwood, TPU v6e và v5e chưa áp cho 2 hệ mới
Google chưa công bố giá 2 hệ mới hay giá 8t, 8i, nên không suy ra giá 2 hệ mới từ giá thế hệ cũ. Giá tham chiếu: Ironwood 12,00 USD/chip-giờ on-demand, 8,40 USD cam kết 1 năm, 5,40 USD cam kết 3 năm, TPU v6e 2,70 USD/chip-giờ, v5e 1,20 USD/chip-giờ.
Con số TPU rẻ hơn GPU Nvidia 30 phần trăm là ước tính của Mandeep Singh
Mandeep Singh tại Bloomberg Intelligence là người nói con số 30 phần trăm. Mình nghe 30 phần trăm thì hấp dẫn, nhưng phải hỏi ai nói trước.
Ước tính 30 phần trăm của Singh và dự báo TPU vượt 135 tỉ USD năm 2028
Ước tính thì vẫn là ước tính, bảng giá của Google cho 2 hệ mới chưa có. Singh ước tính TPU rẻ hơn GPU Nvidia khoảng 30 phần trăm mà throughput cạnh tranh được.
Bloomberg Intelligence dự báo doanh số TPU vượt 135 tỉ USD vào 2028, từ mốc 12 tỉ USD năm 2026. Nhưng đó là dự báo, không gồm doanh số qua Google Cloud, và biên lợi nhuận TPU của Google mỏng hơn Nvidia, theo Singh. Vahdat nói với Bloomberg: “The future is going to be about specialisation, and the returns from specialisation remain significant.”
Jump Trading dùng hàng nghìn TPU nhưng vẫn chủ yếu dùng Nvidia
Jump Trading dùng hàng nghìn TPU để train model nghiên cứu giao dịch, đã thử chip nhiều năm trước khi ký hợp đồng lớn hơn 1 năm trước. CTO Alex Davies nói công ty vẫn chủ yếu dùng Nvidia để train, chỉ thiểu số nhân viên thích TPU, ở những việc TPU ngang hoặc hơn Nvidia thì tiết kiệm điện hơn.
Khách nêu tên: Apple, Meta Platforms và Oracle, gần 100 khách hàng theo blog Google. Anthropic có quyền mua tới 150 tỉ USD chip giai đoạn 2028-2031 theo hồ sơ pháp lý, OpenAI tính mua TPU theo tin Bloomberg, chưa xác nhận. Caltech chuyển nghiên cứu ung thư từ hệ HPC riêng sang TPU Google Cloud.
Nguồn cung TPU của Google hiện tại đã có khách đặt hết
Mọi TPU Google có hiện đã có khách đặt, thiếu bộ nhớ và năng lực sản xuất, nên dù 2 hệ mới có hàng năm 2027, chưa chắc khách mới mua được ngay. Google đang đa dạng hóa nguồn cung ngoài Broadcom, có thỏa thuận với Marvell, có tin MediaTek làm việc cho mảng TPU. Vahdat từ chối bình luận.
Cổ phiếu Nvidia giảm ngày 09/11/2026 trong ngày có tin điều tra Jensen Huang
Nhiều bài gán cú rơi của Nvidia trong ngày 09/11 cho tin TPU, nhưng cùng ngày còn có 1 cú sốc khác. Đừng vội kết luận Nvidia đã thua. Mình đặt hai tin cùng ngày cạnh nhau thì không gán cú rơi cho một tin.
Diễn biến cổ phiếu Nvidia trong phiên 09/11/2026
Trong phiên 09/11, cổ phiếu Nvidia mở cửa giảm hơn 8 phần trăm, sau đó hồi về mức giảm 4 phần trăm. Alphabet tăng trong ngày, Reuters ghi tăng hơn 2 phần trăm premarket. Nói TPU làm Nvidia rơi 5,7 phần trăm là nói quá, vì không tách được phần nào của cú rơi là do tin TPU, phần nào do tin điều tra.
Tin HĐQT Nvidia mở điều tra về Jensen Huang tối 08/11/2026
Tối Chủ nhật 08/11, HĐQT Nvidia mở điều tra độc lập về tin CEO Jensen Huang bị nhắm tới bởi chiến dịch tình báo nước ngoài. Cùng ngày Huang gửi email cho nhân viên thừa nhận ngoại tình và nói sẽ hợp tác đầy đủ, theo Mathrubhumi và Economic Times.
Cú sốc thứ 2 xảy ra trước phiên 09/11, nên cú rơi mở cửa không thể gán riêng cho tin TPU. Dave McCarthy tại IDC nói mảng confidential computing mạnh có thể cho Google một lợi thế nhỏ.
Mức đóng cửa cổ phiếu Nvidia ngày 09/11, các nguồn ghi khác nhau
Motley Fool, Invezz và InvestorsHub ghi số đóng cửa khác nhau. Hacker News thread 50425018 chỉ 7 điểm, 4 bình luận, xnx gọi đây là thêm tin xấu cho Nvidia hôm nay, nhưng thread chưa đọc được vì HTTP 419.
Người đọc Việt Nam dùng AI qua cloud làm gì hôm nay
Câu thực tế nhất cho người Việt Nam: không mua được chip lẻ thì làm gì với tin này.
Người đọc Việt Nam không mua được chip TPU lẻ
Người đọc thuthuatai.net không mua được TPU lẻ, chỉ dùng qua Google Cloud hoặc Oracle Cloud từ 2027. Lựa chọn confidential dùng được hôm nay là Confidential G4 với GPU Nvidia RTX PRO 6000, GA trên Google Cloud ngày 21/10/2026, 36 zone. Hôm nay thử TorchTPU với code PyTorch thực chiến, giữ 8tx và 8i Max ngoài mọi kế hoạch capacity cho tới khi có ngày và region bằng văn bản.
Bốn mốc theo dõi tiếp theo cho 8tx và 8i Max
4 mốc theo dõi: giá thuê theo chip-giờ của 8tx và 8i Max, ngày GA và region hay zone dùng trước, benchmark độc lập đo 2 hệ mới, khác benchmark Ironwood ngày 05/11/2026. Kèm theo đó là thiết kế attestation công bố và audit độc lập cho 8tx, gồm thế hệ SEV, HBM có mã hóa không, link chip-chip và ai giữ key. Và tên khách hàng đầu tiên dùng 2 hệ mới, khác Jump Trading, Apple, Meta Platforms hay Oracle.
Phản ứng lạnh nhạt trên Hacker News thread 50425018
Thread Hacker News 50425018 chỉ 7 điểm, 4 bình luận, phản ứng mỏng, do tin này không có spec, không có giá, không có ngày, không có gì để thử ngay. Bình luận của gniv hỏi không có thông tin gì về availability.
Kết luận
Google đang chia nhỏ thị trường AI theo từng việc, 8tx giữ dữ liệu nhạy cảm trong két khóa, 8i Max nhét context dài vào cùng một rack, nhưng chưa mua được hôm nay.
Tin này đáng đọc vì hướng chuyên môn hóa, hàng về 2027, chưa có giá, chưa có ngày GA, chưa có benchmark độc lập. Làm theo ngay: anh em mở repo TorchTPU, chạy thử code PyTorch sẵn có trên TPU rồi kể cho mình nghe kết quả thật. Và nếu 8tx đếm được tiền trong két khóa như hãng hứa, anh em có dám gửi dữ liệu nhạy cảm nhất lên đó không?
Nguồn tham khảo
- Blog Google, Amin Vahdat: https://blog.google/innovation-and-ai/infrastructure-and-cloud/global-network/tpu-8i-max-and-8tx/
- Straits Times, Bloomberg syndication: https://www.straitstimes.com/world/google-escalates-nvidia-rivalry-with-specialised-versions-of-ai-chips
- Reuters: https://www.reuters.com/business/google-to-introduce-two-variants-its-in-house-chips-bloomberg-news-reports-2026-11-09/
- TechTarget: https://www.techtarget.com/news/google-specializes-tpus-for-agentic-confidential-computing/874084/
- Network World: https://www.networkworld.com/article/4245897/google-targets-ais-next-infrastructure-bottlenecks-with-two-new-tpus.html
- AMD Newsroom: https://newsroom.amd.com/news/amd-epyc-expands-leadership-foundation-ai/
- ServeTheHome: https://www.servethehome.com/google-tpu-8tx-8i-max-amd-epyc-turin/
- Beri.net, The Daily Brief: https://www.beri.net/article/google-tpu-8tx-8i-max-confidential-inference-2027-availability-no-pricing-attestation-torchtpu-cloud-pathways-ga
- QNC News: https://qncnews.com/2026/11/09/google-unveils-tpu-8tx-and-tpu-8i-max-chips-as-it-steps-up-ai-rivalry-with-nvidia/
- Motley Fool: https://www.fool.com/investing/2026/11/09/why-alphabet-stock-was-moving-higher-today/
- Hacker News thread 50425018: https://news.ycombinator.com/item?id=50425018
- NextPlatform: https://www.nextplatform.com/compute/2026/11/09/google-rejiggers-tpu-accelerators-for-broader-ai-inference-work/5308534
- India Weekly: https://www.indiaweekly.biz/google-tpu-expansion-challenges-nvidia-ai-chip-dominance/
- InvestorsHub, ADVFN: https://investorshub.advfn.com/market-news/article/39559/google-expands-ai-chip-portfolio-as-nvidia-faces-investigation-involving-ceo
- Invezz: https://invezz.com/news/2026/11/09/alphabet-stock-rises-as-google-expands-ai-chip-lineup-to-challenge-nvidia/
- Deccan Chronicle: https://www.deccanchronicle.com/amp/technology/google-escalates-nvidia-rivalry-with-specialised-versions-of-ai-chips-2002936
- The Software Frontier: https://www.thesoftwarefrontier.com/p/inside-googles-tpu-how-it-works-and
- SiliconANGLE: https://siliconangle.com/2026/11/09/google-advances-agentic-ai-custom-silicon-expanding-tpu-family-with-8tx-and-8i-max/

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Claude Fable 5.2 ra mắt ngày 09/11, rẻ hơn 20% mà vẫn đắt gấp đôi Opus 5.5, còn Mythos chỉ mở cho tổ chức được duyệt
- ChatGPT Desktop bị tố forward SSH agent sang máy remote, key của anh em có bị lấy mất không
- Opus 5.5 bị "nerf" ngày 3/11? Biểu đồ 1.400 session nói có, tracker nói không, effort giải thích được bao nhiêu?
Bình luận & Trao đổi