📑 Mục lục chi tiết bài viết (27 mục)
- Chuyện gì xảy ra với Opus 5.5 ngày 3/11/2026 trong dữ liệu 1.400 session của Shane Melaugh
- Shane Melaugh nhờ Gemini 4 Argon mổ xẻ 1.400 session Claude Code của chính mình
- Bước ngoặt 18 giờ UTC ngày 3/11 làm wording trong thinking block đổi đột ngột
- Đợt sóng thứ ba sau 29/09 và 19/10 lan xa hơn hai đợt trước
- Phe bị nerf có số đếm cụ thể, điểm yếu là chỉ một người và một workflow
- Biểu đồ 2 của Melaugh, median thinking tokens 84 xuống 54 và crash index 100 lên 147
- Cùng một bug audio, high tốn 160 turns và 13,00 USD trong 3 giờ còn xhigh xong trong 5 turns với 0,85 USD
- Issue 105112 và issue 105477 ghi corrected answers tăng vọt sau 19/10
- Phe bị nerf yếu ở chỗ chỉ một người, một workflow, raw data chưa công bố
- Ba tracker và 458.000 response nói không thấy giảm, nhưng tracker không đo session agent dài
- Theo Browne đo 458.000 response, reasoning tokens tăng 369 lên 413
- LiveNerf chạy 3 window 10 ngày đều no change, output tokens ổn định 588 tới 606
- BridgeBench NerfBench 105,8 phần trăm và tokenusage.dev 100,0 ngày 08/11
- Giới hạn của tracker, không thấy thay đổi dưới 6,6 điểm và không đo session agent dài
- Cái bẫy effort medium mặc định, Opus 5.5 chạy medium trong khi Opus 5 chạy high
- Default medium, effortLevel top-level không ăn thua với Opus 5.5, benchmark launch chạy ở max
- Medium thua high bao nhiêu điểm, đã có số đo từ 4 nguồn
- Effort giải thích được cảm giác nhẹ hơn từ launch, nhưng không giải thích được bước nhảy 3/11
- Thinking tokens giảm 36% chưa chắc model suy luận kém đi
- Text trong thinking block chỉ là bản tóm tắt do một model khác viết
- Đếm từ trong biên bản họp khác với đo người trong họp suy nghĩ kỹ tới đâu
- Số thinking token của Melaugh là billed tokens hay ước tính từ summary text
- Checklist tự kiểm tra 5 tới 20 phút trên máy mình trước khi kết luận
- 3 thao tác kiểm tra effort và version trong 5 phút
- Chạy lại task cũ ở high so với xhigh và kiểm tra model fallback sang Opus 4.8 hoặc Opus 5
- Tách 3 vấn đề hay bị trộn vào chữ nerfed, chất lượng, limit drain, refusal
- Anthropic im lặng, còn anh em thì tự đo được tới đâu
Anh em đang trả tiền Claude Pro hoặc Max rồi dùng Claude Code mỗi ngày thì câu hỏi này chạm đúng túi tiền. Nếu Opus 5.5 âm thầm yếu đi mà không ai báo trước thì mỗi prompt mình gửi đi đều đang mua một model khác với model mình tưởng. Và điều khó chịu nhất là mình không có cách nào tự kiểm chứng ngay trên máy mình.
Tóm tắt nhanh: thay đổi wording của thinking summary ngày 3/11 là có thật, cả hai phía đều thấy. Thinking tokens giảm 36% và corrected answers tăng sau 19/10 là cáo buộc có số liệu, chưa bên độc lập nào xác nhận. Tracker đo task cố định không phát hiện giảm sút, nhưng tracker không đo session agent dài. Trước khi kết luận, kiểm tra effort của mình trước, vì Opus 5.5 chạy mặc định ở medium trong khi Opus 5 chạy mặc định ở high.
Chuyện gì xảy ra với Opus 5.5 ngày 3/11/2026 trong dữ liệu 1.400 session của Shane Melaugh
Trước khi tranh cãi nerf hay không nerf, mình kể lại đúng chuyện đã xảy ra. Mốc 3/11 là một bước ngoặt có giờ giấc và con số cụ thể.
Shane Melaugh nhờ Gemini 4 Argon mổ xẻ 1.400 session Claude Code của chính mình
Shane Melaugh đăng trên X lúc 17:15 ET ngày 07/11/2026, theo bài phân tích ngày 09/11/2026 tường thuật lại, với câu hỏi “is Opus 5.5 nerfed?” rồi kể ông nhờ Gemini 4 Argon phân tích 1.400 Claude Code session của chính mình. Ông nhận ra ngày 3/11 có chuyện gì đó đã xảy ra, tên model không đổi nhưng cách nó suy luận thì rẽ ngoặt rất rõ, “the model name didn’t change, but the way it does reasoning took a sharp turn”. Post lan nhanh: khoảng 493.000 lượt xem, 2.706 thích, 286 trả lời tính đến sáng 09/11/2026, thread Hacker News 50422069 leo từ 192 điểm, 120 bình luận lên 315 điểm, 210 bình luận trong 7 giờ cùng ngày.
Bước ngoặt 18 giờ UTC ngày 3/11 làm wording trong thinking block đổi đột ngột
Bước ngoặt rơi vào khoảng 18:00 UTC ngày 03/11/2026, tức 13:00 ET, nó xuất hiện giữa 7 session đang chạy, cùng model ID claude-opus-5-5 và cùng phiên bản CLI ở cả hai phía của mốc giờ. Thế nên khó đổ cho chuyện đổi model hay đổi máy.
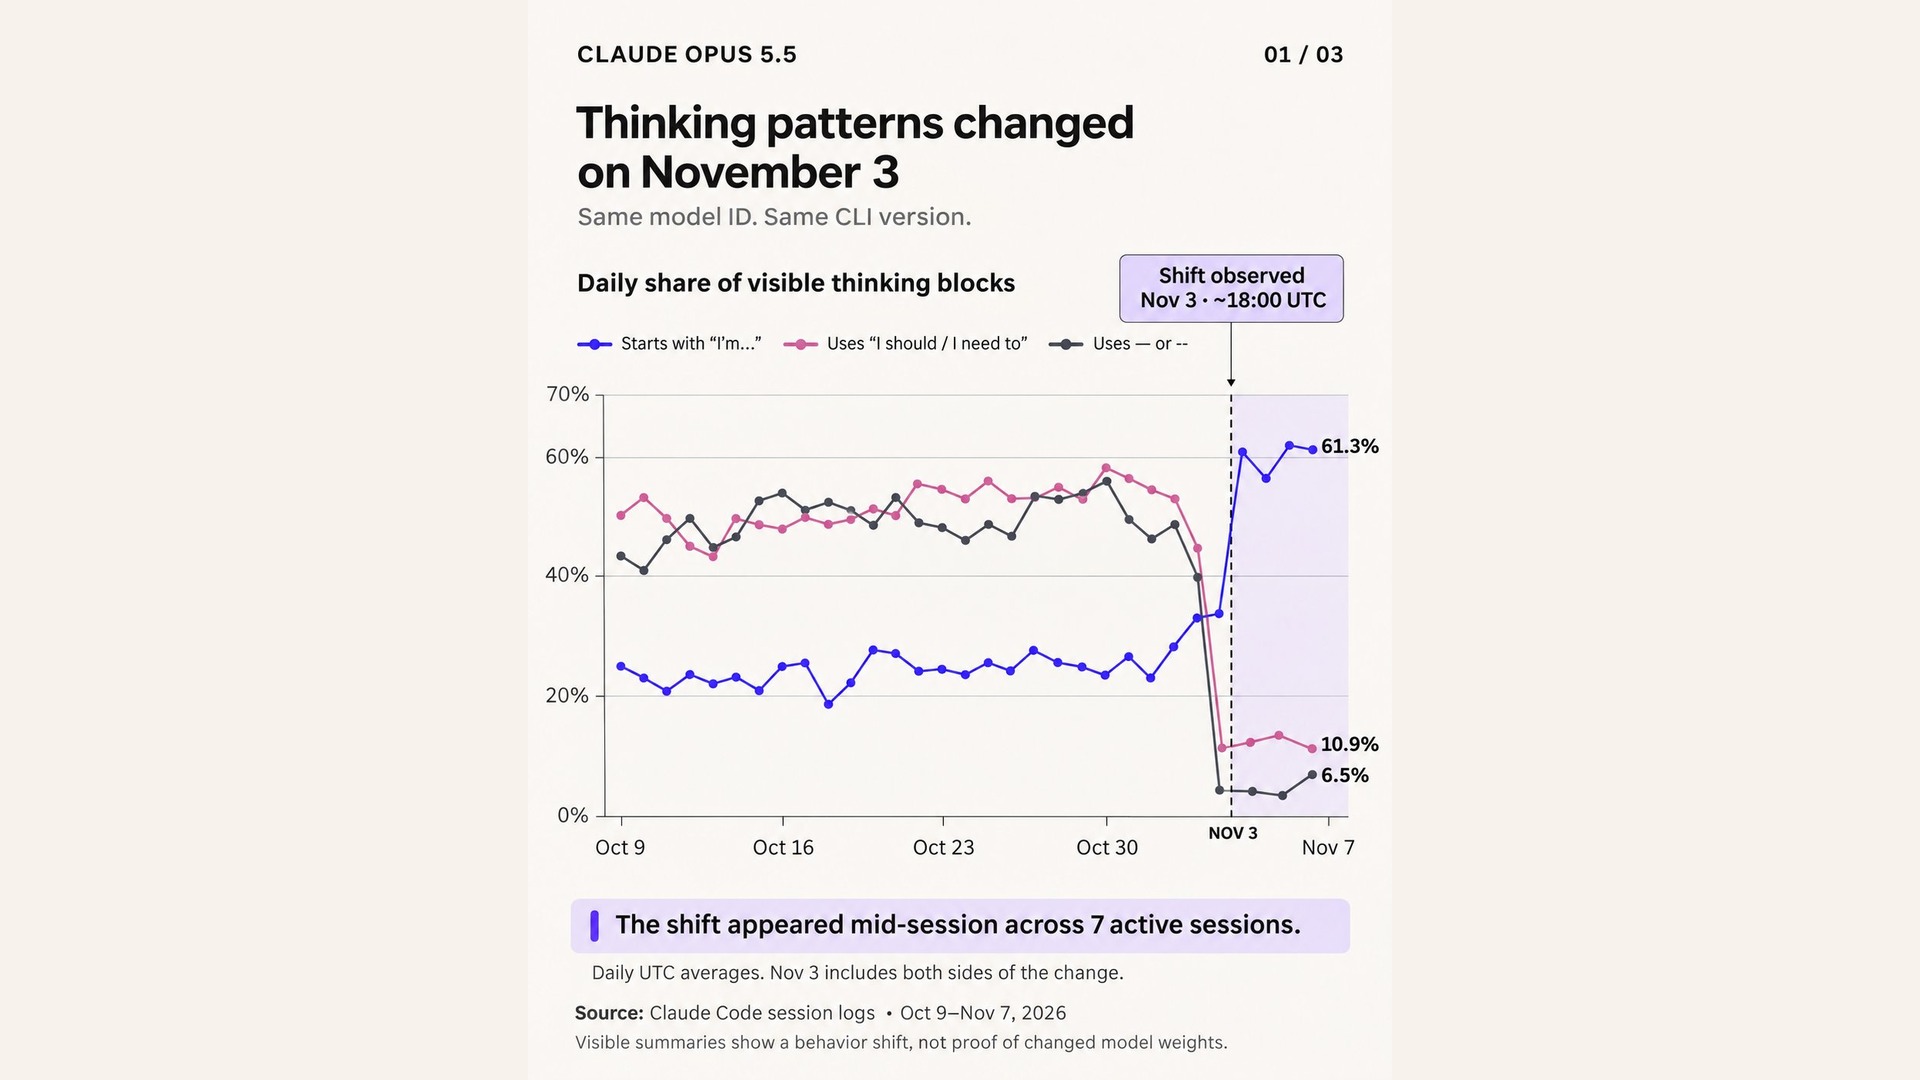
Caption: Biểu đồ 1 của Shane Melaugh, tỉ lệ thinking block mở đầu bằng “I’m…” nhảy lên 61,3% sau khoảng 18:00 UTC ngày 3/11/2026, trong khi “I should / I need to” rơi xuống 10,9% (nguồn: post X của Shane Melaugh ngày 07/11/2026, theo bài phân tích ngày 09/11/2026 tường thuật lại).
| Wording trong thinking block | Trước 18:00 UTC 03/11 | Sau 18:00 UTC 03/11 |
|---|---|---|
| Mở đầu bằng “I’m…” | Thấp hơn | 61,3% |
| “I should” / “I need to” | Cao hơn | 10,9% |
| Chứa dấu gạch ngang | Cao hơn | 6,5% |
| Chuyển đổi ở account Theo Browne | Rải rác 30/10, 31/10, 03/11 18:00 UTC, 2 lần 04/11 | 1 account không đổi |
Đợt sóng thứ ba sau 29/09 và 19/10 lan xa hơn hai đợt trước
Đây đã là đợt sóng thứ ba. Đợt một rơi vào ngày 29 tới 30/09 sau outage, khi Reddit user juaps viết Opus 5.5 “feels way dumber after today’s outage” và thread đó thu hơn 400 upvotes, ý kiến chia đôi, còn đợt hai rơi vào ngày 18 tới 19/10 với issue #105112 mà mình kể kỹ ở mục sau. Sóng thứ ba lên đỉnh ngày 04 tới 06/11: Irushi đếm 9 lần model lặp lại cách giải đã bị reject, @scottstts nói overnight run ra “complete garbage”, i10x đếm khoảng 2.700 post trong 24 giờ, và Vraj viết “half my timeline says Opus 5.5 got nerfed”, tất cả theo bài phân tích ngày 09/11/2026 tường thuật lại.
Phe bị nerf có số đếm cụ thể, điểm yếu là chỉ một người và một workflow
Phe khiếu nại có biểu đồ và số đếm cụ thể, nên mình trình bày phiên bản mạnh nhất của họ trước. Rồi mình soi điểm yếu ngay trong cùng một mục.
| Chỉ số | Nó đo cái gì | Con số phía khiếu nại đưa ra | Trạng thái kiểm chứng |
|---|---|---|---|
| Wording của thinking summary | Cách diễn đạt trong bản tóm tắt suy luận mà người dùng nhìn thấy | “I’m…” lên 61,3%, “I should / I need to” xuống 10,9% sau 18:00 UTC 03/11 | [ĐÃ KIỂM CHỨNG] thay đổi wording là có thật, cả hai phía đều thấy |
| Thinking tokens và crash | Lượng suy luận trước tool call đầu tiên và tỉ lệ script hoặc edit bị lỗi | Median thinking tokens 84 xuống 54, giảm 36%, 40,5% turns có 0 thinking token, crash index 100 lên 147 | [CÁO BUỘC CÓ SỐ LIỆU, CHƯA XÁC NHẬN ĐỘC LẬP] |
| Corrected answers | Chất lượng đầu ra, đo bằng tỉ lệ câu trả lời bị chính người dùng sửa lại | 5,2% lên 25,4% sau 19/10 trong issue #105112 | [CÁO BUỘC CÓ SỐ LIỆU, CHƯA XÁC NHẬN ĐỘC LẬP] |
Biểu đồ 2 của Melaugh, median thinking tokens 84 xuống 54 và crash index 100 lên 147
Con số đắt nhất nằm ở effort high, trong biểu đồ thứ hai của Melaugh. Ông so sánh 14.560 turns trước ngày 03/11 với 14.871 turns sau ngày đó, median thinking tokens trước tool call đầu tiên giảm từ 84 xuống 54, tức giảm 36%. Trong đó 40,5% turns có 0 thinking token. Chỗ này còn một câu hỏi mở, vì các post của Melaugh không nói rõ số token này là billed tokens hay ước tính từ summary text, mà docs Anthropic nói follow-up request có thể skip thinking ngay cả ở xhigh và max, nên 40,5% bớt bí ẩn hơn vẻ ngoài.
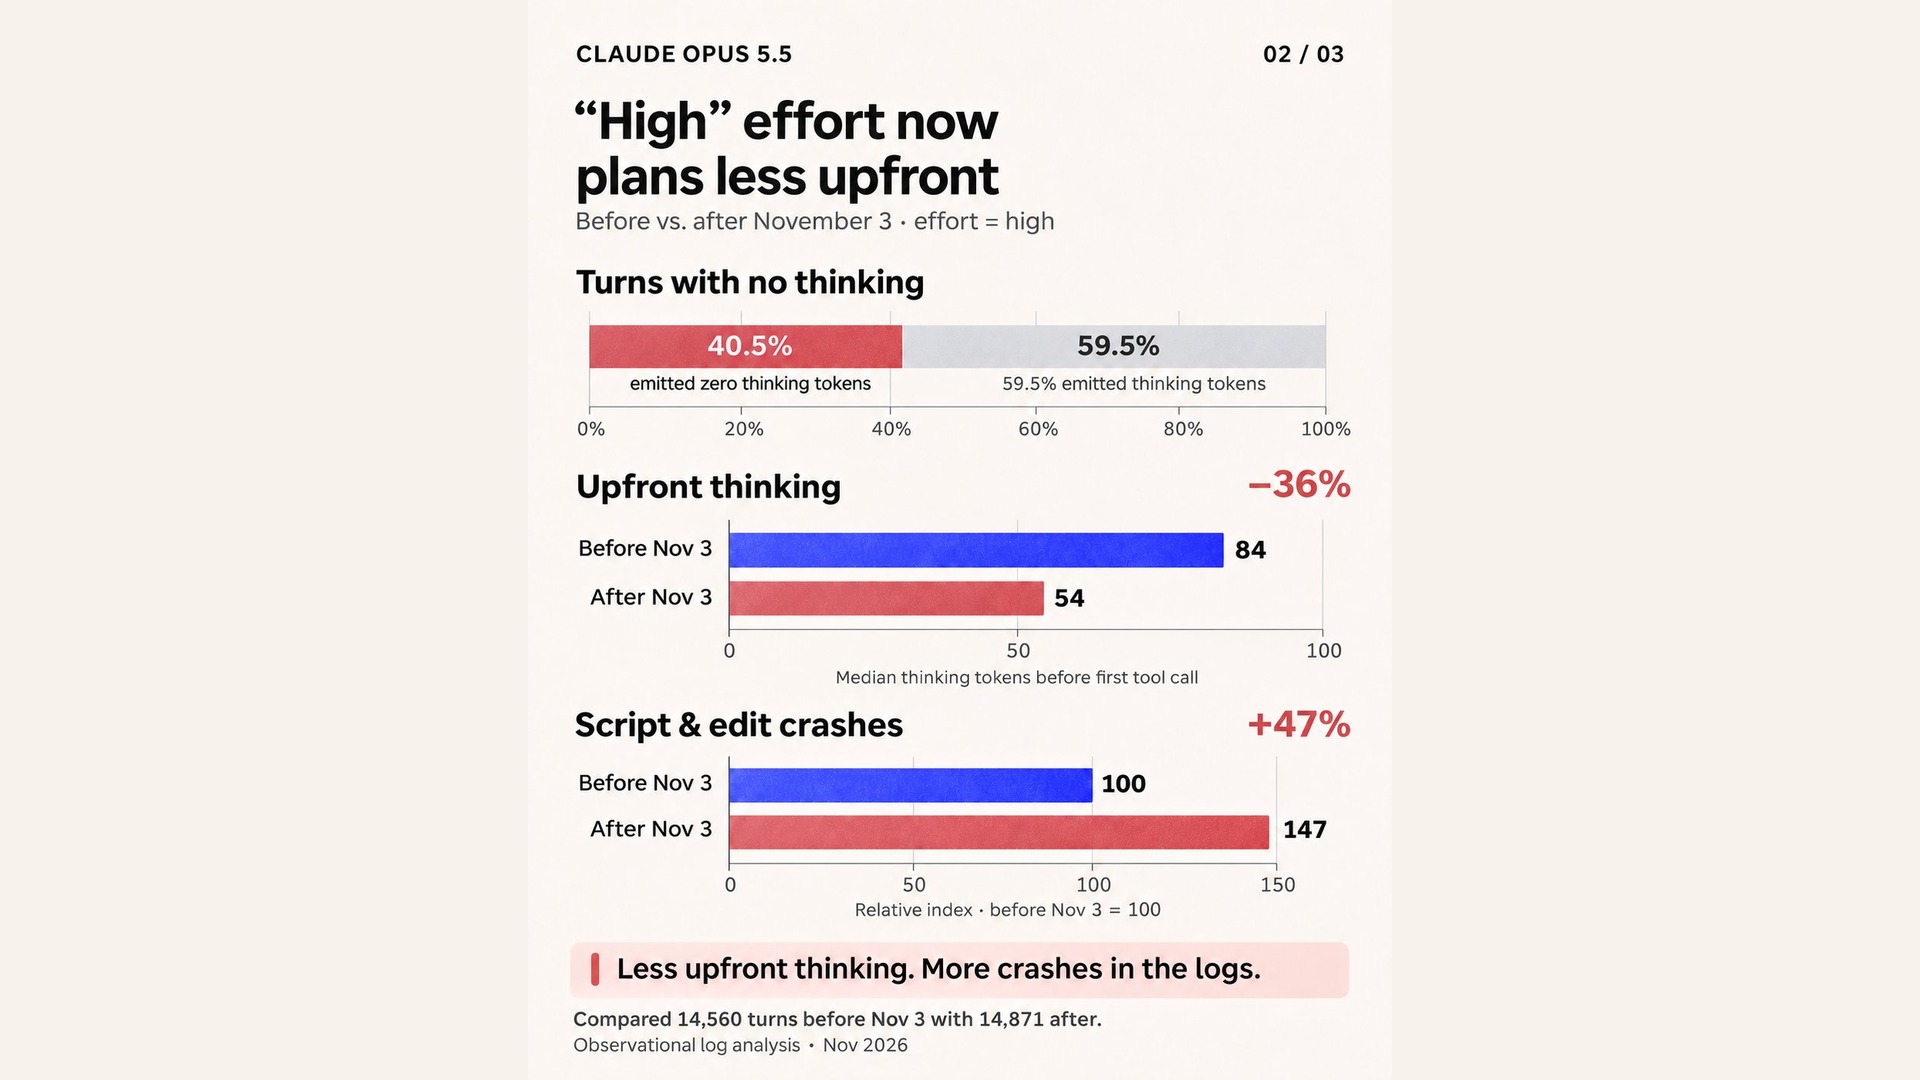
Caption: Biểu đồ 2 của Shane Melaugh, median thinking tokens ở high effort giảm 84 xuống 54, giảm 36%, 40,5% turns có 0 thinking token, chỉ số script/edit crash tăng 100 lên 147 (nguồn: post X của Shane Melaugh ngày 07/11/2026; trên ảnh ghi rõ “One case, not a controlled benchmark”).
Cùng một bug audio, high tốn 160 turns và 13,00 USD trong 3 giờ còn xhigh xong trong 5 turns với 0,85 USD
Case study làm nhiều anh em Việt giật mình nhất là hóa đơn, vì cùng một bug audio playback, chạy ở high thì model ngốn 160 turns và 13,00 USD trong 3 giờ mà vẫn thất bại. Chuyển sang xhigh thì chỉ 5 turns với 0,85 USD đã sửa xong. Và chính Melaugh kết luận quy tắc “use high for everything” giờ “no longer applies”.
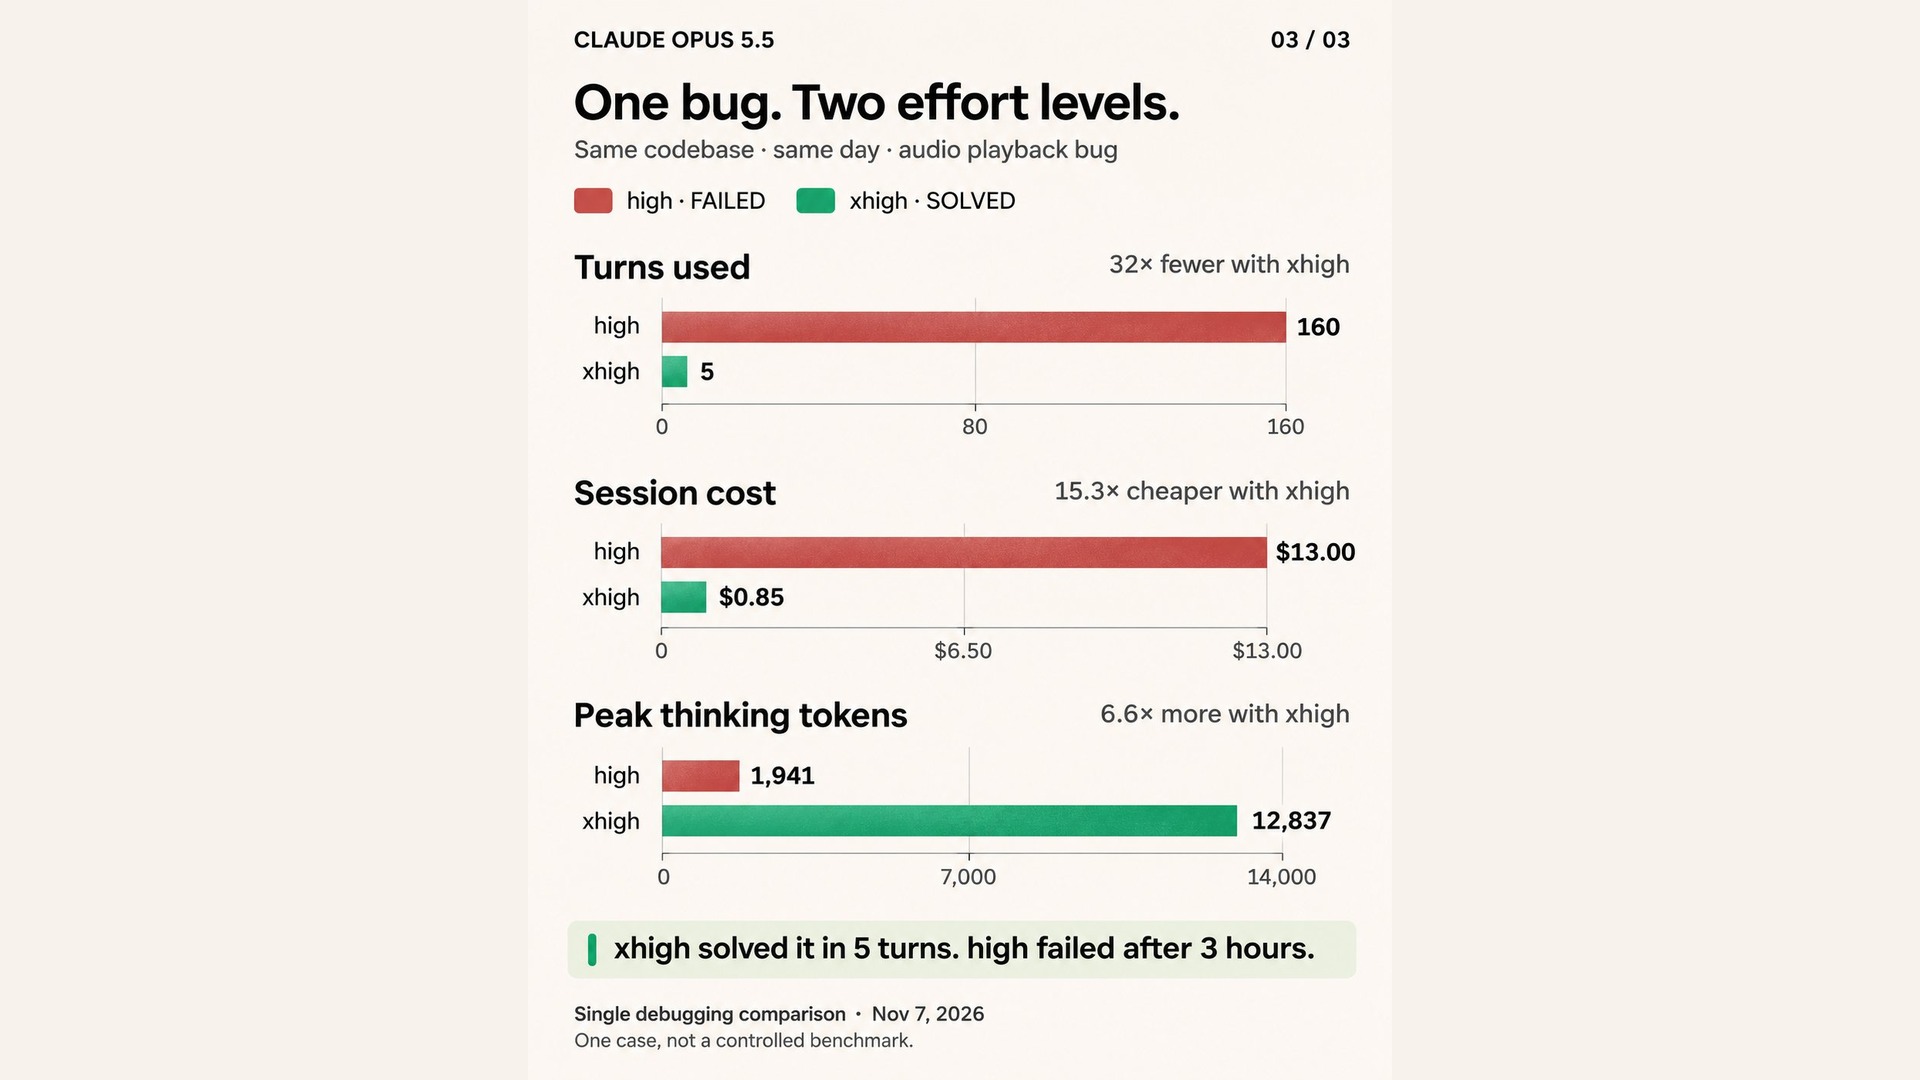
Caption: Biểu đồ 3 của Shane Melaugh, cùng một bug audio playback, high effort tốn 160 turns và 13,00 USD trong 3 giờ mà thất bại, xhigh xong trong 5 turns với 0,85 USD (nguồn: post X của Shane Melaugh ngày 07/11/2026).
Issue 105112 và issue 105477 ghi corrected answers tăng vọt sau 19/10
Issue #105112 mở ngày 25/10, tác giả chấm 6.638 câu trả lời Opus 5.5 từ transcript Claude Code local. Bước nhảy thu hẹp vào cửa sổ từ 18/10 lúc 20:52 tới 19/10 lúc 13:13 giờ Pacific, trong khi client build, file CLAUDE.md, hooks và prefix prompt 29.503 token đã cache đều giống hệt từng byte. Điểm mạnh là nó đo hành vi có thể kiểm chứng chứ không đo wording, vì model làm cùng lượng việc, median tool calls và billed thinking giữ nguyên hoặc tăng, nhưng lại viết câu trả lời phớt lờ hoặc mâu thuẫn với thứ nó vừa đọc.
| Issue | Corrected answers trước 19/10 | Sau 19/10 | Ghi chú |
|---|---|---|---|
| #105112, mở 25/10, 6.638 câu trả lời | 5,2% của 5.738 câu, high 5,4% | 25,4% của 900 câu, high 26,6%, max 50% bị sửa. Retry sai 41,5% so với 10% trước đó. Tuần 04/11 vẫn 17,0% so với 3,6% tới 7,0% cuối tháng 8 tới giữa tháng 10 |
Client, CLAUDE.md, hooks, 29.503 token cached prompt prefix giống hệt từng byte. Cửa sổ 18/10 20:52 tới 19/10 13:13 giờ Pacific |
| #105477, timoncool, mở 27/10, 49.275 response, 1 session 08 tới 27/10 | 24,8% của 726 message chứa correction, 08 tới 18/10 | 39,1% của 815 message, 19 tới 25/10, 32,1% của 524 message, 26 tới 27/10 | Model đổi ONNX Runtime version không hỏi, “This is not a silent fallback to another model. It is the same model working worse.” |
Phe bị nerf yếu ở chỗ chỉ một người, một workflow, raw data chưa công bố
Điểm yếu cũng phải nói đủ, vì cả hai dataset đều của một người, một workflow, raw data chưa công bố nên không ai tái tạo được. Phương pháp correction detection của #105112 là script-based, còn #105477 thì tác giả tự nhận phương pháp của mình “cruder than #105112’s”, và Anthropic chưa trả lời trong issue. Chính Melaugh bổ sung sáng 09/11: phân tích này “isn’t a scientifically bulletproof benchmark” và thay đổi thinking patterns “doesn’t necessarily mean there’s been a nerf”, còn chú thích trên biểu đồ viết visible summaries “show a behavior shift, not proof of changed model weights”.
Ba tracker và 458.000 response nói không thấy giảm, nhưng tracker không đo session agent dài
Nếu chỉ nghe phe khiếu nại thì câu chuyện coi như xong, nhưng ba tracker độc lập và một bộ proxy log 458.000 response đều nói không thấy gì giảm. Thế nên mục này đặt hai bộ số đối nghịch lên cùng một trục.
| Trục so sánh | Shane Melaugh, 1.400 session | Theo Browne, 458.000 response |
|---|---|---|
| Cái được đo | Median thinking tokens trước tool call đầu tiên, ở high effort | Reasoning tokens billed qua proxy, tính trên mỗi response |
| Kết quả sau mốc 03/11 | 84 xuống 54, giảm 36%, crash index 100 lên 147 | 369 lên 413, reasoning share 46% lên 49% |
| Tốc độ và tool calls | Không công bố số này | 111 lên 112 tok/s, tool calls 1,03 lên 1,06 trên mỗi response |
| Câu hỏi còn lại | Số token này là billed tokens hay ước tính từ summary text | Vì sao wording đổi mà reasoning tokens billed vẫn tăng |
Theo Browne đo 458.000 response, reasoning tokens tăng 369 lên 413
Theo Browne đo 458.000 response Opus 5.5 qua proxy của chính mình từ 09/10 tới 07/11/2026, trên Claude Code 2.1.280, thinking display đặt ở “summarized”. Ông kết luận “No sign of degraded capability for me”. Giới hạn là Theo cũng chỉ là một người với một proxy, không công bố raw data, và ông đo reasoning tokens billed qua proxy trong khi Melaugh có thể đo một đại lượng khác.
LiveNerf chạy 3 window 10 ngày đều no change, output tokens ổn định 588 tới 606
LiveNerf là tracker mạnh nhất về phương pháp, vì đây là tracker mã nguồn mở ở repo ninjahawk/livenerf, tạo ngày 22/09/2026, pre-registered, panel 78 câu cố định sàng lọc từ 2.336 câu gồm GPQA Diamond, MMLU-Pro, competition math và AIME 2025-26. CLI ghim ở 2.1.280, effort high truyền tường minh, chạy 46 trên 60 ngày tính đến 08/11. Số output tokens trên mỗi câu, tín hiệu mà chính tác giả tracker coi là quan trọng nhất, vẫn ổn định qua cả 3 window.
| LiveNerf window | Điểm | Chênh so với baseline | Median output tokens | Kết luận |
|---|---|---|---|---|
| Baseline days 1 tới 10 | 0,584 cộng trừ 0,036 | Mốc so sánh | 588 | Mốc so sánh |
| Window 1, 04 tới 13/10 | 0,592 cộng trừ 0,037 | Cộng 0,007 cộng trừ 0,018 | 606 | “no change” |
| Window 2, 14 tới 23/10 | 0,571 cộng trừ 0,035 | Trừ 0,015 cộng trừ 0,018 | 594 | “no change” |
| Window 3, 24/10 tới 02/11 | 0,614 cộng trừ 0,037 | Cộng 0,028 cộng trừ 0,023 | 590 | “no change” |
| Day 47 qua Reddit | Drop tối đa khoảng 2 điểm phần trăm ở tin cậy 95% | Chưa rõ | Chưa rõ | Chưa có verdict bao phủ 03/11, window 4 mới bắt đầu |
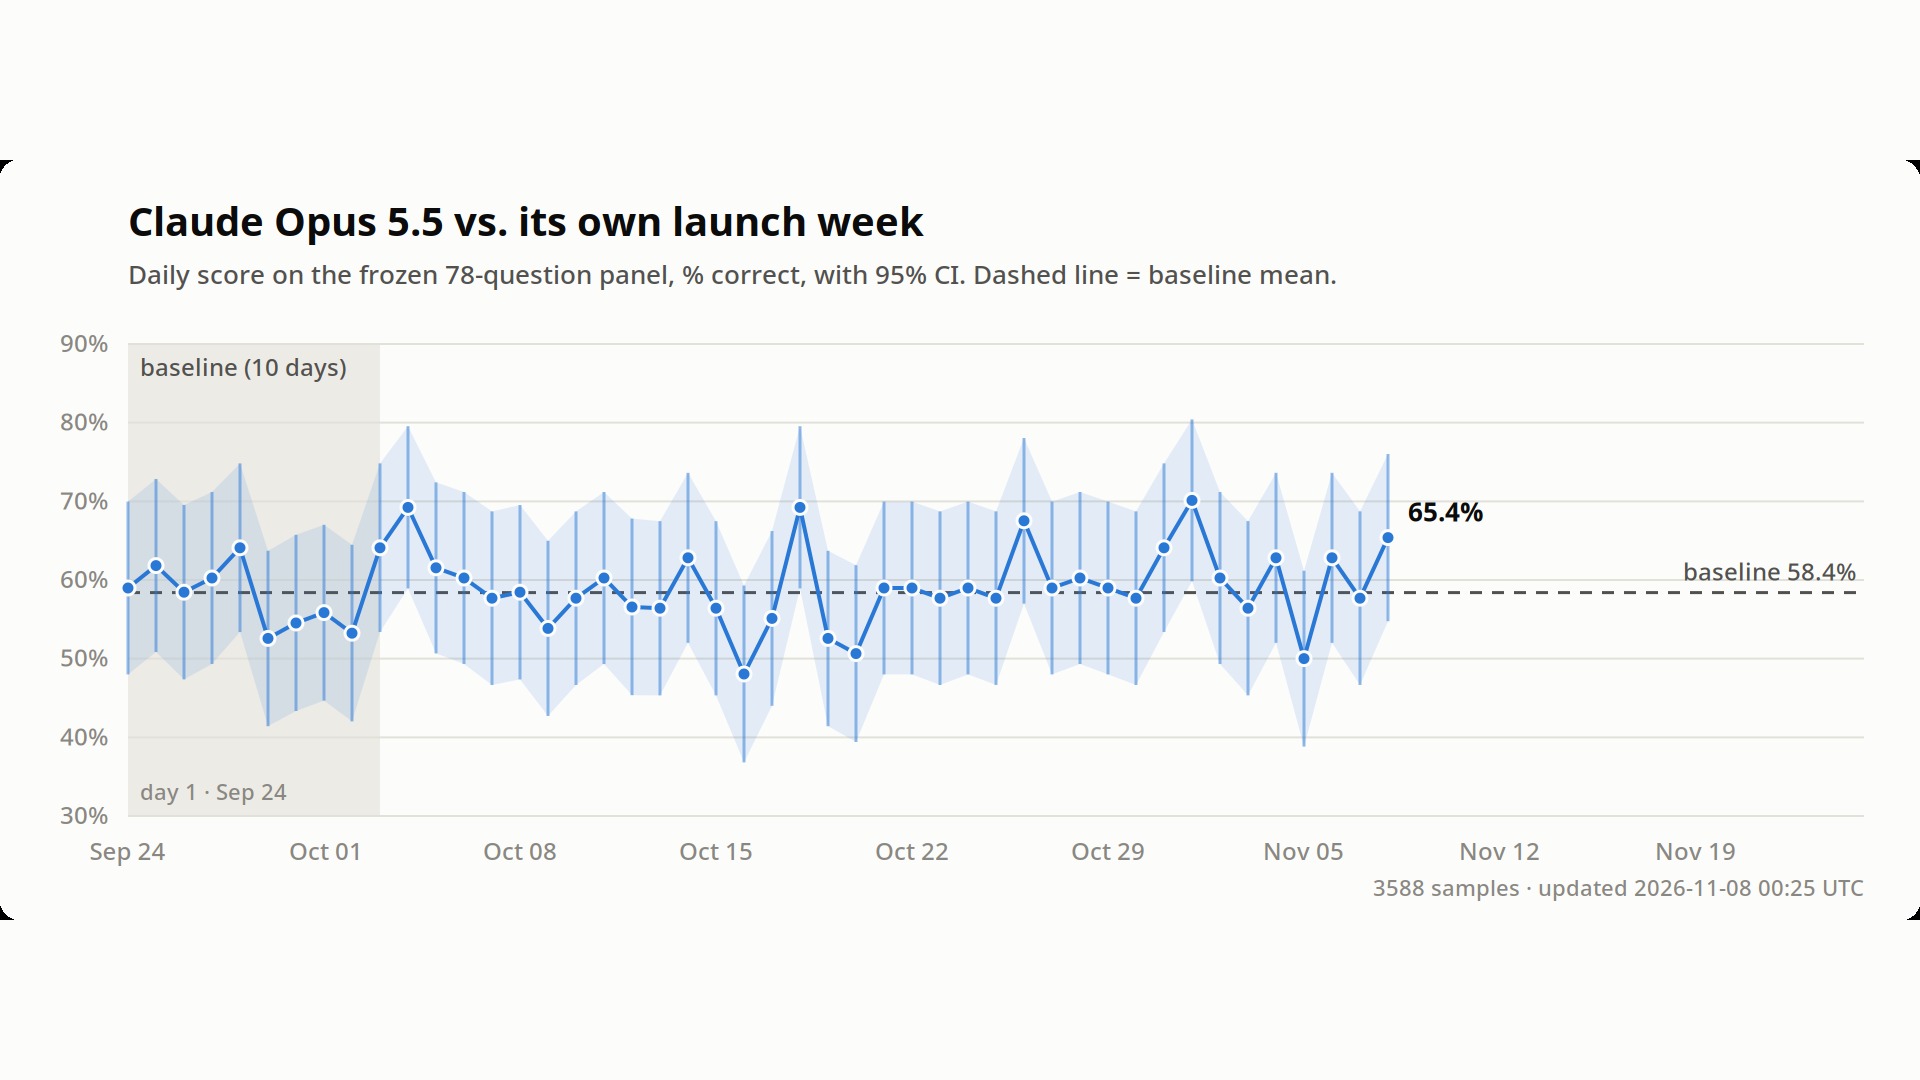
Caption: Biểu đồ kết quả LiveNerf sau 46 ngày, cập nhật 08/11/2026, điểm hàng ngày trên panel 78 câu cố định dao động quanh baseline 58,4%, cả 3 window 10 ngày đều “no change” (nguồn: repo LiveNerf cập nhật 08/11/2026, github.com/ninjahawk/livenerf).
BridgeBench NerfBench 105,8 phần trăm và tokenusage.dev 100,0 ngày 08/11
BridgeBench NerfBench chạy 50 coding và reasoning task private qua 8 categories, 3 attempts trên mỗi task, single response, không tools và không repo, qua API, biên 90 tới 110% là normal variance. Các run ghi launch ngày 22/09 là 100,0%, 27/09 là 99,2%, 01/10 là 103,8%, 02/10 là 94,2%, 04/10 là 96,5%, 09/10 là 95,7%, 16/10 là 105,8%, tức tăng 5,8%, với kết luận “No nerfs detected”.
| Tracker | Số liệu mới nhất tính đến 09/11/2026 | Kết luận của tracker |
|---|---|---|
| BridgeBench NerfBench | 105,8% (run ngày 16/10, so với mốc launch 100,0%), mọi run trong biên 90 tới 110% | “No nerfs detected” |
| tokenusage.dev Nerf Watch | 100,0 ngày 08/11, 97,1 ngày 03/11, 90,9 ngày 07/11 rồi hồi ngay | Không có cú giảm bền vững quanh 03/11 |
| LiveNerf | Window 3 cộng 0,028 cộng trừ 0,023 so với baseline | “no change” ở cả 3 window |
| AI Stupid Level | Combined khoảng 94 cộng trừ 0,3 ngày 07/11 | “holding steady” |
Giới hạn của tracker, không thấy thay đổi dưới 6,6 điểm và không đo session agent dài
LiveNerf có MDE thực tế 6,6 điểm trên mỗi window, tức không thấy được thay đổi nhỏ hơn con số đó. Đổi Opus 5 vào thay Opus 5.5 còn không phân biệt được ở tin cậy 99%, trong khi tracker chỉ đo câu hỏi đơn lượt có đáp án cố định, không đo session agent dài, nhiều tool, nhiều context, đúng thứ người khiếu nại mô tả. Panel có 8 answer key có vẻ sai và 30 câu mơ hồ, còn window 3 kết thúc ngày 02/11 nên chưa bao phủ mốc 03/11.
NerfBench thì test mới nhất đã 24 ngày tuổi tính đến 09/11, không có số liệu nào sau đợt 19/10 và 03/11, task private, chạy qua API chứ không phải Claude Code subscription. Điểm “Power” còn trộn cả output tokens lẫn cost vào. Nói cách khác, phía phản bác bác được cáo buộc yếu đi trên diện rộng, nhưng chưa bác được cáo buộc có thay đổi ở tầng serving hoặc harness ảnh hưởng session agent dài. Nên cả hai phe đều có thể đúng cùng lúc, tracker chưa khép được vụ này, mình nghi cái bẫy nằm ở effort.
Cái bẫy effort medium mặc định, Opus 5.5 chạy medium trong khi Opus 5 chạy high
Giữa hai phe đang cãi nhau về weights có đổi hay không, có một cái bẫy đã được document rõ ràng mà nhiều người đang mắc phải, nó giải thích được một phần lớn cảm giác “nhẹ hơn” ngay từ lúc launch, nên anh em kiểm tra cái bẫy này trước khi kết luận model bị nerf. Mình nhắc vậy vì nó kiểm tra được trong 5 phút và không tốn một xu API nào.
Caption: Ảnh tự tạo minh họa màn hình cài đặt với các công tắc mức effort, chữ trên màn hình đã làm mờ vì chỉ gợi ý giao diện, không phải ảnh chụp settings thật (ảnh tự tạo).
Default medium, effortLevel top-level không ăn thua với Opus 5.5, benchmark launch chạy ở max
Có 5 mức effort là low, medium, high, xhigh và max. Mảnh ghép thứ nhất là Opus 5.5 và Haiku 5.5 default medium trên API và Claude Code, trong khi Opus 5 default high, Opus 4.7 default xhigh, các model còn lại default high.
| Mảnh ghép effort | Nội dung đã document |
|---|---|
| Default medium | Opus 5.5 và Haiku 5.5 default medium, Opus 5 default high, Opus 4.7 default xhigh, các model còn lại default high |
Top-level effortLevel không áp dụng cho Opus 5.5 |
Thứ tự chọn effort trong Claude Code: (1) CLAUDE_CODE_EFFORT_LEVEL, (2) /effort hoặc /model picker trong session, (3) flag --effort, (4) settings gồm level lưu theo model hoặc key effortLevel, (5) default của model là medium với Opus 5.5, top-level effortLevel trong user settings vẫn áp dụng cho Opus 5 trở về trước, top-level trong project, local hoặc managed settings, hoặc qua --settings, thì áp dụng cho mọi model |
| Launch benchmark chạy ở max | Footnote trang launch ghi mọi kết quả Opus 5.5 dùng adaptive thinking ở max effort, Opus 5.5 “tends to think more per turn than Opus 5” ở cùng level |
| Confounder cùng tuần 03/11 | Claude Code 2.1.317 ra mắt 02/11 lúc 18:57 ET, thay đổi cách effort của subagent và teammate. 2.1.318 ra mắt 03/11 lúc 16:55 ET, gỡ fix giữ thinking cũ khi resume conversation. Game-remake prompt 2 câu push 27/10 dưới tên “tengu_heron_brook”, Addy Osmani xác nhận có chủ ý ngày 30/10. Safety fallback cyber reroute sang Opus 4.8, biology reroute sang Opus 5, session ở lại model fallback cho đến khi chạy /model.Cùng tuần đó còn có vụ Goldman Sachs thu hồi Claude Code |
Medium thua high bao nhiêu điểm, đã có số đo từ 4 nguồn
SWE-bench Pro subset 478 bài do nội bộ Anthropic đo thì medium thấp hơn high khoảng 2,5 điểm với khoảng 70% chi phí. LiveNerf validation thì medium thấp hơn 4,2 cộng trừ 3,9 điểm và ít hơn 26% output tokens, Artificial Analysis Index thì medium 51 so với high 54, còn AI Coding Daily thì medium 65,28 so với high 67,26 trên 70 điểm, mình hình dung medium với high như chạy xe để số thấp, máy vẫn chạy mà ì hơn khi lên đúng số.
SlopCodeBench tháng 10/2026 thì xhigh tốn 817,04 USD so với 193,47 USD ở medium, tức gấp 4,22 lần, mà pass chỉ 25 so với 28 trên 196 checkpoint. Nhưng mỗi setting chỉ chạy 1 lần nên chưa dùng làm kết luận chắc chắn được, cùng tuần đó, Claude Code còn dính vụ Claude Code từng lộ email qua user-agent nữa.
| Mức effort | Chất lượng đo được so với high | Chi phí hoặc tokens so với high |
|---|---|---|
| Medium | SWE-bench Pro thấp hơn khoảng 2,5 điểm, LiveNerf thấp hơn 4,2 cộng trừ 3,9 điểm, Artificial Analysis Index 51 so với 54, AI Coding Daily 65,28 so với 67,26 | Khoảng 70% chi phí trên SWE-bench Pro, ít hơn 26% output tokens trên LiveNerf |
| High | Mốc so sánh | Mốc so sánh |
| Xhigh | Case study của Melaugh, cùng bug thì xhigh sửa xong trong 5 turns với 0,85 USD | Case study của Melaugh, high tốn 160 turns và 13,00 USD trong 3 giờ mà thất bại |
Effort giải thích được cảm giác nhẹ hơn từ launch, nhưng không giải thích được bước nhảy 3/11
Effort giải thích được cảm giác “nhẹ hơn” từ lúc launch, vì nhiều người tưởng chạy high nhưng thực ra chạy medium. Nhưng effort không giải thích được bước nhảy đột ngột ngày 3/11 trong dữ liệu của Melaugh, vì ông so sánh cùng high effort ở cả hai phía của mốc 03/11. Effort cũng không giải thích được #105112, vì tăng effort không cứu được, high thì corrected answers tăng từ 5,4% lên 26,6%, còn max thì 50% câu trả lời bị sửa. Grok ngày 05/11 tóm tắt cùng hướng, theo bài phân tích ngày 09/11/2026 tường thuật lại: riêng chuyện default medium đã giải thích được phần lớn cảm giác “dumber” đó.
Thinking tokens giảm 36% chưa chắc model suy luận kém đi
Đây là điểm kỹ thuật khó nhất của vụ này, và cũng là chỗ hai phe cãi nhau nhiều nhất. Thế nên mục này mình tạm chỉ nói đúng một khái niệm, text trong thinking block thực ra là cái gì.
Text trong thinking block chỉ là bản tóm tắt do một model khác viết
Docs của Anthropic về thinking, qua bài phân tích ngày 09/11/2026 tường thuật lại, nói text trong thinking block “is never the raw chain of thought”, và “summarization is processed by a different model from the one you target in your requests”. Trên Opus 5.5 thì API default display: "omitted", còn follow-up request chỉ xử lý tool result có thể skip thinking “including at xhigh and max”, và “no level guarantees a thinking block on every request”. Thay đổi wording là bằng chứng về summarizer đổi, chưa phải bằng chứng về weights đổi.
Caption: Ảnh tự tạo minh họa cuốn sổ ghi chú mỏng với vài dòng tóm tắt đặt cạnh khối não thủy tinh phát sáng phức tạp, gợi ý bản tóm tắt ngắn khác với suy nghĩ thật của model (ảnh tự tạo).
Đếm từ trong biên bản họp khác với đo người trong họp suy nghĩ kỹ tới đâu
Ví dụ đời thường thôi, vì đếm từ trong bản tóm tắt khác hẳn với đo não của model. Mình hay nghĩ tới cảnh anh em đếm số chữ trong biên bản tóm tắt cuộc họp rồi kết luận người trong cuộc họp suy nghĩ kỹ tới đâu, trong khi biên bản đó do một thư ký khác viết lại. Thư ký đổi cách viết thì biên bản dài ngắn khác nhau ngay, còn người trong họp có khi vẫn suy nghĩ y như cũ.
Số thinking token của Melaugh là billed tokens hay ước tính từ summary text
Câu hỏi này mình cứ để mở ở đúng chỗ của nó, vì các post của Melaugh không nói rõ số token này là billed tokens hay ước tính từ summary text. Bài phân tích ngày 09/11/2026 chỉ ra đây là câu hỏi “decides a lot”.
Checklist tự kiểm tra 5 tới 20 phút trên máy mình trước khi kết luận
Tranh cãi trên mạng thì không hồi kết, nhưng máy của anh em thì có số đo được ngay, nên mục này cho anh em 5 tới 20 phút tự kiểm tra. Thứ tự trong checklist này quan trọng, vì kiểm tra effort trước khi đổ lỗi model là cách tránh mất tiền nhất trong vụ này.
Caption: Ảnh tự tạo minh họa lập trình viên kiểm tra checklist trên laptop, màn hình terminal với các dấu tick xanh, chữ đã làm mờ (ảnh tự tạo, không phải screenshot thật).
3 thao tác kiểm tra effort và version trong 5 phút
Làm theo ngay:
- Bước một, chạy
/effort status, nếu tưởng high mà ra medium thì đã tìm ra nghi phạm đầu tiên. - Bước hai, mở
~/.claude/settings.json, nếu chỉ có top-level"effortLevel": "high"thì nó không áp dụng cho Opus 5.5, nên chọn lại level bằng/effortkhi đang ở Opus 5.5. - Bước ba, chạy
claude --version, từ 2.1.317 trở lên thì kiểm tra effort của subagent, vì subagent chạy model khác sẽ dùng effort đã lưu của model đó hoặc default của nó.
Chạy lại task cũ ở high so với xhigh và kiểm tra model fallback sang Opus 4.8 hoặc Opus 5
Bước bốn là chạy lại một task đã có test chứng minh, ở high so với xhigh, từ cùng commit. Mình ghi pass hoặc fail, thời gian và chi phí, dùng mẫu lệnh CLAUDE_CODE_EFFORT_LEVEL=high claude -p "<task>". Bước năm là kiểm tra /model xem session có đang bị fallback sang Opus 4.8 hoặc Opus 5 không, vì safety fallback cyber reroute sang Opus 4.8, biology reroute sang Opus 5, và session ở lại model fallback cho đến khi chạy /model.
| Bước checklist | Làm gì | Nhìn vào con số nào |
|---|---|---|
| 1 | Chạy /effort status |
Tưởng high mà ra medium thì đã tìm ra nghi phạm đầu tiên |
| 2 | Mở ~/.claude/settings.json |
Chỉ có top-level "effortLevel": "high" thì nó không áp dụng cho Opus 5.5, chọn lại bằng /effort khi đang ở Opus 5.5 |
| 3 | Chạy claude --version |
Từ 2.1.317 trở lên thì kiểm tra effort của subagent và teammate |
| 4 | Chạy lại 1 task đã giải xong có test, ở high so với xhigh, từ cùng commit | Ghi pass hoặc fail, thời gian, chi phí, dùng CLAUDE_CODE_EFFORT_LEVEL=high claude -p "<task>" làm mẫu |
| 5 | Kiểm tra /model |
Session có đang bị fallback sang Opus 4.8 hoặc Opus 5 không |
| 6 | Nếu vẫn thấy giảm sau khi đã ghim version và effort | Viết báo cáo có số liệu và ngày tháng như issue #105112, thay vì đăng cảm nhận chung chung, đánh giá bằng test pass hoặc fail, không đánh giá bằng wording, xem thêm AI chứng minh giả thuyết Aaronson-Ambainis |
Tách 3 vấn đề hay bị trộn vào chữ nerfed, chất lượng, limit drain, refusal
Ba vấn đề này kiểm tra khác nhau nên không được gộp chung thành một chữ “nerfed” rồi kết luận chung. Chất lượng câu trả lời đo bằng task có test và tỉ lệ bị sửa, limit drain đo bằng usage panel và meter, refusal đo bằng task hợp lệ bị từ chối.
| Vấn đề hay bị trộn vào chữ “nerfed” | Kiểm tra bằng gì | Ví dụ có số liệu |
|---|---|---|
| Chất lượng câu trả lời | Task có test và tỉ lệ câu trả lời bị sửa như #105112 | Corrected answers 5,2% lên 25,4% sau 19/10 |
| Limit drain nhanh | Usage panel và meter | Post viral ngày 20/10 với hơn 700.000 lượt xem, screenshot Usage panel ghi session limit 95% used và weekly 41% used, thực chất là khiếu nại về limit, issue #103376 weekly meter từ 0% lên 54% trong 22 giờ với cùng token volume mà tuần trước mất 4,4 ngày |
| Refusal tăng do safeguard và game prompt | Task hợp lệ bị từ chối | Game-remake prompt 2 câu push ngày 27/10 dưới tên “tengu_heron_brook”, Addy Osmani xác nhận có chủ ý ngày 30/10, cyber safeguard có 68 issue từ 01/10 và 65 vẫn mở |
Anthropic im lặng, còn anh em thì tự đo được tới đâu
Sau khi đi qua cả hai phía, effort, và checklist tự kiểm tra, mình xếp từng claim vào đúng tầng của nó. Rồi mình mới nói tới sự im lặng của Anthropic và tiền lệ thừa nhận muộn.
| Tầng | Claim | Bằng chứng tính đến sáng 09/11/2026 |
|---|---|---|
| [ĐÃ KIỂM CHỨNG] | Thay đổi wording của thinking summary ngày 3/11 là có thật | Cả Melaugh và Theo Browne đều thấy, các account chuyển đổi rải rác 30/10 tới 04/11 |
| [ĐÃ KIỂM CHỨNG] | Effort default medium và bẫy effortLevel là có thật |
Docs Anthropic ghi Opus 5.5 default medium, Opus 5 default high, top-level effortLevel không áp dụng cho Opus 5.5 |
| [ĐÃ KIỂM CHỨNG] | Tracker không phát hiện giảm sút trên task cố định | LiveNerf 3 window “no change”, NerfBench 105,8%, tokenusage.dev 100,0 ngày 08/11 |
| [CÁO BUỘC CÓ SỐ LIỆU, CHƯA XÁC NHẬN ĐỘC LẬP] | Thinking tokens giảm 36% và crash tăng | Melaugh, median 84 xuống 54, crash 100 lên 147, chưa rõ billed tokens hay ước tính từ summary text, raw data chưa công bố |
| [CÁO BUỘC CÓ SỐ LIỆU, CHƯA XÁC NHẬN ĐỘC LẬP] | Corrected answers tăng 5,2% lên 25,4% sau 19/10 | Issue #105112 và #105477, một người và một workflow, Anthropic chưa trả lời |
| [Ý KIẾN/SUY ĐOÁN] | Anthropic “quantized model / reallocate DC capacity” | ricardobeat trên HN, không bằng chứng |
| [Ý KIẾN/SUY ĐOÁN] | “Fable 5.5 sắp ra nên nerf 5.5” | Ask HN, không bằng chứng |
Caption: Ảnh tự tạo minh họa người dùng trước ngã ba đường lúc chạng vạng, một hướng ánh sáng ấm áp, một hướng ánh sáng xanh lạnh, gợi hai cách đọc vụ việc (ảnh tự tạo).
Anthropic vẫn im lặng tính đến sáng 09/11/2026 giờ ET, không có phản hồi chính thức nào về vụ 03/11. Mình đọc vậy thì thấy im lặng không bằng thừa nhận, cũng không bằng phủ nhận.
| Tiền lệ Anthropic thừa nhận regression | Nội dung |
|---|---|
| Postmortem tháng 09/2025 | 3 infrastructure bug, tuyên bố “We never reduce model quality due to demand, time of day, or server load” |
| Postmortem 23/04/2026 | 3 thay đổi harness: 04/03 default effort high xuống medium, gọi là “the wrong tradeoff”, revert 07/04, 26/03 bug cache xóa thinking cũ mỗi turn, fix 10/04, 16/04 system prompt giới hạn verbosity 25 từ giữa tool call và 100 từ response cuối, làm giảm 3% coding quality, revert 20/04, API và inference layer không bị ảnh hưởng |
| Dữ liệu bên ngoài thúc đẩy điều tra lần trước | AMD issue #42796 của Stella Laurenzo, 6.852 session, read-to-edit ratio từ 6,6 xuống 2,0, median thinking depth giảm 67%, từ khoảng 2.200 xuống khoảng 720 ký tự |
| Kết luận từ tiền lệ | Cả 2 lần nguyên nhân đều nằm ở harness và serving chứ không nằm ở weights, Anthropic chỉ thừa nhận sau nhiều tuần user báo cáo có số liệu |
| Boris Cherny ngày 11/10 | Nói “no changes on our end” về usage limit Max 20x, chứ không phải chất lượng model, nên không trích câu đó như phủ nhận nerf |
Vấn đề đáng bàn hơn cả vụ 3/11 nằm ở cấu trúc, vì người dùng đang thuê một “moving target” không có changelog hành vi, model ID claude-opus-5-5 giữ nguyên trong khi router, classifier, summarizer, system prompt và effort mapping đều có thể đổi phía server. Docs Anthropic thừa nhận infrastructure update thỉnh thoảng “produce minor differences in observable behavior”. Mình thấy giống thuê thợ mà không dặn kỹ, làm xong mới biết mình muốn khác. Thế nên anh em nào đang dùng Opus 5.5 mỗi ngày thì chia sẻ trải nghiệm thật có số liệu ở dưới, ghi rõ effort đang chạy và task test pass hay fail, để cộng đồng có thêm một điểm đo thật.
Nguồn tham khảo
- Post X của Shane Melaugh ngày 07/11/2026: https://twitter.com/shanemelaugh/status/2119192075505893695
- Hacker News thread 50422069: https://news.ycombinator.com/item?id=50422069
- LiveNerf, repo GitHub ninjahawk/livenerf: https://github.com/ninjahawk/livenerf
- BridgeBench NerfBench, Claude Opus 5.5: https://www.bridgebench.ai/nerf-bench/claude-opus-5-5
- Bài Medium của Chinmay Shringi ngày 09/11/2026: https://medium.com/@chinmayshringi4/opus-5-5-nerfed-your-saved-effortlevel-does-not-apply-to-it-check-that-before-you-blame-november-3-fc03cd80168b
- i10x, Claude Opus 5.5 Nerfed? Complaints vs. Tracker Data: https://i10x.ai/news/claude-opus-5-5-nerf-complaints-data
- GitHub issue #105112: https://github.com/anthropics/claude-code/issues/105112
- GitHub issue #105477: https://github.com/anthropics/claude-code/issues/105477
- tokenusage.dev Nerf Watch: https://tokenusage.dev/nerfwatch
- ailetter, Is Opus 5.5 really dumber?: https://ailetter.ai.kr/en/d/2026-11-09/1
- ailately, Claude Coders Say Opus 5.5 Changed Overnight: https://ailately.com/rn
- readmodelmag, Benchmarks say Opus 5.5 is fine. Devs say it ate a crayon.: https://readmodelmag.com/stories/opus-nerf-tracker
- cellcog, Is Claude Opus 5.5 Nerfed? What the Trackers Measured: https://cellcog.ai/blog/is-claude-opus-5-5-nerfed/
- digintoai, Did Claude Opus 5.5 Get Nerfed?: https://digintoai.com/en/articles/claude-opus-5-5-nerfed
- blog.laozhang.ai, Is Opus 5.5 Nerfed? No Confirmed Drop Yet; Check Effort First: https://blog.laozhang.ai/en/posts/claude-opus-5-5-nerfed

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Claude Fable 5.2 ra mắt ngày 09/11, rẻ hơn 20% mà vẫn đắt gấp đôi Opus 5.5, còn Mythos chỉ mở cho tổ chức được duyệt
- Google ra TPU 8tx và TPU 8i Max ngày 09/11/2026, chưa mua được gì hôm nay nhưng đáng theo dõi
- ChatGPT Desktop bị tố forward SSH agent sang máy remote, key của anh em có bị lấy mất không
[…] benchmark đã đổi giữa các lần ra mắt nên khó đối chiếu ngang hàng, kèm theo nghi ngờ Opus 5.5 bị làm suy yếu, mà mình ghi rõ đây chỉ là nghi ngờ chưa có bằng chứng, không khẳng […]