📑 Mục lục chi tiết bài viết (27 mục)
- Gemini Decision 1 trả xác suất thay vì viết chữ, khác gọi Gemini thường ở chỗ nào
- Một forward pass chấm hết các lựa chọn, code rẽ nhánh thẳng trên con số trả về
- Ba loại câu hỏi noul, choice và score trộn chung trong một request tối đa 1.000 câu hỏi
- Làn sóng decision model từ Jev ngày 15/09 tới Google ngày 11/11
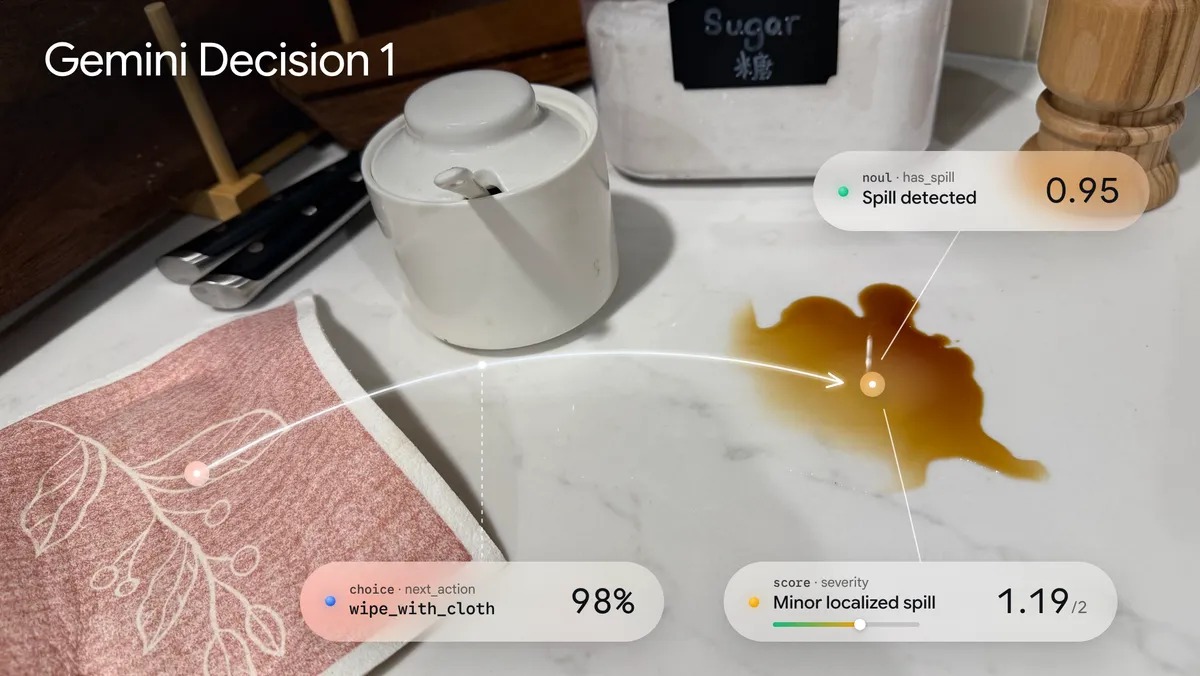
- Ví dụ quầy bếp của Google, vết bẩn phát hiện 0,95 và dọn dẹp 98 phần trăm
- Giá 0,10 đô cho 1 triệu token input và phép tính 50 đô cho 1 triệu lần phân loại
- Shared input tính tiền một lần, gộp 50 check chỉ tốn khoảng 4.000 token thay vì 102.000 token
- Free tier 200 request mỗi phút và dữ liệu free tier dùng để cải thiện sản phẩm Google
- Phép tính 1 triệu lần phân loại 500 token của CellCog tốn 50 đô
- Latency 150 đến 250 mili giây hãng công bố và con số 0,34 giây OpenRouter đo được
- Điều kiện hãng đo, input tới 16K token và 1 tới 100 câu hỏi, hãng không đưa số cho 1.000 câu hỏi
- OpenRouter đo thực tế P50 0,34 giây qua provider Google AI Studio
- Nexus đo OpenAI Decisions và Jev, median ngang nhau nhưng p99 chênh 2,8 lần
- Đắt hơn Jev 2,4 lần, Gemini Decision 1 đổi lại được 5 loại input và calibration tốt hơn
- So giá và đầu vào 4 model, Jev rẻ nhất còn Decision 1 gom đủ 5 loại input
- Benchmark hãng tự đo, Decision 1 đứng đầu 7 trên 9 test và Jev thắng Mind2Web và When2Call
- Tuyên bố rẻ hơn gần 5 lần Gemini 3.5 Flash-Lite chỉ so với Flash-Lite qua Interactions API
- Làm theo ngay hôm nay với SDK google-genai 3.2 trở lên và code mẫu chính thức của Google
- Code mẫu chính thức với client.decisions.create trên Gemini API v1beta
- Tích hợp OpenRouter, LangChain, Vercel và LiteLLM đang triển khai, chưa phải tất cả đã xong
- Gemini in Google Cloud ghi coming soon và những thứ chưa có như caching hay Batch API
- Những việc Gemini Decision 1 không nên làm và các bẫy Google tự ghi trong guide
- Câu hỏi choice luôn phải chọn một đáp án dù không đáp án nào đúng
- Input người dùng tự bênh vực cho phân loại của chính nó
- Ngưỡng confidence tự đặt từ traffic của mình và giữ người check cho việc high-stakes như thanh toán
- Những việc guide chỉ sang Interactions API, sinh text, suy luận nhiều bước và tool call có argument
- Google đến sau 2 tháng nhưng gom đủ 5 loại input, chọn Jev hay Decision 1 tùy việc cần làm
Nghe thì hay, cơ mà Google ra mắt Gemini Decision 1 ngày 11/11/2026, model trả xác suất cho từng lựa chọn thay vì viết chữ, giá 0,10 đô cho 1 triệu token input và tối đa 1.000 câu hỏi mỗi request. Google đến sau Jev hai tháng nhưng gom 5 loại input text, ảnh, audio, video, PDF vào một decision API. Bài này mình bóc giá, tốc độ, benchmark và bẫy dùng, ghi rõ số nào hãng tự đo.
Tóm tắt nhanh: Giá 0,10 đô cho 1 triệu token input, 0 đô token output. Latency hãng công bố 150-250 mili giây end-to-end. Tối đa 1.000 câu hỏi trong một request. Nhận đủ 5 loại input là text, ảnh, audio, video và PDF trong một input chung. Ra mắt ngày 11/11/2026 qua Gemini API v1beta, model
gemini-decision-1.
Gemini Decision 1 trả xác suất thay vì viết chữ, khác gọi Gemini thường ở chỗ nào
Gọi Gemini thường là xin một đoạn chữ rồi tự parse ngược thành giá trị có cấu trúc, còn Decision 1 bỏ luôn bước viết chữ đó, chấm điểm các lựa chọn có sẵn trong một forward pass rồi trả con số để code rẽ nhánh thẳng, và mình thấy cái khác biệt đáng tiền nhất nằm đúng ở chỗ bỏ bước viết chữ này. Nói ngay từ đầu là chưa ai trong các nguồn đã đọc gọi thử Decision 1 thật, CellCog ghi rõ “We did not call the model”.
Một forward pass chấm hết các lựa chọn, code rẽ nhánh thẳng trên con số trả về
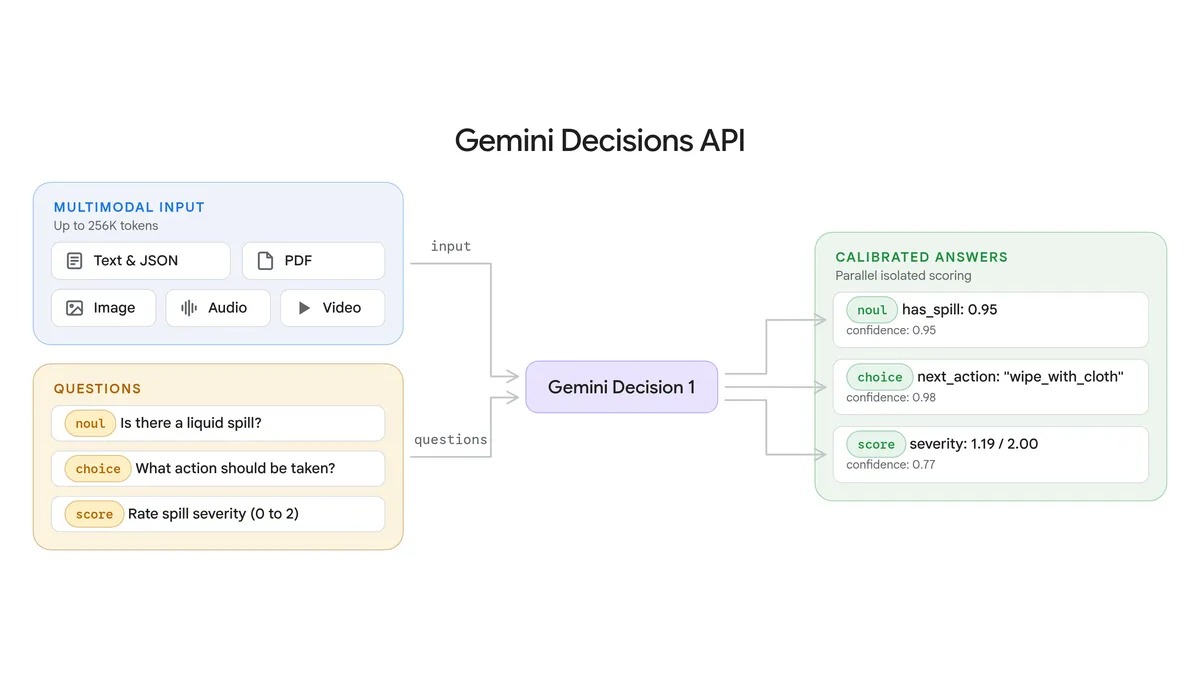
Decision 1 chấm điểm các lựa chọn có sẵn trong một forward pass duy nhất, không sinh text token-by-token, trả xác suất và confidence score từ 0 tới 1 để code rẽ nhánh và routing trực tiếp mà không cần parse prose. Bài toán nhắm tới là các quyết định nhỏ lặp lại hàng nghìn lần bên trong agent. Các câu hỏi trong một request độc lập với nhau, không nhìn thấy nhau, thêm hoặc bớt một câu cũng không đổi đáp án các câu khác.
Ba loại câu hỏi noul, choice và score trộn chung trong một request tối đa 1.000 câu hỏi
Ba loại câu hỏi gồm noul là yes/no với xác suất 0,01-0,99 kèm mô tả true/false, choice là 2-255 lựa chọn trả người thắng và xác suất chuẩn hóa từng ứng viên, score là rubric có thứ tự từ 0 với 2-255 mức, trả điểm trung bình có trọng số và xác suất từng mức. Cả ba loại trộn chung được trong một request, tối đa 1.000 câu hỏi độc lập trong một lần gọi, trong khi OpenAI Decisions API tối đa 400 câu hỏi. Shared input đa phương thức tối đa 262.144 token, inline data tối đa 100 MB mỗi request, PDF tối đa 50 MB.
Làn sóng decision model từ Jev ngày 15/09 tới Google ngày 11/11
| Ngày | Diễn biến |
|---|---|
| 15/09/2026 | Jev của TypeSafe mở đầu làn sóng, bản early access giá 0,042 đô |
| 29/09/2026 | OpenAI công bố Decisions API tại DevDay, chạy trên GPT-6 Luna |
| 09/10/2026 | Microsoft ra Microsoft-Decision-1, giá 0,042 đô, xây trên Qwen của Alibaba |
| 22/10/2026 | OpenAI Decisions API GA, chỉ chạy gpt-6-luna |
| 11/11/2026 | Google ra mắt lúc 18:00 UTC qua blog của Min Choi và Felix Yu, Sundar Pichai đăng trên X lúc 18:15 UTC |
Google là hãng lớn đến sau cùng nhưng là hãng đầu tiên gom đủ 5 loại input vào một decision API, IncreasePosts trên Hacker News nhắc OpenAI mất 2 tuần sau Jev mới ra decision endpoint còn Google mất tới 2 tháng, anh em muốn hiểu Jev đã mở đường thế nào thì đọc bài Jev nhờ Opus chấm lại ca khó. (Bình luận Hacker News ghi lại qua brief, chưa xác minh full thread do fetch lỗi 419.)
Ví dụ quầy bếp của Google, vết bẩn phát hiện 0,95 và dọn dẹp 98 phần trăm
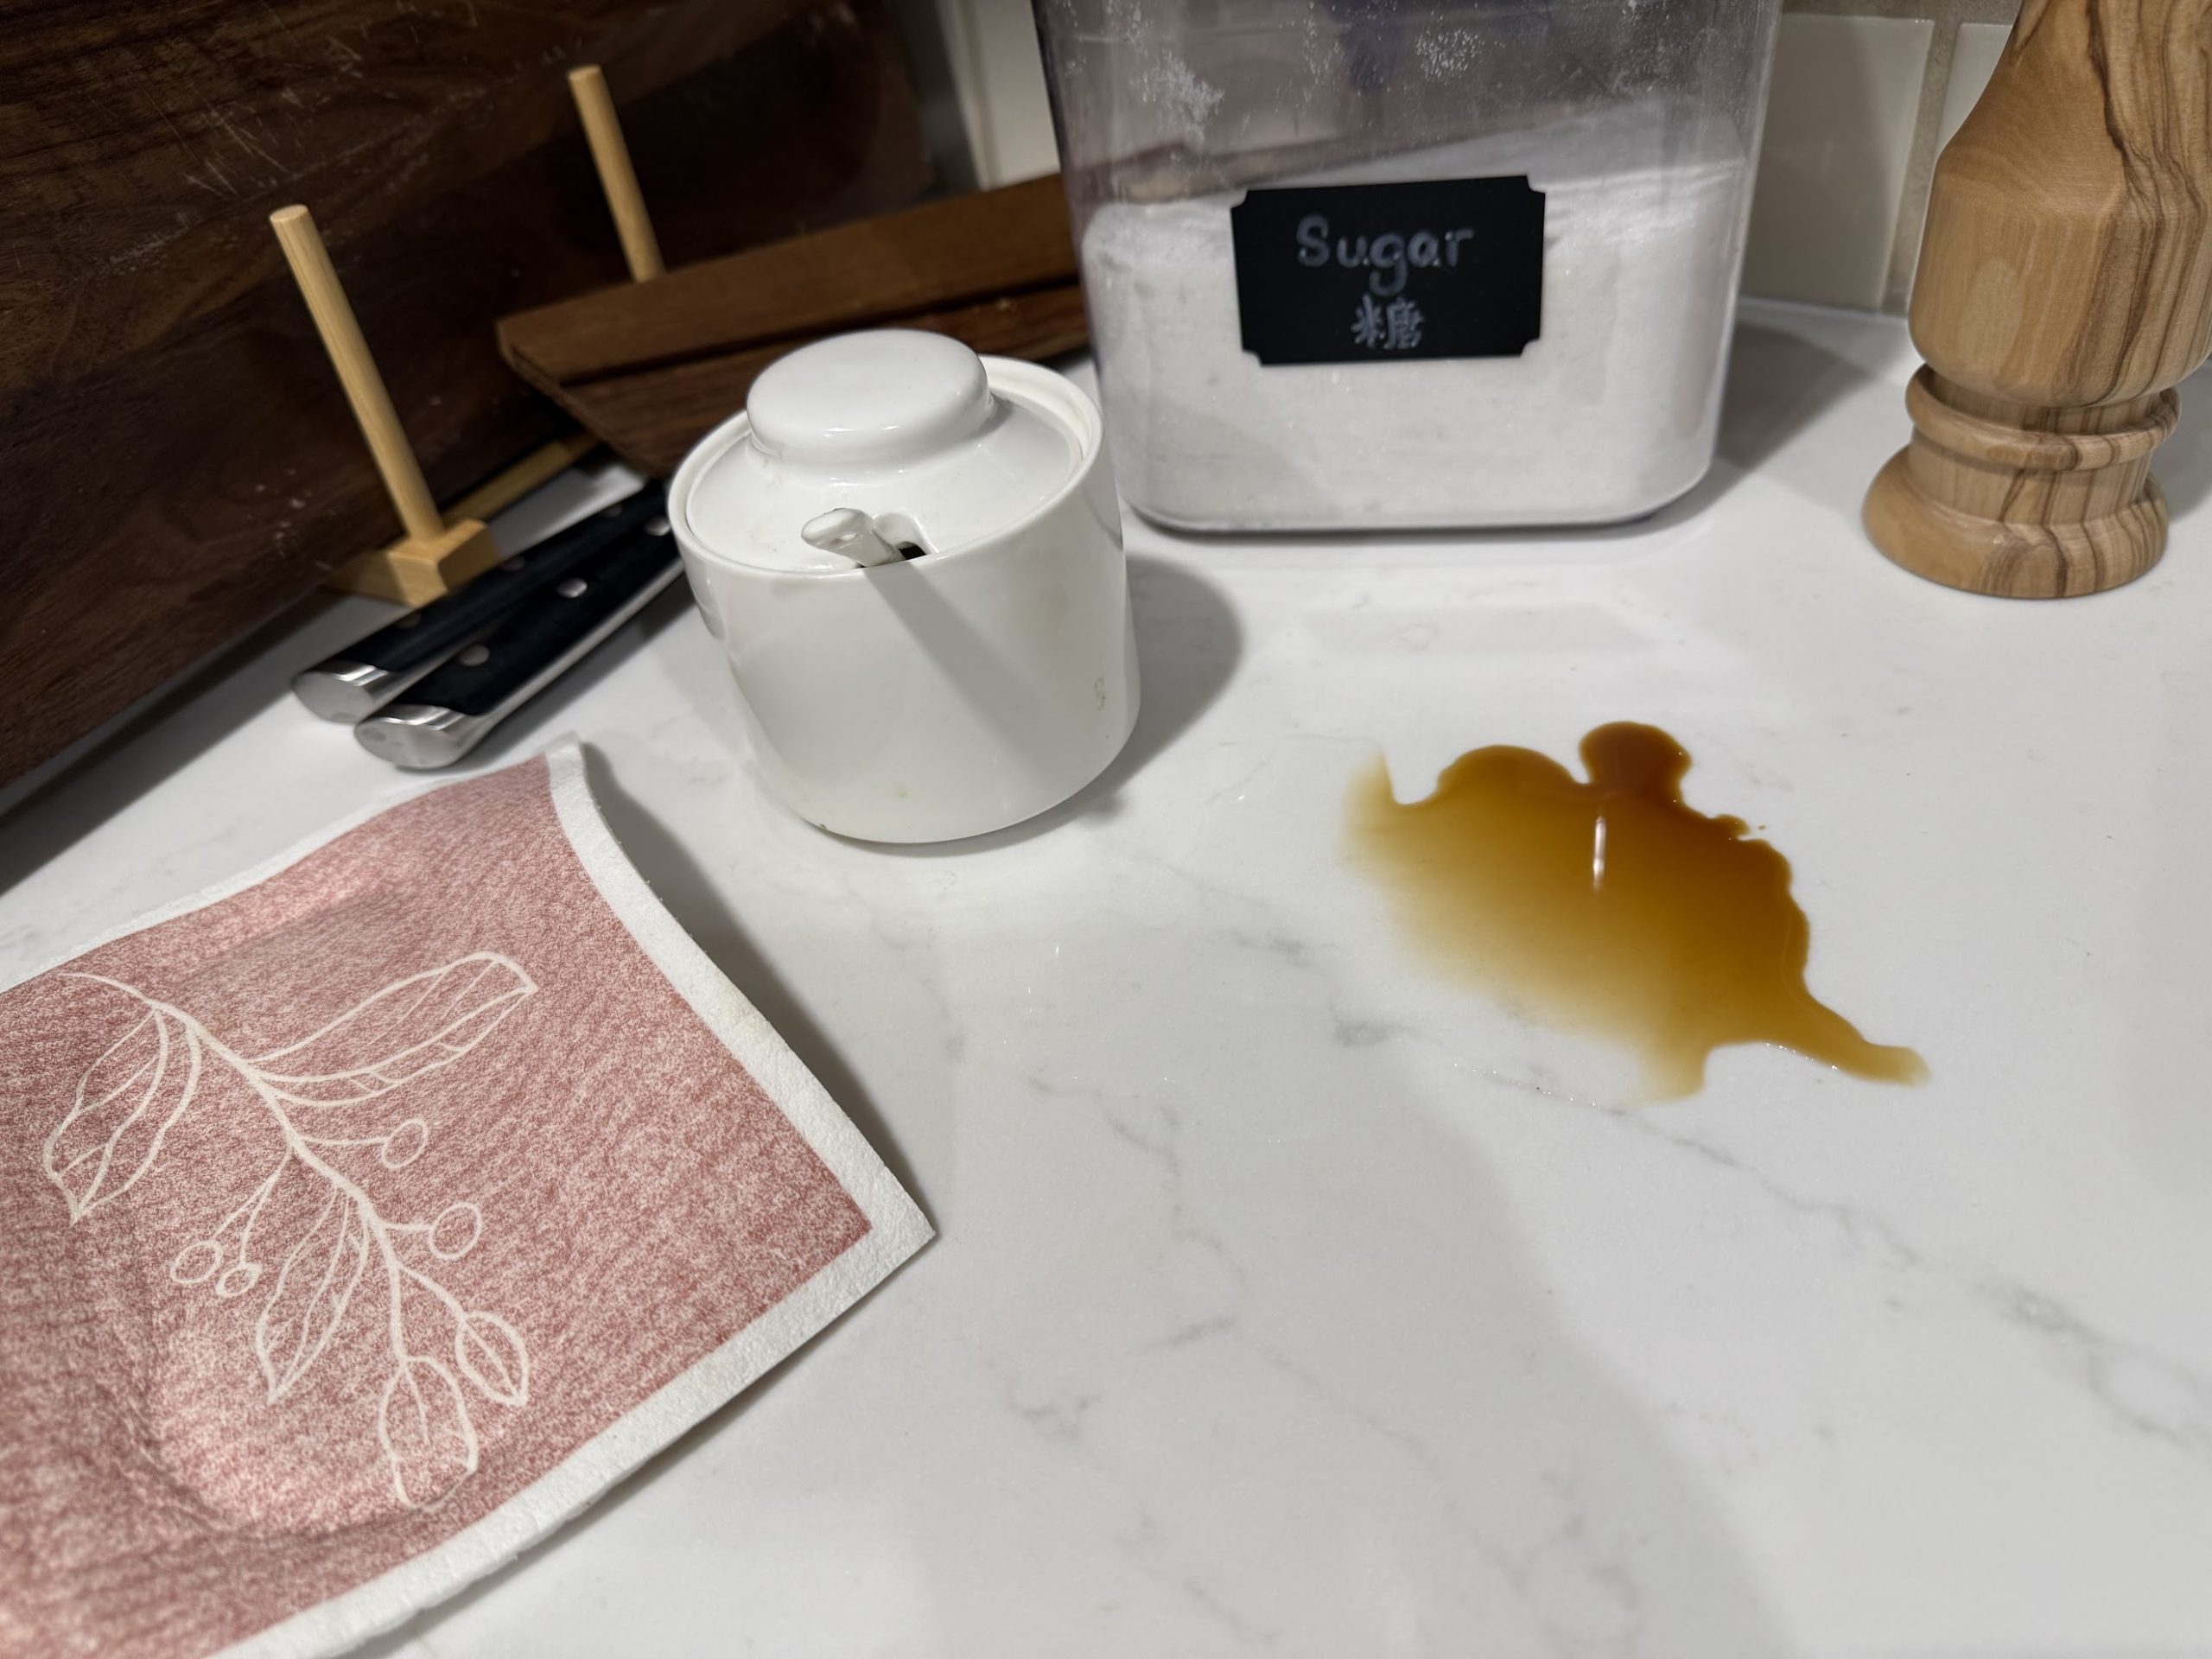
Ví dụ chính thức trong blog Google dùng ảnh spill.jpg kèm text “Breakroom counter check before the 9 AM client meeting”, với 3 câu hỏi has_spill dạng noul, next_action dạng choice, severity dạng score 3 mức 0-2. Theo The Decoder và AI Frontier Post thì confidence phát hiện vết bẩn là 0,95, chọn hành động dọn dẹp 98%, chấm mức độ 1,19 trên thang 0-2. Ví dụ này là minh họa của hãng, mình chưa chạy thử, việc thật của dev Việt nên là routing, chấm bài và kiểm duyệt trên dữ liệu của mình.
Giá 0,10 đô cho 1 triệu token input và phép tính 50 đô cho 1 triệu lần phân loại
Giá niêm yết 0,10 đô nhìn qua thì bằng OpenAI và gấp 2,4 lần Jev, nhưng tiền thật trả cho cùng một việc lại nằm ở cách tính shared input. Mình chú ý là giá niêm yết chỉ là nửa câu chuyện, tạm gác con số 0,10 đô sang một bên rồi nhìn phép tính dưới đây sẽ rõ tiền thật nằm ở đâu.
Shared input tính tiền một lần, gộp 50 check chỉ tốn khoảng 4.000 token thay vì 102.000 token
Mình đối chiếu giá niêm yết thì thấy Decision 1 là 0,10 đô cho 1 triệu token input với 0 đô token output, ngang giá OpenAI Decisions API, còn Jev và Microsoft-Decision-1 cùng ở mức 0,042 đô nên Decision 1 đắt gấp khoảng 2,4 lần hai model này. Shared input chỉ tính tiền một lần mỗi request dù hỏi bao nhiêu câu, mỗi câu hỏi chỉ cộng thêm token hướng dẫn và tiêu chí của nó, không phí thinking token hay phí riêng phiên âm audio và OCR.
CellCog lấy ví dụ tài liệu 2.000 token cộng 50 check nhân 40 token thì chỉ khoảng 4.000 token trong một request, so với 102.000 token nếu tách 50 request riêng, đây là phép tính của CellCog.
Free tier 200 request mỗi phút và dữ liệu free tier dùng để cải thiện sản phẩm Google
| Tier | Request mỗi phút | Token mỗi phút | Request mỗi ngày |
|---|---|---|---|
| Free | 200 | 50.000 | 10.000 |
| Tier 1 | 1.500 | 1.000.000 | 50.000 |
| Tier 2 | 5.000 | 4.000.000 | không giới hạn |
| Tier 3 | 15.000 | 10.000.000 | không giới hạn |
Free tier nằm trong Google AI Studio để prototype, dữ liệu free tier được dùng để cải thiện sản phẩm Google, còn dữ liệu paid tier thì không, nên cứ thử bằng dữ liệu mẫu trước.
Phép tính 1 triệu lần phân loại 500 token của CellCog tốn 50 đô
CellCog tính 1 triệu lần phân loại, mỗi lần 500 token, thì ngốn 500 triệu token, tức 50 đô ở tier trả phí, đây là phép tính của CellCog.
Mình vọc lại số Nexus với Beetl thì thấy giá niêm yết chưa phải giá thực trả, Nexus đo thực tế thấy Decisions API cộng thêm khoảng 144 token cho mỗi câu hỏi, nên với 8 câu hỏi thì đắt gấp 6,8 lần Jev, còn Beetl đo thực tế thấy đắt gấp 3,5 lần cho cùng request, một phần vì Decisions API đếm token gấp khoảng 1,5 lần.
Latency 150 đến 250 mili giây hãng công bố và con số 0,34 giây OpenRouter đo được
150-250 mili giây là con số mọi bài đều chép lại từ blog Google, nhưng con số thực đo duy nhất cho Decision 1 lại cao hơn hẳn. Mình thấy đây mới là chỗ đáng soi, vì số hãng công bố và số đo thật cách nhau khá xa, anh em đọc kỹ điều kiện đo rồi hãy tin.
Điều kiện hãng đo, input tới 16K token và 1 tới 100 câu hỏi, hãng không đưa số cho 1.000 câu hỏi
Số hãng công bố là median model compute 50-100 mili giây và end-to-end 150-250 mili giây, đo trên input đa phương thức tới 16K token với 1-100 câu hỏi mỗi request, latency gần như phẳng khi tăng số câu hỏi từ 1 tới 100, con số này Google tự đo, chưa kiểm chứng độc lập. Hãng không đưa số cho input lớn hơn 16K hay cho 1.000 câu hỏi, nên dev dùng input dài hoặc hỏi đủ 1.000 câu cần tự đo.
OpenRouter đo thực tế P50 0,34 giây qua provider Google AI Studio
Mình tra số OpenRouter đo thực tế thì P50 cho Gemini Decision 1 là 0,34 giây, cao hơn khoảng 90 tới 190 mili giây so với dải 150 tới 250 mili giây hãng công bố, và đây là số thực đo duy nhất cho Decision 1 tới thời điểm research ngày 12/11/2026. Trên OpenRouter chỉ có 1 provider là Google AI Studio, model chạy qua OpenRouter Decisions API. Top 5 app dùng Decision 1 tổng 39,4 triệu token trên tổng 2,16 tỉ token.
Nexus đo OpenAI Decisions và Jev, median ngang nhau nhưng p99 chênh 2,8 lần
Mình đọc số Nexus đo độc lập thì thấy OpenAI Decisions API và Jev median ngang nhau, 268 mili giây so với 269 mili giây, nhưng p99 là 1.469 mili giây so với 526 mili giây của Jev, chậm hơn 2,8 lần. 95 lần gọi Decisions vượt 1 giây trong khi Jev chỉ 3 lần, trên 6.624 lần gọi và 2.155 case.
Mình thấy Nexus đo giá thực tế cũng lệch theo hướng đó, Jev 0,11 đô cho 1.000 lần gọi, OpenAI Decisions 0,22 đô, và nhóm này tự nói rõ họ đang dùng Jev. Bài học là median hãng công bố chưa nói hết chuyện, phải đo thêm p99 và tỉ lệ lần gọi vượt 1 giây trên traffic của mình.
Đắt hơn Jev 2,4 lần, Gemini Decision 1 đổi lại được 5 loại input và calibration tốt hơn
Đắt hơn Jev 2,4 lần là câu hỏi cộng đồng hỏi nhiều nhất, nên mục này trả lời bằng bảng so sánh 4 model rồi bóc tiếp bảng benchmark 9 test của Google. Mình chú ý là đắt hay rẻ phải tính trên việc cụ thể, cơ mà cứ nhìn bảng dưới đây trước đã rồi hãy kết luận.
So giá và đầu vào 4 model, Jev rẻ nhất còn Decision 1 gom đủ 5 loại input
| Model | Giá niêm yết cho 1 triệu token input | Input nhận được | Tối đa câu hỏi mỗi request | Top-1 ECE |
|---|---|---|---|---|
| Gemini Decision 1 | 0,10 đô, 0 đô output | text, ảnh, audio, video, PDF | 1.000 | 0,0250 |
| Jev 1.14 | 0,042 đô, 0 đô output | chủ yếu text | không nêu trong nguồn đã đọc | 0,0494 |
| GPT-6 Luna qua OpenAI Decisions API | 0,10 đô, 0 đô output | text, ảnh, JSON | 400 | 0,0721 |
| Microsoft-Decision-1 | 0,042 đô | chỉ text | không nêu trong nguồn đã đọc | không có trong bảng của Google |
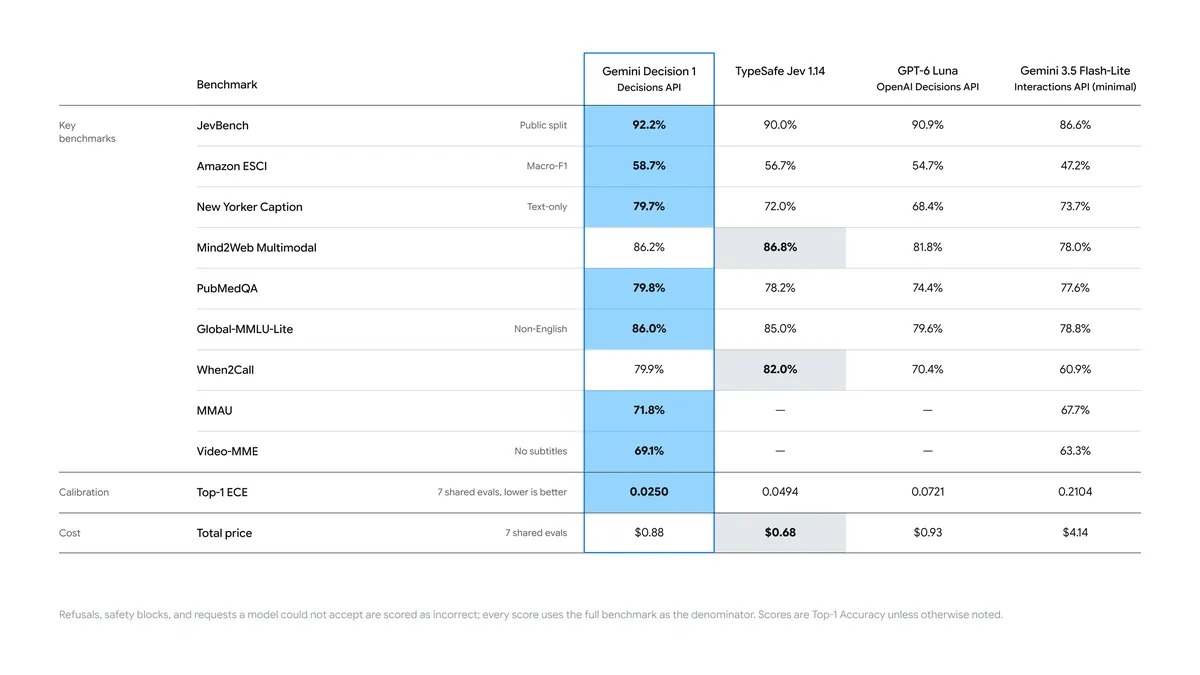
Mình tạm gom tổng chi phí 7 test chung lại thì Jev 1.14 rẻ nhất 0,68 đô, Decision 1 là 0,88 đô, Luna 0,93 đô, Flash-Lite 4,14 đô, con số này Google tự đo, chưa kiểm chứng độc lập.
Nexus và Beetl đo thực tế thì Decisions API đắt gấp 2,1-3,5 lần Jev cho cùng việc, một phần do đếm token nhiều hơn. Trên Hacker News, waximabbax thừa nhận Decision 1 đắt hơn một chút nhưng bù lại nhận được audio và video làm input, còn Reddit r/singularity có comment top nói đắt hơn Jev mà cải thiện chỉ thêm chút ít, một commenter khác vẫn chọn GPT-6 Luna của OpenAI, và cùng ngày 06/11 thì Salesforce cũng ra Koa Decisions cho người dùng Agentforce.
Benchmark hãng tự đo, Decision 1 đứng đầu 7 trên 9 test và Jev thắng Mind2Web và When2Call
| Test | Gemini Decision 1 | Jev 1.14 | GPT-6 Luna | Gemini 3.5 Flash-Lite |
|---|---|---|---|---|
| JevBench | 92,2% | 90,0% | 90,9% | 86,6% |
| Amazon ESCI Macro-F1 | 58,7% | 56,7% | 54,7% | 47,2% |
| New Yorker Caption | 79,7% | 72,0% | 68,4% | 73,7% |
| Mind2Web Multimodal | 86,2% | 86,8% | 81,8% | 78,0% |
| PubMedQA | 79,8% | 78,2% | 74,4% | 77,6% |
| Global-MMLU-Lite | 86,0% | 85,0% | 79,6% | 78,8% |
| When2Call | 79,9% | 82,0% | 70,4% | 60,9% |
| MMAU audio | 71,8% | không chạy | không chạy | 67,7% |
| Video-MME | 69,1% | không chạy | không chạy | 63,3% |
| Top-1 ECE | 0,0250 | 0,0494 | 0,0721 | 0,2104 |
| Tổng giá 7 test chung | 0,88 đô | 0,68 đô | 0,93 đô | 4,14 đô |
Nhắc lại: đây là số hãng tự đo. Mọi con số trong bảng trên đều chưa kiểm chứng độc lập. Decision 1 đứng đầu 7 test, Jev thắng Mind2Web Multimodal và When2Call, điểm thấp nhất của Decision 1 là 58,7% Macro-F1 ở Amazon ESCI.
Mình nghía qua hai test MMAU và Video-MME thì thấy không có điểm Jev và Luna vì hai model đó không nhận input audio và video. Microsoft-Decision-1 không có trong bảng của Google, refusal và safety block tính là đáp án sai. Calibration Top-1 ECE của Decision 1 là 0,0250, khoảng một nửa của Jev 1.14 là 0,0494, khoảng một phần ba của GPT-6 Luna là 0,0721, thấp hơn nhiều so với Flash-Lite là 0,2104, nghĩa là model nói 90% thì đáp án đúng khoảng 9 trên 10 lần.
Tuyên bố rẻ hơn gần 5 lần Gemini 3.5 Flash-Lite chỉ so với Flash-Lite qua Interactions API
Tỉ lệ 4,14 đô chia 0,88 đô là khoảng 4,7 lần, khớp tuyên bố gần 5 lần rẻ hơn Flash-Lite của Google, nhưng tuyên bố này chỉ so với Flash-Lite qua Interactions API, không so với Jev. AI Weekly lưu ý Google không công bố số accuracy cho suite so sánh giá này, cũng không mô tả suite gồm task gì. Con số này Google tự đo, chưa kiểm chứng độc lập, nên cứ tự đo trên dữ liệu của mình trước khi chuyển.
Blog nêu thêm ứng dụng nội bộ: Gemini Notebook routing động giảm latency tới 40% cho truy vấn thường ngày, Stitch tạo wireframe chơi được trong vài giây, CC chọn emoji trong hơn 200 lựa chọn, Search làm safety layer cho MCP tools. Con số 40% này Google tự đo, chưa kiểm chứng độc lập.
Làm theo ngay hôm nay với SDK google-genai 3.2 trở lên và code mẫu chính thức của Google
Tin thì đã rõ, giờ tới phần dev Việt cần nhất là làm theo được tới đâu trong hôm nay, code mẫu chạy bằng SDK nào và tích hợp nào còn đang triển khai. Mình thấy phần này mới quyết định được việc, vì giá với benchmark thì hãng nào cũng đẹp, còn chạy được ngay hôm nay hay không thì phải thử mới biết.
Code mẫu chính thức với client.decisions.create trên Gemini API v1beta
Dùng được ngay qua Gemini API trong AI Studio, chỉ qua Gemini Developer API v1beta và chỉ model này, Python SDK google-genai phiên bản 3.2 trở lên, gọi client.decisions.create(model="gemini-decision-1", input=[...], questions={...}). Code mẫu dưới đây là code chính thức trong blog Google, giữ nguyên logic với cả ba loại câu hỏi trong một request.
Làm theo ngay: code mẫu chính thức dưới đây, anh em copy về chạy thử trong AI Studio.
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

result = client.decisions.create(
    model="gemini-decision-1",
    input=[{
            "type": "image",
            "uri": "https://storage.googleapis.com/generativeai-downloads/images/spill.jpg",
            "mime_type": "image/jpeg",
        },
        {
            "type": "text",
            "text": "Breakroom counter check before the 9 AM client meeting.",
        },
    ],
    questions={
        "has_spill": {
            "type": "noul",
            "instructions": "Is there an uncleaned liquid spill on the counter?",
        },
        "next_action": {
            "type": "choice",
            "instructions": "Which cleanup action fits the scene?",
            "criteria": {
                "wipe_with_cloth": "Small counter spill with a cloth or towel already nearby.",
                "dispatch_janitorial": "Large floor hazard, broken glass, or active leak.",
                "ready_for_meeting": "Counter is clean and ready.",
            },
        },
        "severity": {
            "type": "score",
            "instructions": "Rate the severity of the counter mess.",
            "criteria": [
                "Clean and ready.",
                "Minor localized spill.",
                "Major spill or safety hazard.",
            ],
        },
    },
)
Để thử ngay thì anh em lấy API key trong Google AI Studio, chạy code mẫu trên rồi thay ví dụ quầy bếp bằng việc thật của mình như routing, chấm bài và kiểm duyệt.
Tích hợp OpenRouter, LangChain, Vercel và LiteLLM đang triển khai, chưa phải tất cả đã xong
Tích hợp đang triển khai theo blog Google là OpenRouter, LangChain, Vercel, LiteLLM, Pydantic AI, Pipecat, LiveKit và OpenCode, từ rolling out nghĩa là đang triển khai dần, chưa phải tất cả đã xong. Cùng ngày 06/11, Kakao ra Kanana-2-v-decide, model 3,67 tỉ tham số chỉ trả xác suất, một hướng mở weights đối trọng với API đóng của Google.
Google nêu 3 demo app chính thức là Doorstep Parcels, Speed Sketch và Find the Zoo Keeper, anh em nghía qua trước khi tích hợp vào việc thật.
Gemini in Google Cloud ghi coming soon và những thứ chưa có như caching hay Batch API
Gemini in Google Cloud ghi coming soon, không ngày cụ thể, dev chạy trên Cloud phải chờ. Chưa hỗ trợ context caching, Batch API, Flex và Priority inference, câu hỏi chỉ text, không conversation history, không tool-call block, không link YouTube hay Cloud Storage trực tiếp. Đối chiếu với OpenAI Decisions API, model đó hỗ trợ prompt caching tính theo giá Luna, còn Decision 1 chưa có caching nên chưa thể tính tiền theo kiểu cache.
Những việc Gemini Decision 1 không nên làm và các bẫy Google tự ghi trong guide
Cảnh báo nhỏ: Đọc xong giá và code mẫu thì tới phần dễ mất tiền nhất, chính guide của Google đã ghi sẵn các bẫy, và mình thấy mấy cái bẫy này mới là chỗ dễ mất tiền nhất nếu bỏ qua.
Câu hỏi choice luôn phải chọn một đáp án dù không đáp án nào đúng
Guide Google ghi rõ choice questions always distribute probability across your options, even when none fits, nghĩa là choice luôn phải chọn một đáp án dù không đáp án nào đúng, dev phải thêm lựa chọn none of the above hoặc câu noul kiểm tra trước khi tin kết quả choice. Một đơn hàng không thuộc nhóm nào mà bắt model chọn một nhóm thì số trả về vẫn đẹp nhưng sai.
Input người dùng tự bênh vực cho phân loại của chính nó
Guide Google ghi rõ user-supplied text can argue for its own classification, nghĩa là input do người dùng đưa vào có thể tự bênh vực cho phân loại của nó, dev không được đưa nguyên văn input người dùng vào làm tiêu chí phân loại mà không tách riêng. Người dùng có thể viết câu chữ để được xếp vào nhóm có lợi, nên cứ tách input người dùng ra khỏi tiêu chí, kẻo để nguyên văn vào thì model chấm theo đúng ý họ mà mình không hay. Thêm một cảnh báo thực hành rút ra từ phân tích đối thủ, guide Google không ghi câu này: model chỉ chấm điểm lựa chọn, việc so sánh số và ngày cứ để code lo, không để model tự tính.
Ngưỡng confidence tự đặt từ traffic của mình và giữ người check cho việc high-stakes như thanh toán
Guide Google ghi rõ set thresholds using labeled examples from your own traffic, nghĩa là ngưỡng confidence phải tự đặt bằng ví dụ đã gán nhãn từ chính traffic của mình, không dùng ngưỡng mặc định. Guide cũng ghi rõ keep a human or a second check on high-stakes actions such as payouts, nghĩa là giữ người hoặc check thứ hai cho hành động high-stakes như thanh toán. Calibration Top-1 ECE 0,0250 là số hãng tự đo, chưa kiểm chứng độc lập, nên ngưỡng vẫn phải đo lại trên dữ liệu của mình trước khi cho chạy tự động.
Những việc guide chỉ sang Interactions API, sinh text, suy luận nhiều bước và tool call có argument
Decision 1 là model chuyên biệt cho closed-set decisions, chỉ làm việc chấm điểm lựa chọn, không dùng cho sinh text, tool call có argument hay suy luận nhiều bước, những việc đó guide chỉ sang Interactions API. Jev cũng chỉ nhận text và huấn luyện bằng RLCD thưởng cho xác suất trung thực theo Brier score, nên giới hạn này là giới hạn chung của dòng decision model, không riêng Google.
Google đến sau 2 tháng nhưng gom đủ 5 loại input, chọn Jev hay Decision 1 tùy việc cần làm
Mình thấy không có model nào tốt nhất cho mọi việc, nên chọn theo việc cụ thể thế này: chọn Google Decision 1 khi việc cần input ảnh, audio, video hoặc PDF trong một input chung, cần tới 1.000 câu hỏi mỗi request, hoặc cần calibration tốt nhất trong bảng hãng tự đo, Top-1 ECE 0,0250. Chọn Jev khi việc chỉ cần text và muốn rẻ nhất, giá niêm yết 0,042 đô so với 0,10 đô của Google, tổng chi phí 7 test chung 0,68 đô so với 0,88 đô, Jev thắng 2 test Mind2Web và When2Call. Chọn GPT-6 Luna của OpenAI khi việc đã chạy trên hệ OpenAI, cần prompt caching tính theo giá Luna, hoặc theo ý kiến một commenter Reddit vẫn chọn Luna cho việc decision, OpenAI Decisions API tối đa 400 câu hỏi mỗi request, chỉ nhận text, ảnh và JSON.
Điều chưa biết và cần chờ là chưa có benchmark độc lập cho Decision 1, Artificial Analysis Decision Index chưa công bố đầy đủ cho Decision 1, chưa có ngày Gemini in Google Cloud, chưa có caching và Batch API, nên quyết định chuyển đổi phải đo lại trên dữ liệu của mình trước. Gemini Notebook routing động của Google giảm latency tới 40% cho truy vấn thường ngày, con số này là số hãng tự đo, chưa kiểm chứng độc lập. Anh em nào đã dùng Decision 1 rồi thì chia sẻ trải nghiệm đo thật dưới bình luận.
Nguồn tham khảo
- Blog Google: blog.google
- OpenRouter: openrouter.ai
- Unite.AI: unite.ai
- madrobot.blog: madrobot.blog
- MarkTechPost: marktechpost.com
- CellCog: cellcog.ai
- AI Frontier Post: aifrontierpost.com
- The Decoder: the-decoder.com
- Hacker News: news.ycombinator.com
- Nexus Agent: agent.nexus
- Neural Daily: neuraldaily.news
- AI Weekly: aiweekly.co
- Apidog: apidog.com
- Beetl: beetl.io
- Saif Pasha: saifpasha.com

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Epic để agent viết Unreal Engine 5.9 trong một tuần để kịp MegaJam
- AI viết code nhanh nhưng codebase ngày càng mong manh
- Gemini 4 Carbon mở cửa từ 10/11/2026 cho dev trả phí, doanh nghiệp và người dùng Ultra, giá 2 USD sẽ tăng gấp đôi từ 1/12
Bình luận & Trao đổi