📑 Mục lục chi tiết bài viết (33 mục)
- Ai dùng được Gemini 4 Carbon từ ngày 10/11/2026 và ai vẫn đứng ngoài cửa
- Dev trả phí mở Gemini 4 Carbon trong AI Studio và Android Studio như thế nào
- Doanh nghiệp mở Gemini 4 Carbon trong Gemini for business, Antigravity và CodeMender ra sao
- Người dùng Ultra mở Gemini 4 Carbon trong app Gemini, AI Mode và Antigravity với giá 99,99 USD một tháng
- Nhóm nhà khoa học 10.000 người và đội phòng thủ mạng Fairwind muốn dùng Gemini 4 Carbon vẫn phải qua xét duyệt
- Giá API Gemini 4 Carbon 2 USD input và 10 USD output hết ngày 30/11/2026 rồi tăng gấp đôi từ 1/12
- Trang giá chính thức quy định 5 tier Standard, Batch, Flex, Priority và Contributor cho Gemini 4 Carbon
- Một việc 100.000 token input và 20.000 token output tốn 0,40 USD trước 1/12 và 0,80 USD sau 1/12
- Thinking token của Gemini 4 Carbon tính theo giá output và ngốn gấp 2,3 lần token suy luận so với Argon
- Gemini 4 Carbon mạnh hơn Gemini 4 Argon ở việc khó và dài hơi, còn Argon vẫn hợp đa số việc thường ngày
- Koray Kavukcuoglu nói Argon hợp đa số việc còn Carbon sinh ra cho việc chạm tới giới hạn trí tuệ của model
- GraphWalks 256K đến 1M token cho thấy Carbon đạt 96,2% còn Argon đạt 84,2%
- Khi nào ở lại Argon để hóa đơn nhẹ hơn dù đơn giá API của Carbon và Argon giống hệt nhau
- Claude Fable 5.2 đạt 65 điểm Artificial Analysis Intelligence Index v5 còn Gemini 4 Carbon đạt 60 điểm
- Artificial Analysis Intelligence Index v5 đặt Fable 5.2 Max 65 điểm trên Carbon high 60 điểm như thế nào
- AutomationBench cho thấy Carbon High thắng Fable Max 53,88% so với 51,45% với 2,12 USD một task so với 4,64 USD
- Terminal-Bench 4.0 và FrontierCode 2.0 chia việc thắng cho Carbon và Fable theo từng loại code
- Chọn Fable 5.2 hay Carbon theo effort medium và effort max vì chi phí mỗi task đảo ngược
- Lệnh /swarm trong Antigravity biến một prompt thành đội agent chạy song song trong Git worktree riêng
- Coordinator, worker và verifier đối kháng trong /swarm của Antigravity phối hợp ra sao
- Demo game chim bồ nông 3D và văn phòng Platform 37 với 906.000 tam giác cho thấy /swarm làm được việc dài hơi nào
- Vì sao /swarm trong Antigravity ngốn quota nhanh hơn chat thường rất nhiều
- Con số 99% chặn tấn công của Google là số hãng tự đo và tỉ lệ breach theo mục tiêu của Carbon vẫn 40%
- SEC-bench Pro 88,2% và ExploitGym 54,8% của Gemini 4 Carbon đo không có guardrails ra sao
- Tỉ lệ breach 0,8% mỗi lần thử và 40% theo mục tiêu sau 200 lần thử nói lên điều gì về Carbon
- Trải nghiệm Argon bịa nguyên đoạn hội thoại cảnh sát chìm và tỉ lệ bịa đặt 11% của Carbon so với 4% của Argon
- AlphaProof Code dùng Carbon chứng minh mã hóa Signal trong 4 tuần nhưng chỉ đúng trong phạm vi nhắn 1-1
- Người Việt Nam dùng Gemini 4 Carbon rẻ nhất bằng API trả phí trước 30/11 và tự kiểm tra Ultra tại Việt Nam
- Dùng API Gemini 4 Carbon trả phí trước 30/11/2026 để giữ giá 2 USD input và 10 USD output
- Tự kiểm tra Ultra có bán ở Việt Nam không bằng 3 bước trong app Gemini và trang gói AI trước khi bỏ 100 USD một tháng
- Chạy bộ prompt cố định trên Carbon và Argon để tự test trước khi đổi production
- Chọn nhanh Gemini 4 Carbon, Argon hay Claude Fable 5.2 theo đúng việc của mình
- Nguồn tham khảo
Google công bố Gemini 4 Carbon ngày 28/10/2026 rồi 13 ngày sau, đến 10/11/2026, mới mở cho dev trả phí, doanh nghiệp và người dùng Ultra. Một ngày trước đó, Claude Fable 5.2 ra mắt 09/11/2026 và lấy mất ngôi nhất bảng Artificial Analysis Intelligence Index v5. Bài này trả lời hai câu thôi, dùng được không và đáng tiền không, mà giá API 2 USD input và 10 USD output mỗi triệu token thì chỉ giữ tới hết 30/11/2026.
Đọc nhanh trong 2 phút: từ 10/11/2026, dev trả phí dùng Carbon qua API Gemini trong AI Studio và Android Studio. Doanh nghiệp dùng qua Gemini for business, người dùng Ultra dùng trong app Gemini, AI Mode và Antigravity. Người dùng Free và AI Pro chưa có tên trong bài công bố. Giá API hiện tại là 2 USD input và 10 USD output mỗi triệu token, hết ngày 30/11/2026 rồi tăng gấp đôi thành 4 USD input và 20 USD output từ 01/12/2026. Carbon không còn là số 1 bảng Artificial Analysis Intelligence Index v5, Fable 5.2 Max đạt 65 điểm còn Carbon high đạt 60 điểm.
Ai dùng được Gemini 4 Carbon từ ngày 10/11/2026 và ai vẫn đứng ngoài cửa
Cơn giận lớn nhất trên Hacker News sau bài công bố 28/10/2026 là chẳng ai dùng được model này, thread tăng từ 363 lên 938 upvote trong 16 giờ với 758 bình luận.
Dev trả phí mở Gemini 4 Carbon trong AI Studio và Android Studio như thế nào
Dev trả phí dùng Carbon qua API Gemini trong AI Studio và Android Studio, đổi từ Argon sang Carbon chỉ cần đổi model ID. Context 1 triệu token thì dùng chung cho cả input, thinking lẫn output, thinking mặc định là medium, mà mọi token đều tính tiền vì không có Free tier, còn người dùng 827a kể rằng app điện thoại của mình chỉ thấy 3.8 Pro. Mình mà đang chạy Argon bằng API thì mình đổi thử Carbon trên một việc khó thật trước, đo tiền mỗi task rồi mới tính chuyện đổi hẳn.
Doanh nghiệp mở Gemini 4 Carbon trong Gemini for business, Antigravity và CodeMender ra sao
Doanh nghiệp dùng Carbon qua Gemini for business bằng API hoặc menu chọn model, qua Antigravity và CodeMender, nhưng tài khoản Workspace đăng ký Ultra thì vẫn chưa rõ đi đường nào, chưa có lịch triển khai theo từng nước, VentureBeat thì ghi chưa xác nhận Carbon có trên Vertex AI hay không. Mình mà quản trị Workspace thì mình chưa hứa hẹn gì với sếp về Carbon cho tới khi Google ghi rõ đường đi của tài khoản Workspace và Vertex AI.
Người dùng Ultra mở Gemini 4 Carbon trong app Gemini, AI Mode và Antigravity với giá 99,99 USD một tháng
Người dùng Ultra dùng Carbon trong Antigravity, app Gemini và AI Mode trong Search. Gói Ultra ở Mỹ là 99,99 USD một tháng bản 5x và 199,99 USD bản 20x, mà trang gói AI chỉ ghi Carbon tới Ultra ở một số nước được chọn, không liệt kê cụ thể, nên người dùng app muốn chạm Carbon phải trả khoảng 100 USD một tháng. Mình chưa bỏ 100 USD một tháng cho Ultra chỉ để chạm Carbon khi danh sách nước còn chưa ghi rõ Việt Nam có trong đó hay không.
Nhóm nhà khoa học 10.000 người và đội phòng thủ mạng Fairwind muốn dùng Gemini 4 Carbon vẫn phải qua xét duyệt
Nhà khoa học thì nộp đơn vào chương trình 10.000 người để dùng miễn phí 6 tháng, đội phòng thủ mạng nộp đơn Fairwind cho bản cyber chuyên sâu, nhưng nộp đơn chưa phải là dùng được ngay đâu, vẫn phải qua xét duyệt. Argon thì công bố 30/09/2026, mở API trả phí 13/10/2026, còn Carbon công bố 28/10/2026 rồi GA 10/11/2026.
Giá API Gemini 4 Carbon 2 USD input và 10 USD output hết ngày 30/11/2026 rồi tăng gấp đôi từ 1/12
Giá mở đầu 2 USD input và 10 USD output mỗi triệu token nghe thì rẻ, nhưng trang giá chính thức ghi rõ giá này hết ngày 30/11/2026 rồi tăng gấp đôi từ 01/12/2026, nên mình tính tiền thật theo cả hai mốc luôn.
Trang giá chính thức quy định 5 tier Standard, Batch, Flex, Priority và Contributor cho Gemini 4 Carbon
Trang giá chính thức ghi 5 tier, mọi con số tính theo mỗi triệu token, mốc trước kéo dài tới 30/11/2026, mốc sau bắt đầu từ 01/12/2026.
Standard: input 2 USD tới 30/11 rồi 4 USD từ 01/12, output 10 USD rồi 20 USD, cache 0,10 USD rồi 0,20 USD.
Batch: input 1 USD tới 30/11 rồi 2 USD từ 01/12, output 5 USD rồi 10 USD, cache 0,05 USD rồi 0,10 USD.
Flex: giống hệt Batch, input 1 USD tới 30/11 rồi 2 USD từ 01/12, output 5 USD rồi 10 USD, cache 0,05 USD rồi 0,10 USD.
Priority: input 3,60 USD tới 30/11 rồi 7,20 USD từ 01/12, output 18 USD rồi 36 USD, cache 0,18 USD rồi 0,36 USD.
Contributor: chỉ mời riêng, input 1 USD và output 5 USD, không ghi mốc tăng giá.
Grounding Search thì cho 5.000 lượt miễn phí mỗi tháng rồi 14 USD mỗi 1.000 lượt, giới hạn 1.500 lượt mỗi ngày. Mình chạy việc thật thì chọn Batch hoặc Flex trước 30/11, trả Standard cho cùng một việc là phí tiền.
Một việc 100.000 token input và 20.000 token output tốn 0,40 USD trước 1/12 và 0,80 USD sau 1/12
Một việc 100.000 token input và 20.000 token output thì tốn 0,40 USD ở giá khuyến mãi, còn từ 01/12/2026 cùng việc đó tốn 0,80 USD vì đơn giá tăng gấp đôi, con số này chưa tính phí nền tảng đâu, anh em tính lại với số token thật của việc mình.
Thinking token của Gemini 4 Carbon tính theo giá output và ngốn gấp 2,3 lần token suy luận so với Argon
Cảnh báo nhỏ: cái bẫy tiền lớn nhất nằm ở thinking token, vì Carbon dùng gấp 2,3 lần token suy luận và nhiều hơn 64% token đầu ra so với Argon theo số liệu Vals. Carbon chạy bộ Artificial Analysis Intelligence Index mà đốt tới 205 triệu token, gấp gần 3 lần mức trung bình, mà thinking token nào cũng tính tiền theo giá output.
Nên cùng một việc thì hóa đơn Carbon cao hơn Argon dù đơn giá giống hệt nhau, ý kiến trên Hacker News nói Carbon cùng token mỗi task với Argon là sai ngay ở điểm này. Đơn giá giống hệt nhau, hóa đơn cuối tháng thì không.
Gemini 4 Carbon mạnh hơn Gemini 4 Argon ở việc khó và dài hơi, còn Argon vẫn hợp đa số việc thường ngày
Câu hỏi rối nhất trên Hacker News là Carbon có phải bản 4.1 không và Argon có lỗi thời không, thì câu trả lời là Carbon chỉ là bản lặp tiếp theo của Argon, giống quan hệ Opus và Sonnet, cùng giá nhưng không thay thế Argon.
Koray Kavukcuoglu nói Argon hợp đa số việc còn Carbon sinh ra cho việc chạm tới giới hạn trí tuệ của model
Koray Kavukcuoglu, Chief AI Architect của Google, nói Argon vẫn là lựa chọn lý tưởng cho đa số việc software engineering và knowledge work. Còn Carbon sinh ra cho những việc chạm tới giới hạn trí tuệ của model, mình ghi rõ đây là lời hãng chứ chưa phải kết luận độc lập, và Sundar Pichai trên X cũng nói Carbon sinh ra cho việc dài hơi, suy luận sâu trong software engineering, cybersecurity và scientific discovery.
Mình đồng ý với nửa đầu, Argon đúng là đủ cho việc thường, còn nửa sau thì mình chờ bài test độc lập rồi mới tin Carbon chạm tới giới hạn trí tuệ thật.
GraphWalks 256K đến 1M token cho thấy Carbon đạt 96,2% còn Argon đạt 84,2%
Trên bài GraphWalks với context từ 256K đến 1M token, Carbon đạt 96,2% còn Argon đạt 84,2%, mà Artificial Analysis Intelligence Index trong model card của Carbon ghi 59 điểm so với 50 điểm của Argon, sau bản sửa v5.0.1 thì Carbon thành 60 điểm.
Con số GraphWalks này nằm trong nhóm số liệu model card mà Unite.AI đọc lại từ Google, nên mình vẫn xếp nó vào nhóm số hãng tự đo, chưa có kiểm chứng độc lập. Mình chưa lấy 96,2% này ra khoe với ai, vì số context dài mà chưa ai đo lại thì mình chỉ xem như lời hãng nói về chính model của hãng.
Khi nào ở lại Argon để hóa đơn nhẹ hơn dù đơn giá API của Carbon và Argon giống hệt nhau
Ở lại Argon cho đa số việc thường ngày theo chính Google, vì Carbon tốn gấp 2,3 lần token suy luận và nhiều hơn 64% token đầu ra, nên việc thường mà gọi Carbon là trả tiền cho token suy luận không cần thiết. Việc nào Argon làm dở hoặc lạc hướng giữa chừng thì mới gọi Carbon ở thinking medium mặc định, chỉ lên high khi thật sự cần. Mình vẫn để Argon chạy việc thường ngày, Carbon chỉ gọi khi Argon làm dở thật. Gọi Carbon cho việc thường là trả tiền thừa.
Claude Fable 5.2 đạt 65 điểm Artificial Analysis Intelligence Index v5 còn Gemini 4 Carbon đạt 60 điểm
Carbon ra mắt 28/10/2026 với 59 điểm và đứng nhất bảng Artificial Analysis, nhưng 13 ngày sau Fable 5.2 ra mắt 09/11/2026 với 65 điểm và lấy mất ngôi nhất đúng một ngày trước ngày Carbon mở cửa.
Artificial Analysis Intelligence Index v5 đặt Fable 5.2 Max 65 điểm trên Carbon high 60 điểm như thế nào
Bảng Artificial Analysis Intelligence Index v5 đặt Fable 5.2 Max 65 điểm, Carbon high 60 điểm, Opus 5.5 Max 59 điểm và Astra Max 57 điểm, Carbon lúc ra mắt 59 điểm rồi thành 60 điểm sau bản sửa v5.0.1.
Nhưng bảng v5 thay HLE bằng HLE-Diamond từ 27/10/2026, 60% bài test đóng góp vào index giờ là private nên không ai tái tạo được, và Fable Max tốn 44,1 phút mỗi task. Mình vẫn dùng bảng này để so nhanh, nhưng mình không chốt mua model nào chỉ vì hơn nhau 5 điểm trên một bảng mà 60% bài test đã đóng kín.
AutomationBench cho thấy Carbon High thắng Fable Max 53,88% so với 51,45% với 2,12 USD một task so với 4,64 USD
AutomationBench là điểm sáng có số công khai ủng hộ Carbon, Carbon High 53,88% với 2,12 USD mỗi task, hơn Fable Max 51,45% với 4,64 USD mỗi task. Bảng này là kiểm chứng độc lập, khác với hai tuyên bố đứng nhất của Google chưa qua kiểm chứng độc lập.
Bảng CursorBench cho Fable Max đứng đầu 60,0% mà không có dòng Carbon, bảng WANDR của Anthropic để trống Carbon, còn AlphaSignal ghi CursorBench 4.0 thì Carbon High 60,4% so với Fable Max 60,0%, hơn 0,4 điểm, không có khoảng tin cậy. Hơn 0,4 điểm mà không có khoảng tin cậy thì chưa nói lên gì nhiều.
Terminal-Bench 4.0 và FrontierCode 2.0 chia việc thắng cho Carbon và Fable theo từng loại code
Terminal-Bench 4.0 cho Carbon High 65,2% so với Fable tốt nhất 61,6%, FrontierCode 2.0 cho Fable 49,1% so với Carbon 40,6% đến 41,1%, Terminal-Bench-Science cho Fable 74,6%, Mythos 75,3%, Astra 68,1% và Carbon 64,8%. FrontierSWE v2 là số hãng tự đo với Fable 69,9%, Astra 65,5%, Carbon 61,2% và Opus 62,3%, nên Carbon thắng ở việc terminal và workflow dài, thua Fable ở code repo thật và khoa học. Mình mà làm việc terminal dài hơi thì mình thử Carbon trước, còn việc sửa repo thật hay chạy code khoa học thì mình vẫn cầm Fable đi test song song.
Chọn Fable 5.2 hay Carbon theo effort medium và effort max vì chi phí mỗi task đảo ngược
Ở effort max, Fable 5.2 tốn 26,54 USD mỗi task, còn Carbon high chỉ 7,76 USD. Nhưng ở effort medium thì Fable tốn 3,80 USD và đạt 56 điểm, còn Carbon tốn 6,59 USD và đạt 58 điểm, tức là Fable lại rẻ hơn mà chỉ thua 2 điểm. Chọn effort sai là Carbon đắt hơn Fable ngay.
Fable 5.2 có giá 8 USD input và 40 USD output mỗi triệu token, đắt gấp 4 lần Carbon ở giá mở đầu và đã giảm 20% so với bản 5.1. Fable và Mythos cùng một model nền, chỉ khác ở guardrails, query về pentest, tạo exploit hay nghiên cứu sinh học bị chặn thì Opus 4.8 và Opus 5 trả lời thay. Mình mà chạy task nặng thì mình đo cả hai effort trước khi chốt model, vì giá niêm yết không nói lên tiền thật mỗi task.
Lệnh /swarm trong Antigravity biến một prompt thành đội agent chạy song song trong Git worktree riêng
Nếu Carbon chỉ là một model mạnh hơn thì câu chuyện đã dừng ở bảng điểm, nhưng Google đang cược vào một thứ khác, một đội agent phối hợp thay vì một chatbot mạnh hơn.
Coordinator, worker và verifier đối kháng trong /swarm của Antigravity phối hợp ra sao
Lệnh /swarm trong Antigravity hiện còn ở preview, gõ một prompt kèm lệnh này thì một coordinator tạo nhiều worker chạy song song trong Git worktree tách biệt, một verifier đối kháng chạy test và thách thức mọi thay đổi, mà chưa có bài nào chạy thử /swarm độc lập nên mình chỉ mô tả theo thông cáo.
Demo game chim bồ nông 3D và văn phòng Platform 37 với 906.000 tam giác cho thấy /swarm làm được việc dài hơi nào
Google kể test nội bộ 5 tuần trên migration đa package và thiết kế lại kiến trúc, rồi demo game 3D chim bồ nông cưỡi xe đạp, tái dựng văn phòng Platform 37 với 906.000 tam giác qua 10 vòng chạy qua đêm, và đàn fortepiano khoảng năm 1780 với 61 phím. Tất cả đều là test nội bộ và demo của hãng, chưa có kiểm chứng độc lập.
Vì sao /swarm trong Antigravity ngốn quota nhanh hơn chat thường rất nhiều
Lệnh /swarm ngốn quota nhanh hơn nhiều so với chat thường, nên ai thử mà không tính quota trước sẽ nhận hóa đơn bất ngờ. Một nguồn thứ hai kể rằng dev trên Reddit than bị throttle nhiều giờ sau 3 đến 5 prompt phức tạp, mình ghi rõ nguồn này là nguồn thứ hai chưa đọc trực tiếp. Argon trên Hacker News cũng cho thấy 5 tin nhắn medium đủ kích cooldown 4 giờ.
Mình thấy /swarm hợp với dev đang làm migration đa package hoặc refactor dài hơi mà đã dùng Antigravity hoặc Ultra, còn ai đang chật quota hoặc chưa kiểm tra chi phí trước thì nên bỏ qua.
Con số 99% chặn tấn công của Google là số hãng tự đo và tỉ lệ breach theo mục tiêu của Carbon vẫn 40%
Con số 99% chặn tấn công nghe thì tuyệt đối, nhưng chính báo cáo an toàn của Google cũng ghi tỉ lệ breach theo mục tiêu vẫn 40% sau 200 lần thử ở mỗi task.
SEC-bench Pro 88,2% và ExploitGym 54,8% của Gemini 4 Carbon đo không có guardrails ra sao
Carbon đạt 88,2% trên SEC-bench Pro, 54,8% trên ExploitGym và 71,0% trên CWE-bench v1, tất cả đều là số hãng tự đo, đo không có guardrails, trong khi Fortify đạt 100% recall quét và 95% precision phân loại trên benchmark nội bộ, còn bản cyber chuyên sâu vẫn chỉ qua Fairwind. Mình chưa tin 88,2% này đủ để giao việc phòng thủ thật, vì đo không có guardrails thì khác xa lúc bật đầy đủ rào chắn trong production.
Tỉ lệ breach 0,8% mỗi lần thử và 40% theo mục tiêu sau 200 lần thử nói lên điều gì về Carbon
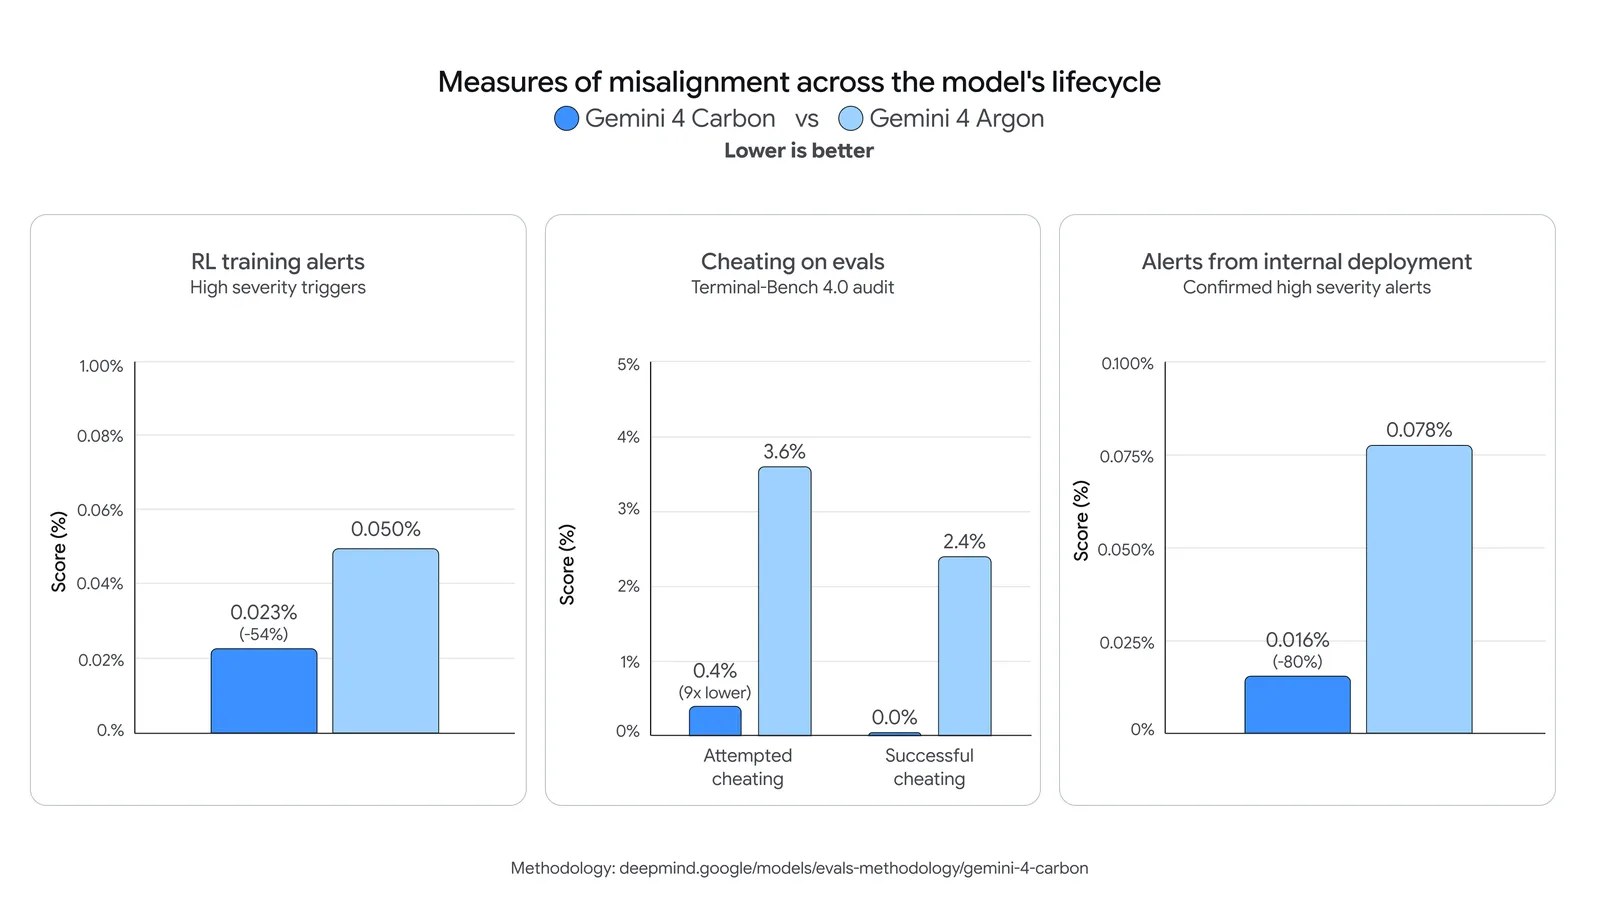
Google ghi Carbon chặn 99% quỹ đạo tấn công, con số này do hãng tự đo. Tỉ lệ breach mỗi lần thử là 0,8% so với 3,1% của Argon, tỉ lệ thành công của truy vấn tấn công mạng trên Gray Swan là 2,17% so với 9,86% của Argon. Bài kiểm tra trung thực 375 task của Google đạt 92% so với 70% của Argon, và đây là bài test của chính Google chứ chưa có kiểm chứng độc lập. Chặn 99% mà breach mục tiêu vẫn 40%, đó mới là con số phải nhớ.
Nhưng tỉ lệ breach theo mục tiêu vẫn 40% sau 200 lần thử ở mỗi task trong 25 task mức nghiêm trọng cao, và nếu không có safeguard ngoài model thì không loại trừ khả năng Carbon chạm Cyber Uplift Level 1, nên mình không gọi 99% là an toàn tuyệt đối.
Trải nghiệm Argon bịa nguyên đoạn hội thoại cảnh sát chìm và tỉ lệ bịa đặt 11% của Carbon so với 4% của Argon
Một người dùng ẩn danh trên Hacker News kể Argon bịa nguyên một đoạn hội thoại dài từ vụ cảnh sát chìm chỉ vì đọc tên file ghi âm của mẹ vợ. Trải nghiệm cá nhân này chưa kiểm chứng độc lập nhưng khớp với tỉ lệ bịa đặt 11% của Carbon so với 4% của Argon trên bài AA-Omniscience.
AlphaProof Code dùng Carbon chứng minh mã hóa Signal trong 4 tuần nhưng chỉ đúng trong phạm vi nhắn 1-1
AlphaProof Code dùng Carbon sinh hàng triệu dòng Lean để chứng minh code mã hóa Signal, công bố cùng ngày Carbon mở cửa. Đội 5 người chạy mỗi đợt 40 đến 80 agent trong 24 đến 72 giờ suốt 4 tuần, bắt được cả 2 bug cũ weak state và small subgroup khi đưa lại, không tìm thấy lỗ hổng mới ở phần đã kiểm tra.
Nhưng phạm vi chỉ là phiên nhắn 1-1 của libsignal v0.105.4 và SPQR v1.6.0, nhóm chat và đa thiết bị nằm ngoài phạm vi. Mình nể công sức chứng minh này thật, nhưng mình chưa gọi Signal là đã được chứng minh toàn bộ khi nhóm chat và đa thiết bị còn chưa được kiểm tra.
Người Việt Nam dùng Gemini 4 Carbon rẻ nhất bằng API trả phí trước 30/11 và tự kiểm tra Ultra tại Việt Nam
Câu hỏi còn lại của độc giả Việt Nam rất thực tế, mình ở Việt Nam thì dùng bằng cửa nào rẻ nhất và Ultra có bán ở đây không.
Dùng API Gemini 4 Carbon trả phí trước 30/11/2026 để giữ giá 2 USD input và 10 USD output
Cửa rẻ nhất là API trả phí, dùng trước 30/11/2026 để giữ giá mở đầu 2 USD input và 10 USD output, từ 01/12/2026 thành 4 USD và 20 USD, mà dùng Batch hoặc Flex thì trả 1 USD input và 5 USD output trước 30/11 rồi 2 USD và 10 USD sau 01/12.
Tự kiểm tra Ultra có bán ở Việt Nam không bằng 3 bước trong app Gemini và trang gói AI trước khi bỏ 100 USD một tháng
Ultra ở Việt Nam chưa xác nhận, nên anh em tự kiểm tra bằng 3 bước, bước 1 mở trang gói AI xem có ghi Việt Nam không, bước 2 mở app Gemini xem menu model có Gemini 4 Carbon không, bước 3 mở Antigravity xem có Carbon và /swarm không, nếu chưa thấy Carbon thì đừng mua Ultra vội.
Chạy bộ prompt cố định trên Carbon và Argon để tự test trước khi đổi production
Cùng một việc thật của mình, chạy trên Carbon và Argon ở thinking level medium, ghi lại task xong hay chưa, token suy luận, token output, chi phí mỗi task trước và sau 01/12/2026.
Làm theo ngay: chạy bộ prompt cố định ở trên với một việc thực chiến của mình rồi đối chiếu output với nguồn gốc để kiểm tra bịa đặt, và đừng đưa Carbon vào production cho việc cần fact chính xác trước khi test xong.
Chọn nhanh Gemini 4 Carbon, Argon hay Claude Fable 5.2 theo đúng việc của mình
Mình xếp 3 model vào đúng việc của từng người thế này.
Việc thường ngày thì ở lại Argon cho rẻ.
Việc khó dài hơi thì thử Carbon, ưu tiên API trước ngày 30/11/2026 và đo chi phí mỗi task ở cả hai mốc giá.
Việc code thay đổi repo thật và khoa học trong terminal thì cân nhắc Fable 5.2, nhớ so theo effort vì Fable medium rẻ hơn Carbon medium.
Việc cần /swarm thì vào Antigravity và coi chừng quota.
Việc cần fact chính xác thì test bịa đặt trước khi tin Carbon.
Mình sửa công khai bài post 243, bài đó từng cảnh báo ngày 30/11/2026 chỉ là hạn giá mở đầu của Argon. Cảnh báo đó nay đã lỗi thời vì trang giá chính thức ghi Carbon cũng hết giá mở đầu ngày 30/11/2026, nên anh em nào lập ngân sách theo bài cũ thì tính lại theo mốc này. Anh em chia sẻ trải nghiệm thật sau khi tự test.
Nguồn tham khảo
- Blog Google, Gemini 4 Carbon: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
- Trang giá API Gemini chính thức: https://ai.google.dev/gemini-api/docs/pricing
- VentureBeat, Gemini 4 Carbon GA: https://venturebeat.com/technology/google-gemini-4-carbon-is-now-publicly-available-and-it-undercuts-claude-fable-5-2-and-opus-5-5-on-api-price
- madrobot, Gemini 4 Carbon GA: https://madrobot.blog/2026/11/10/google-gemini-4-carbon-available-ai-ultra-api-swarm/
- Unite.AI, Gemini 4 Carbon mở rộng: https://www.unite.ai/google-expands-gemini-4-carbon-access-beyond-cybersecurity-defenders/
- AlphaSignal, Carbon trên CursorBench 4.0: https://alphasignal.ai/news/google-s-gemini-4-carbon-tops-cursor-s-coding-benchmark-at-half-the-price
- DataCamp, Gemini 4 Carbon so với Claude Fable 5.1: https://www.datacamp.com/blog/gemini-4-carbon-vs-claude-fable-5-1
- Hacker News, thread công bố Carbon: https://news.ycombinator.com/item?id=50276792
- Hacker News, thread Artificial Analysis: https://news.ycombinator.com/item?id=50288019
- ThuThuatAI.net, Gemini 4 Carbon đứng đầu nhưng khóa cửa: Gemini 4 Carbon đứng đầu nhưng khóa cửa
- ThuThuatAI.net, DeepMind AlphaProof Code và Signal: DeepMind AlphaProof Code và Signal
- ThuThuatAI.net, Claude Fable và Mythos 5.2: Claude Fable và Mythos 5.2
- Artificial Analysis Intelligence Index v5: https://www.benchleader.com/benchmarks/aa_intelligence_index_v5
- OfficeChai, Fable 5.2 vượt Carbon 5 điểm: https://officechai.com/ai/anthropic-jumps-to-top-of-artificial-analysis-intelligence-index-with-fable-5-2-beats-gemini-4-carbon-by-5-points/
- Eesel, giá Gemini 4 Carbon: https://www.eesel.ai/blog/gemini-4-carbon-pricing
- APIVALE, giá và benchmark Gemini 4 Carbon: https://www.apivale.com/blog/gemini-4-carbon-api-pricing-benchmarks/
- TechResearchOnline, Carbon mở rộng truy cập: https://techresearchonline.com/news/gemini-4-carbon-access-rollout/

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Google ra Gemini Decision 1 ngày 11/11/2026, model trả xác suất thay vì viết chữ với giá 0,10 đô cho 1 triệu token input
- Epic để agent viết Unreal Engine 5.9 trong một tuần để kịp MegaJam
- AI viết code nhanh nhưng codebase ngày càng mong manh
arfgy4