📑 Mục lục chi tiết bài viết (29 mục)
- Jev là decision model trả xác suất, Luna chỉ là small LLM chạy qua Decisions API
- Jev trả đáp án có kiểu kèm xác suất trong một forward pass
- Luna là small LLM, Decisions API chỉ giúp Luna đóng vai decision model
- Jev và Luna chạy lẻ trên test dễ của Hightouch, Luna hơn Jev 1,7 điểm
- Hightouch cho Jev chấm 1.000 identity giả lập rồi nhờ Opus chấm lại 22% ca khó
- Bài toán over-merging trong identity resolution và dữ liệu pseudopeople 1.000 identity
- Bảng kết quả test dễ và dải leo thang 30-90% cho ra 98,8% với $0,88
- Test khó của Hightouch cho thấy hybrid Jev còn nhỉnh hơn Opus một mình
- Jev làm người gác cổng được vì lỗi của nó nằm ở vùng tin cậy thấp
- Calibration đo độ trung thực của con số tin cậy, ECE càng thấp càng thật
- Lỗi Jev nằm gần 50% tin cậy nên dải leo thang bắt được, lỗi Luna trốn ở 90-100%
- Tiết kiệm 4 lần chỉ đúng trên test dễ của Hightouch, test khó còn 1,8 lần
- Test dễ Hightouch rẻ hơn 4,4 lần và Banking77 rẻ hơn 3,5 lần
- Test khó Hightouch chỉ còn 1,8 lần vì hệ thống tự chuyển nhiều ca hơn cho Opus
- Hybrid Luna rẻ hơn hybrid Jev nhưng kém chính xác, chỉ hợp khi dữ liệu dễ
- Vì sao Pith nói cascade không tăng điểm mà Hightouch vẫn tiết kiệm được 4,4 lần
- Pith đọc v1 và arXiv v3 nói trần tăng điểm chỉ 1,5 tới 2,7 điểm
- Vì sao Hightouch và Pith không mâu thuẫn nhau, lỗi tương quan là trần của cascade
- Headline 4 lần thấp hơn gây hiểu lầm, nên nói rẻ hơn 4,4 lần hoặc còn 23% chi phí
- Tự thử cascade trên dữ liệu của mình thì đo ngưỡng từ mẫu có nhãn trước
- Đừng copy ngưỡng 30-90% của Hightouch, đo lại trên mẫu có nhãn của mình
- Ba mốc ngưỡng tham khảo, band 0,2-0,8 của Samaya và ngưỡng 0,95 của Teti
- Checklist triển khai cho team nhỏ, từ mẫu nhãn tới theo dõi chi phí theo volume
- Những task không nên giao cho Jev và cascade Jev Opus
- Task cần suy luận dài, giải thích và audit lý do thì Jev không hợp
- Dữ liệu ngoài phân phối và lỗi tự tin cao chiếm đa số thì cascade không cứu được
- Chọn nhanh hybrid Jev Opus, giữ Opus hay dùng Luna
- Jev cộng Opus đáng thử khi dữ liệu của anh em giống dữ liệu Hightouch đã đo
- Nguồn tham khảo
Jev chạy lẻ chỉ đúng 95,6% với 0,05 đô cho mỗi 1.000 quyết định, vậy mà nhờ Opus chấm lại đúng 22% ca nó không chắc, con số nhảy lên 98,8% với 0,88 đô, gần bằng Opus chạy một mình ở 99,0% với 3,86 đô. Nghe thì hời, nhưng trước khi tin thì cần hỏi con số này có đúng trên dữ liệu của mình không, vì đáp án nằm ở chỗ Jev biết mình sai ở đâu.
Đọc nhanh 30 giây: Jev chạy lẻ 95,6% với $0,05 cho mỗi 1.000 quyết định. Opus 5.5 chạy lẻ 99,0% với $3,86. Hybrid Jev rồi Opus chấm lại 22% ca trong dải tin cậy 30-90% đạt 98,8% với $0,88, tức rẻ hơn Opus khoảng 4,4 lần trên test dễ của Hightouch. Luna chạy lẻ 97,3% với $0,10 theo giá Decisions API nhưng hybrid Luna chỉ lên 98,5% với $0,33 trên test dễ và sụt còn 91,6% trên test khó. Tiết kiệm 4 lần thay đổi theo độ khó, test khó của Hightouch chỉ còn khoảng 1,8 lần.
Jev là decision model trả xác suất, Luna chỉ là small LLM chạy qua Decisions API
Trước khi bàn con số tiết kiệm, cần gọi đúng tên từng model, vì Jev và Luna khác nhau ở kiến trúc.
Jev trả đáp án có kiểu kèm xác suất trong một forward pass
Jev của TypeSafe AI, ra mắt 15/09/2026, nhận state cộng câu hỏi có kiểu rồi trả đáp án có kiểu kèm phân phối xác suất và confidence, không sinh text. Ba kiểu câu hỏi là choice tối đa 255 lựa chọn, score thang 2-10 mức, noul là xác suất câu khẳng định đúng từ 0 tới 1. Jev huấn luyện bằng RLCD, thưởng cho xác suất trung thực theo Brier score, khác RLHF, giá niêm yết 0,042 đô cho 1 triệu input token, output miễn phí. Chưa có paper về kiến trúc hay RLCD, benchmark hãng tự chạy, chưa tái lập độc lập.
Luna là small LLM, Decisions API chỉ giúp Luna đóng vai decision model
Luna là small LLM trong họ GPT-6, ra mắt cùng GPT-6 Sol ngày 22/09/2026, đóng vai decision model khi chạy qua Decisions API, như Jaxkr đã chỉnh trên Hacker News. Decisions API mở beta ngày 06/10/2026 rồi GA ngày 22/10/2026, chỉ hỗ trợ gpt-6-luna, endpoint POST /v1/decisions, tối đa 400 câu hỏi mỗi request, nhanh hơn tới 10 lần so với Luna qua Responses API.
Giá là 0,10 đô cho 1 triệu input token, 0,01 đô cho 1 triệu cached input, không tính output, còn giá Luna chat thường là 0,10 đô input và 0,50 đô output mỗi triệu token. Ba loại đáp án là predicate, choice và score. Box, Datadog, Ramp đều là số khách hàng tự báo cáo, chưa đo độc lập.
Jev và Luna chạy lẻ trên test dễ của Hightouch, Luna hơn Jev 1,7 điểm
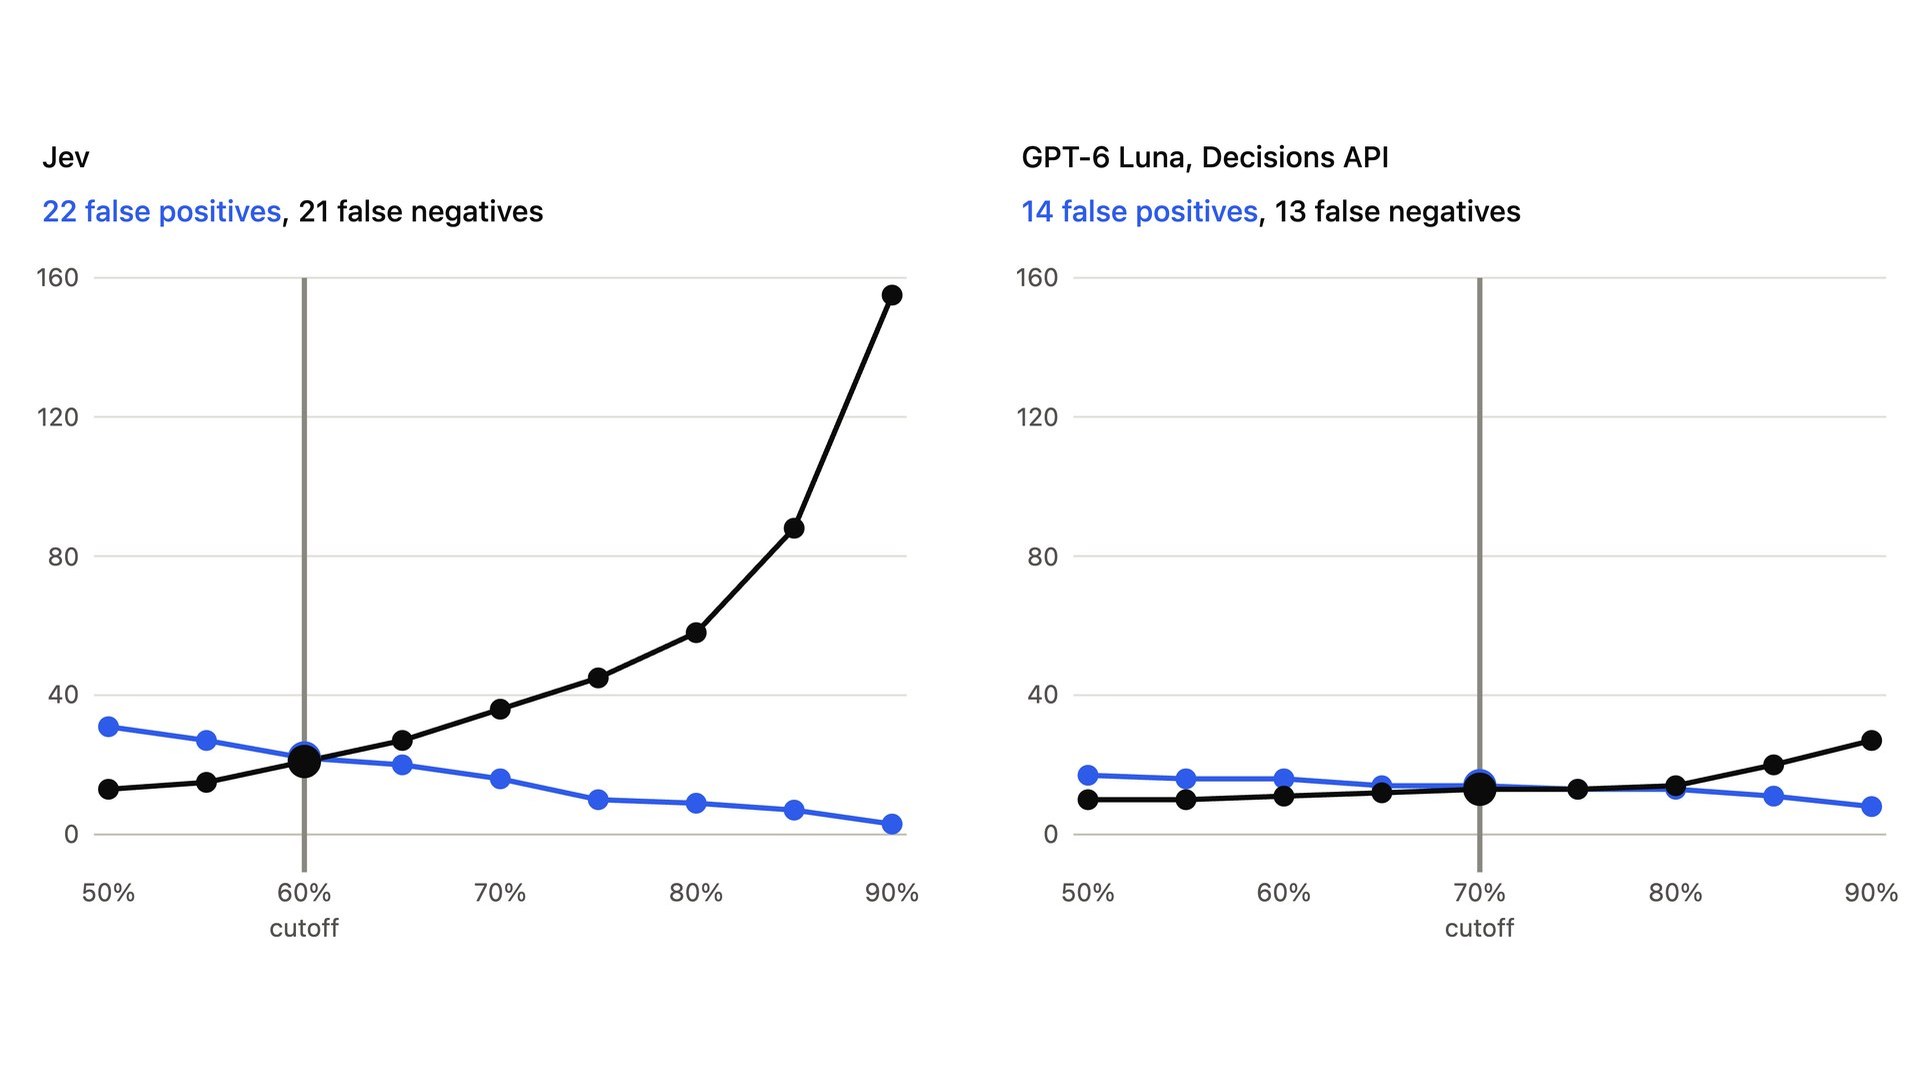
Con số dưới đây tính cho mỗi 1.000 quyết định, ở ngưỡng 50%. Điểm ngược trực giác nằm ngay đây: Luna chạy lẻ hơn Jev tới 1,7 điểm mà hybrid Luna lại thua hybrid Jev. Điểm khác nằm ở calibration, tức độ trung thực của con số tin cậy. Ngưỡng tối ưu là Jev 60% đạt 95,7% với FP 22, FN 21. Luna 70% đạt 97,3% với FP 14, FN 13.
| Model | Độ chính xác | FP | FN | Thời gian | Chi phí |
|---|---|---|---|---|---|
| Opus 5.5 | 99,0% | 3 | 7 | 2,2 giây | $3,86 |
| Gemini 3.1 Pro | 98,3% | 10 | 7 | 4,2 giây | $4,48 |
| GPT-6 Sol | 98,3% | 14 | 3 | 2,1 giây | $2,50 |
| Luna Decisions | 97,3% | 17 | 10 | 0,17 giây | $0,10 |
| Jev | 95,6% | 31 | 13 | 0,15 giây | $0,05 |
Hightouch cho Jev chấm 1.000 identity giả lập rồi nhờ Opus chấm lại 22% ca khó
Đã gọi đúng tên hai model, giờ xem thí nghiệm gốc làm gì với chúng.
Bài toán over-merging trong identity resolution và dữ liệu pseudopeople 1.000 identity
Identity resolution là việc gom các bản ghi về đúng một người thật, lỗi nguy hiểm nhất là over-merging, gộp nhầm hai người khác nhau thành một. Kiểm chứng trên dữ liệu thật rất khó vì không có đáp án chuẩn.
Chấm tay chỉ được khoảng 50 hồ sơ mỗi giờ, mà muốn sai số dưới cộng trừ 1% thì cần hơn 1.000 mẫu, vì vậy Hightouch tự tạo benchmark bằng pseudopeople của IHME, Đại học Washington, mô phỏng một thị trấn giả ở Mỹ với hồ sơ từ census, 2 khảo sát hộ gia đình, WIC, Social Security, W-2 và 1040 giai đoạn 2020-2040, cộng thêm lỗi thực tế.
Bộ dữ liệu có 1.000 identity, một nửa là 1 người có nhiễu, một nửa là over-merge. Các loại nhiễu gồm typo Valentino thành Valentinp, ký tự đọc nhầm Sam thành 5am, viết theo âm Phillips thành Filips, ngày tháng hoán đổi, giá trị copy từ người thân, biệt danh Robert thành Bob, tên giả Valentino thành Female Child, và trường trống.
Bài Hightouch đăng ngày 04/11/2026, thread Hacker News đăng ngày 06/11/2026 lúc 19:48 UTC, tới khoảng 23:25 VN ngày 07/11/2026 thì đạt 536 điểm và 131 bình luận.
Bảng kết quả test dễ và dải leo thang 30-90% cho ra 98,8% với $0,88
Dải 30-90% là điểm ngọt nhất: 22% ca leo thang đổi 98,8% với $0,88 cho mỗi 1.000 quyết định. Con số 98,8% nghĩa là hybrid Jev kém Opus 0,2 điểm, tức 12 ca sai trên 1.000 thay vì 10 ca, đổi lại rẻ hơn khoảng 4,4 lần. Mở rộng dải lên 10-90% thì tốn gần gấp đôi mà không tăng thêm điểm nào. Hybrid Luna tốt nhất, dải 10-90% với 6% ca, đạt 98,5% với FP 9, FN 6, 0,30 giây, 0,33 đô, rẻ hơn hybrid Jev nhưng kém 0,3 điểm. Đây là số hãng tự đo trên dữ liệu giả lập, bài gốc không kèm code mẫu.
| Dải leo thang | Ca leo thang | Độ chính xác | FP / FN | Thời gian | Chi phí |
|---|---|---|---|---|---|
| 50-80% | 7% | 97,5% | không nêu | không nêu | $0,31 |
| 50-90% | 17% | 97,9% | không nêu | không nêu | $0,71 |
| 30-90% | 22% | 98,8% | 5 / 7 | 0,63 giây | $0,88 |
| 10-90% | 40% | 98,8% | không nêu | không nêu | $1,58 |
| 10-100% | 74% | 99,0% | không nêu | không nêu | $2,92 |
| Opus một mình | 100% | 99,0% | 3 / 7 | 2,2 giây | $3,86 |
Test khó của Hightouch cho thấy hybrid Jev còn nhỉnh hơn Opus một mình
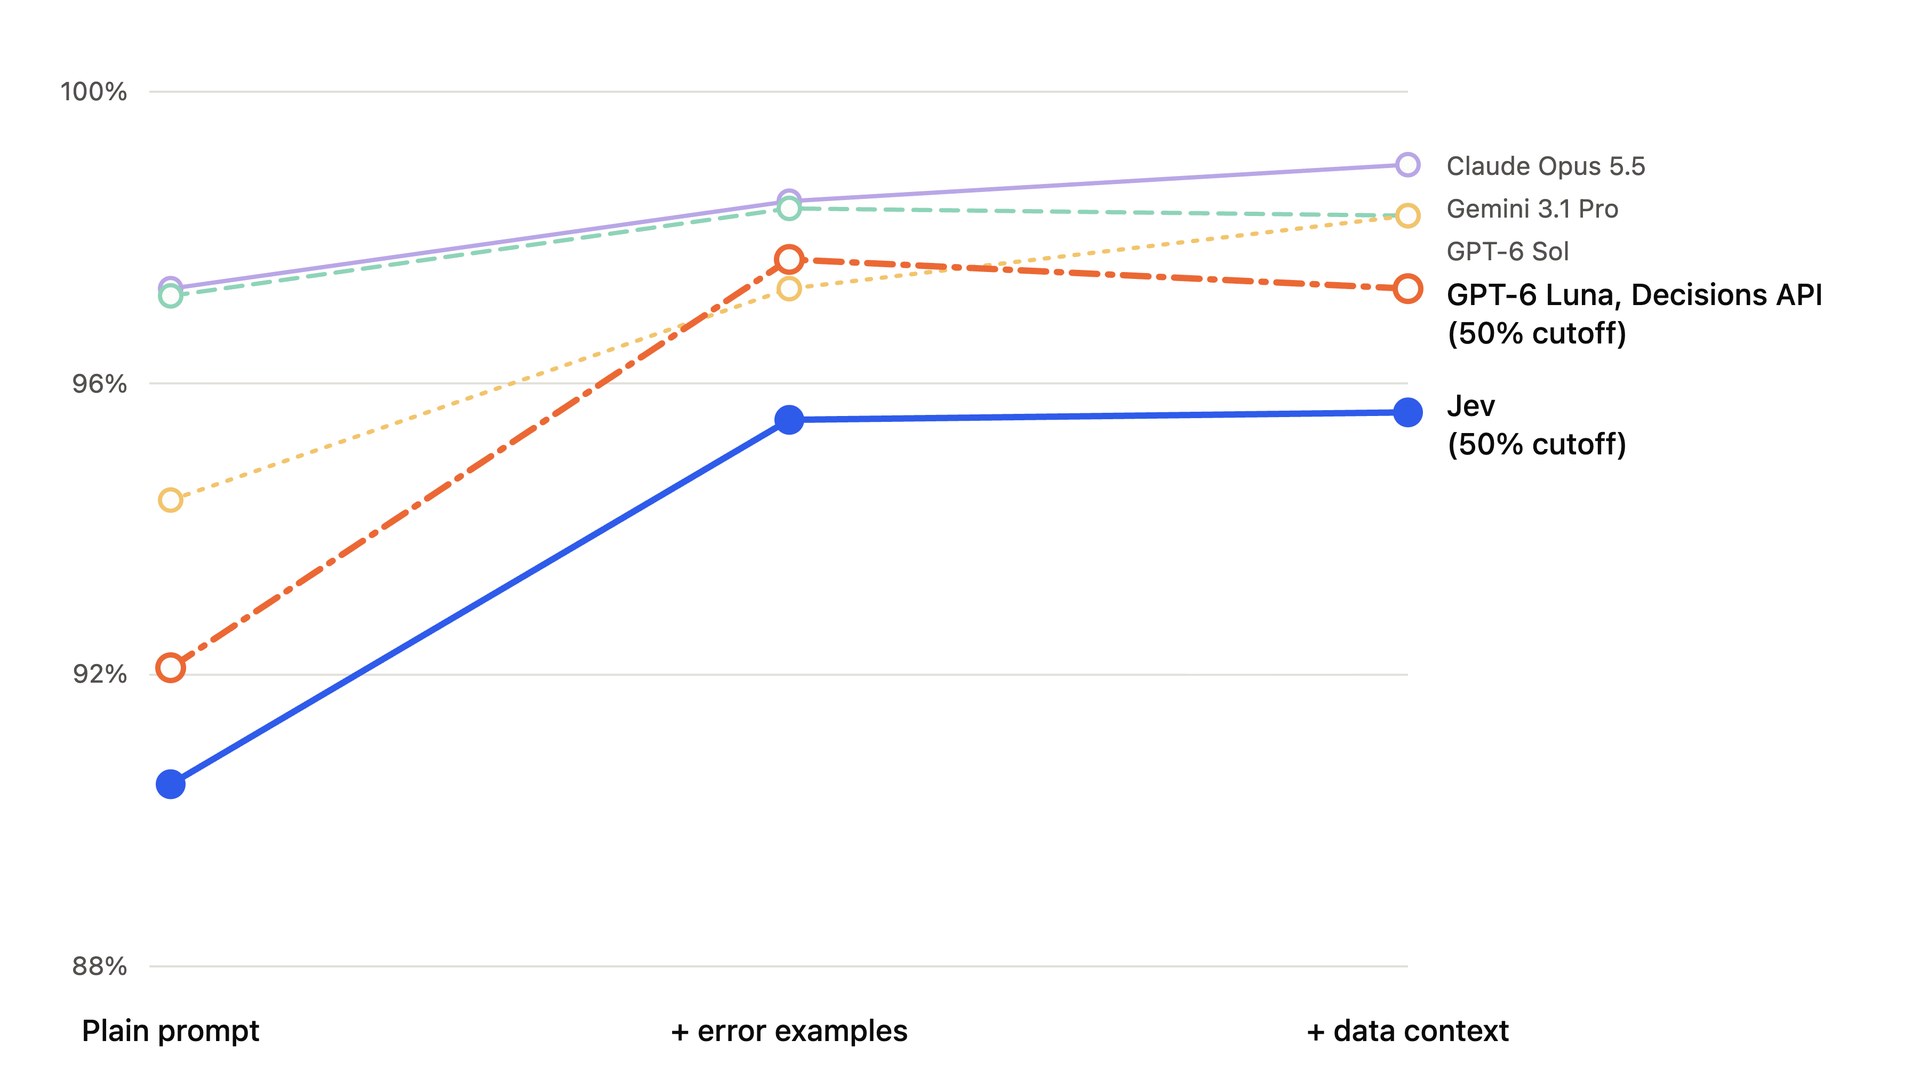
Test khó của Hightouch là typo ở trường quan trọng cộng over-merge giữa các cặp giống nhau như sinh đôi, cha con cùng tên, trùng tên. Opus 5.5 một mình đạt 95,1% với 2,6 giây và 5,39 đô cho mỗi 1.000. Hybrid Jev đạt 95,3% với 1,56 giây và 2,94 đô, hybrid Luna sụt còn 91,6% với 0,70 giây và 1,15 đô.
Jev một mình chỉ 89,1% với 0,06 đô và Luna một mình 88,8% với 0,12 đô. Tỉ lệ leo thang trên test khó ước tính khoảng 53% theo tính toán của commenter ezotony trên Hacker News, lấy 2,94 trừ 0,06 rồi chia 5,39, so với khoảng 22% ở test dễ, chưa được Hightouch xác nhận. Cảnh báo nhỏ: chênh 0,2 điểm trên 1.000 mẫu có thể chỉ là nhiễu.
Jev làm người gác cổng được vì lỗi của nó nằm ở vùng tin cậy thấp
Luna chạy lẻ giỏi hơn mà hybrid Luna lại thua, mâu thuẫn này chỉ gỡ được bằng calibration.
Calibration đo độ trung thực của con số tin cậy, ECE càng thấp càng thật
Calibration là mức độ khớp giữa xác suất model tự báo và tỉ lệ đúng thật, ví dụ model nói 90% cho 100 ca thì nên đúng khoảng 90 ca, còn nói 90% mà chỉ đúng 77% thì nó đang quá tự tin. ECE là Expected Calibration Error, sai số hiệu chuẩn kỳ vọng, số càng thấp càng trung thực. Nói nôm na thì chỉ hỏi một câu thôi, model nói chắc bao nhiêu thì đúng bấy nhiêu không.
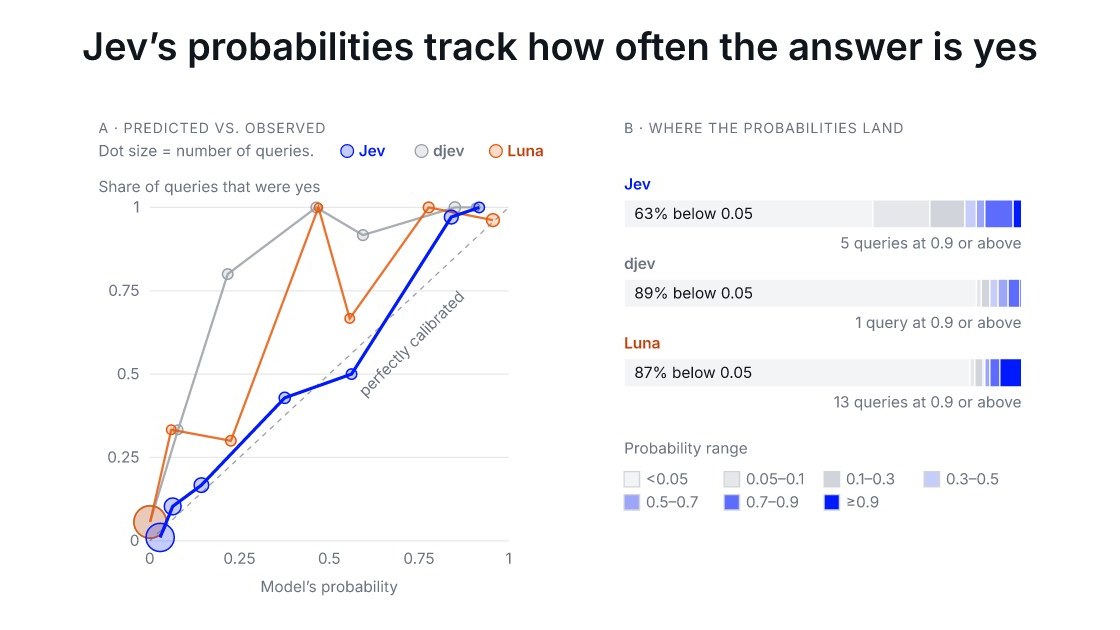
Samaya đã đo chỉ số này trên 238 query tìm kiếm về nhu cầu broad market research, với 2 annotator độc lập và khoảng 15% positive. Kết quả là Jev ECE 0,033, Luna ECE 0,062, djev bản mở là 0,089. AUROC của Jev và djev là 0,95, Luna là 0,91, nên khả năng xếp hạng của ba model gần như ngang nhau, điểm ăn thua nằm ở calibration.
Ở ngưỡng mặc định 0,5 thì Jev đạt F1 76,8, Luna 71,3, djev 54,5. Chênh 5,5 điểm nhưng khoảng tin cậy bootstrap từ trừ 2,6 tới 14,2 nên không có ý nghĩa thống kê.
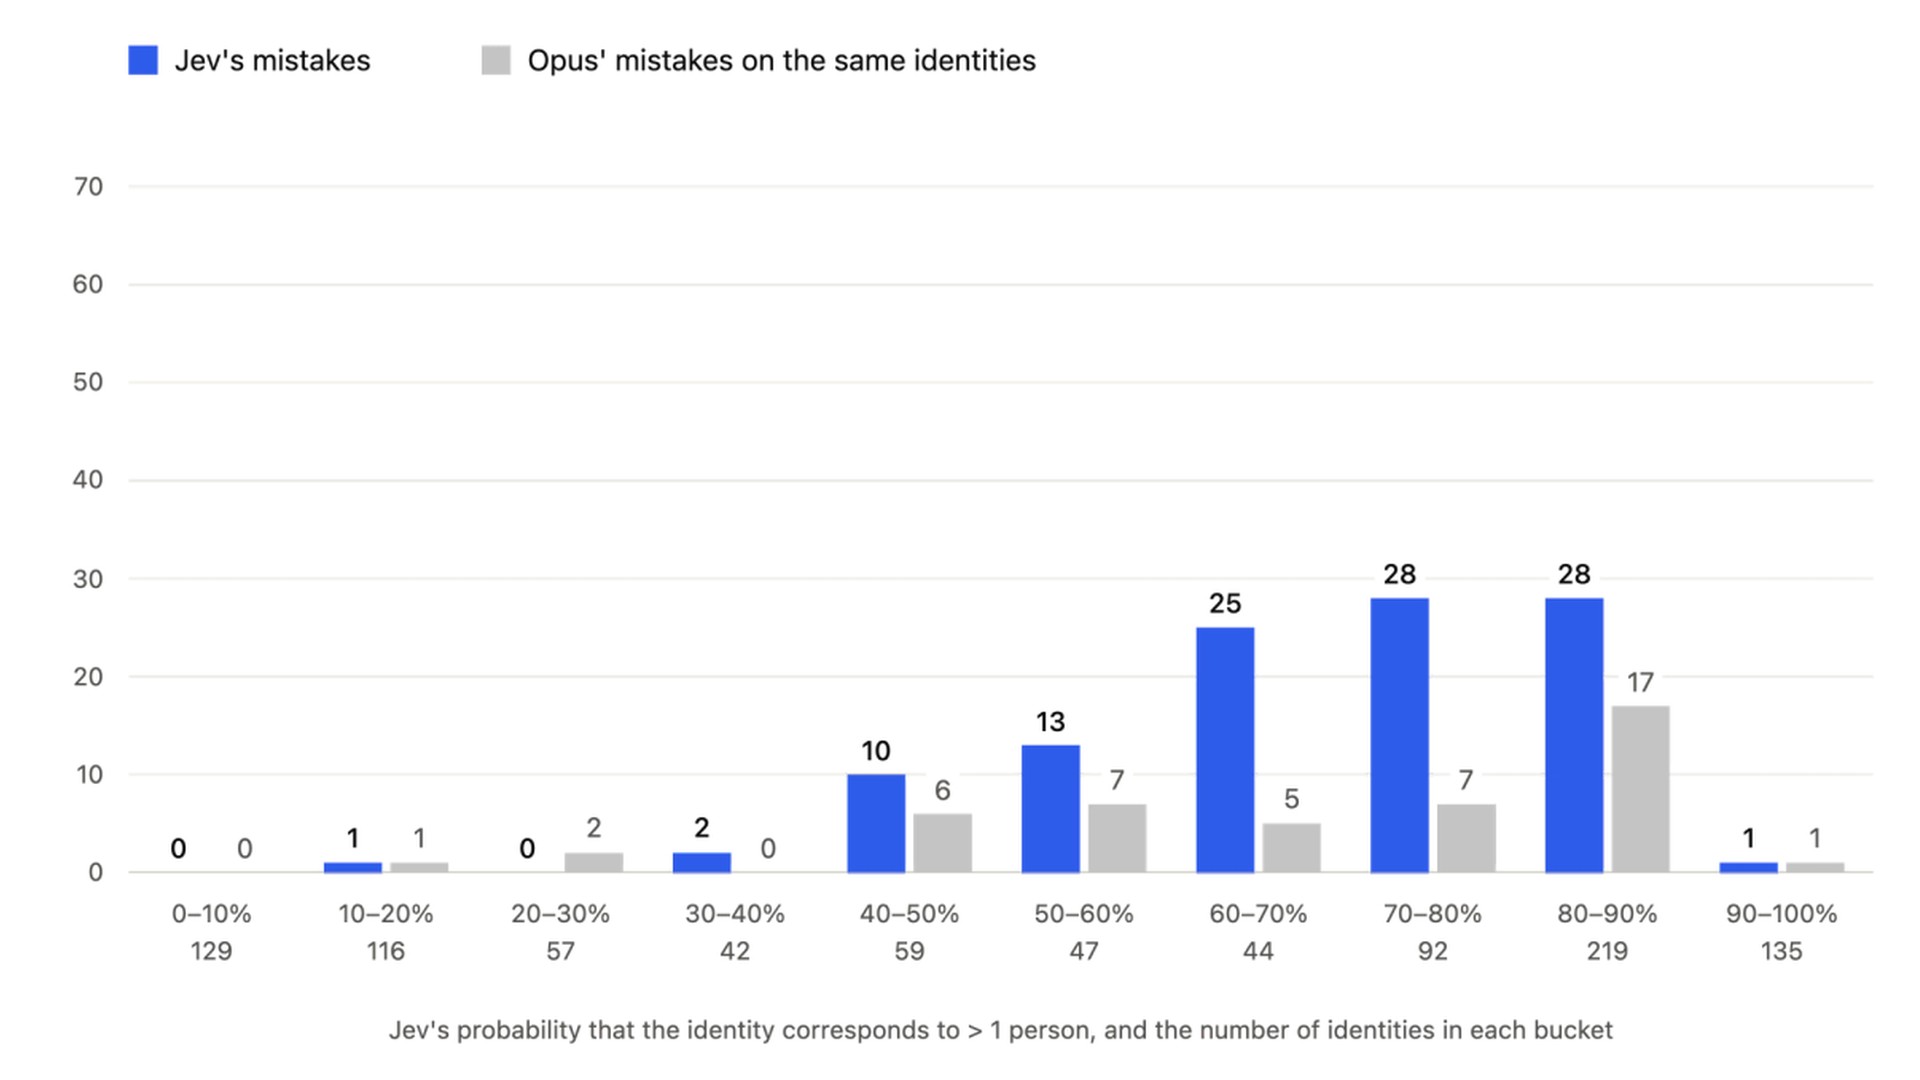
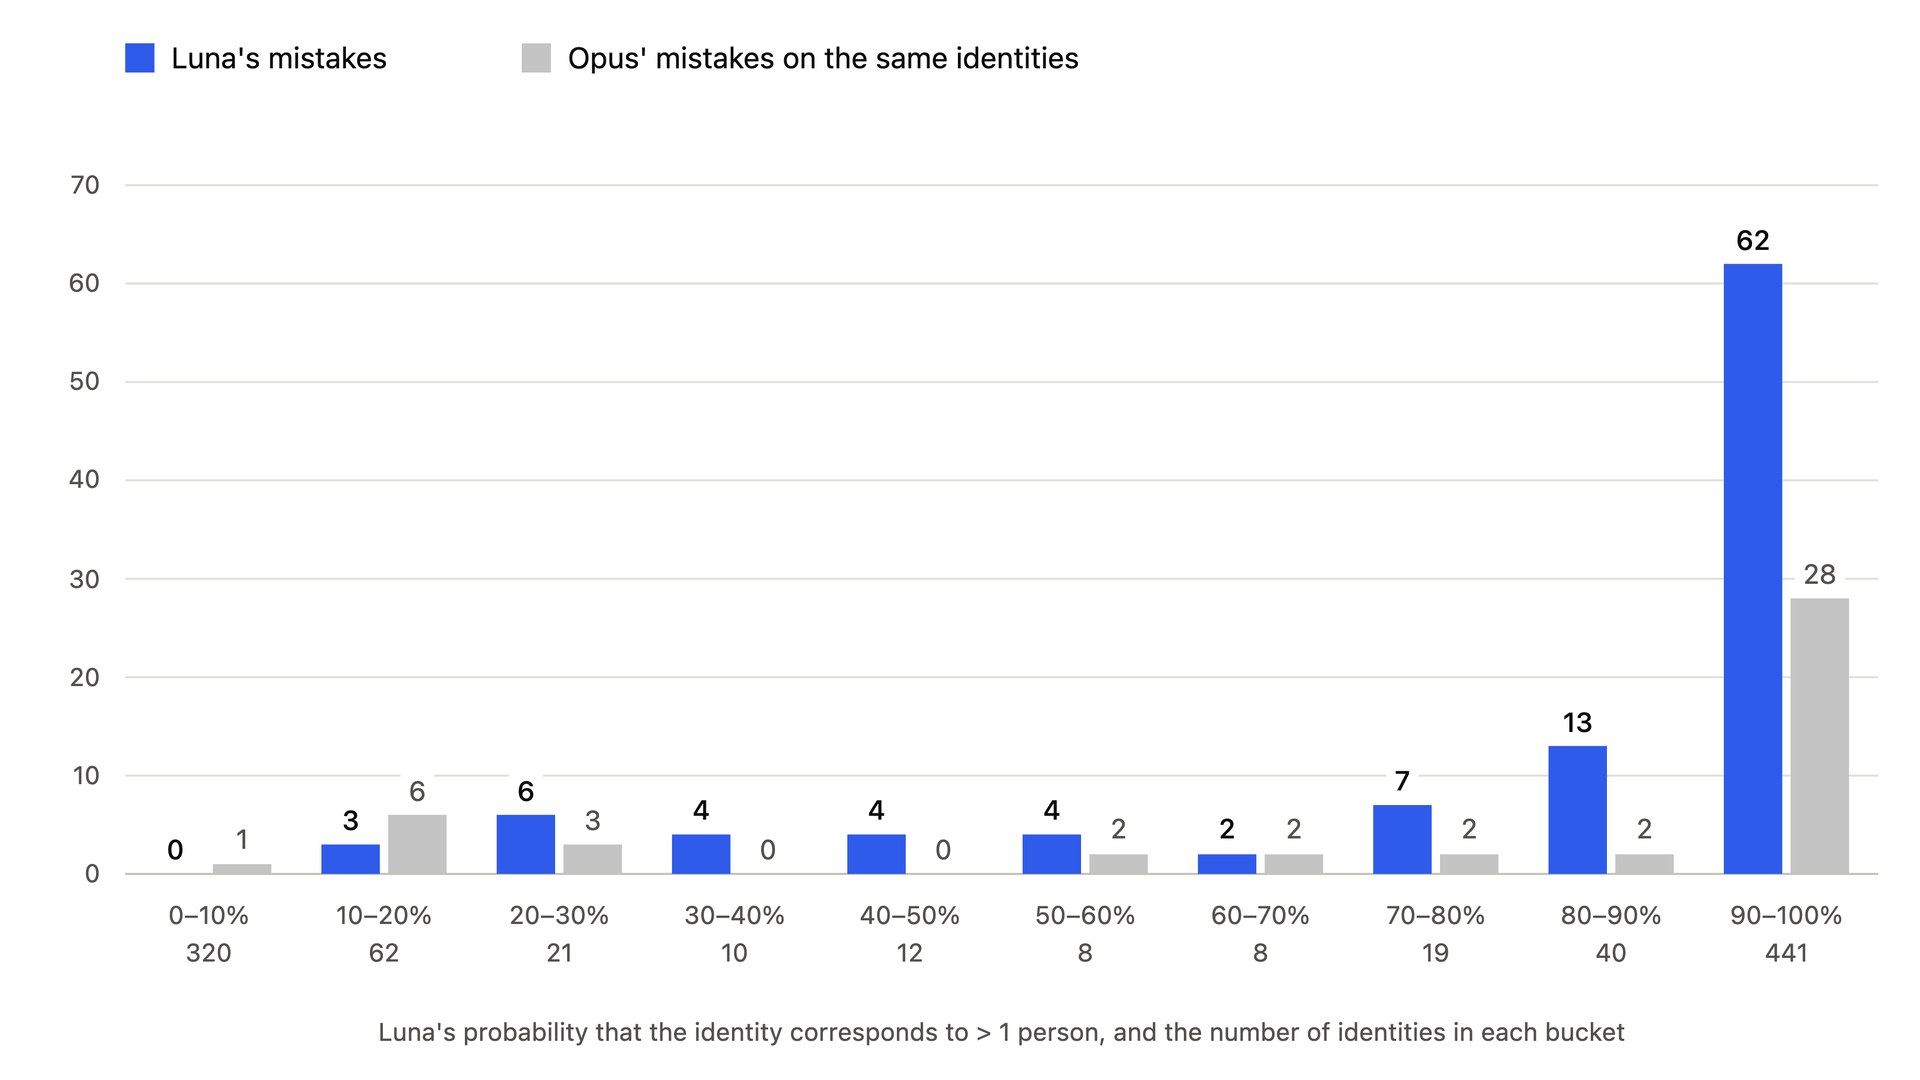
Lỗi Jev nằm gần 50% tin cậy nên dải leo thang bắt được, lỗi Luna trốn ở 90-100%
Lỗi Jev tập trung ở vùng tin cậy thấp gần 50%, nơi dải leo thang 30-90% với tới, còn lỗi Luna trốn ở vùng tin cậy 90-100%, nơi không dải leo thang nào với tới mà không leo thang gần như mọi ca. Samaya cho thấy một phần ba lỗi của Luna mang xác suất đúng bằng 0 hoặc 1, tức model chắc chắn tuyệt đối về một đáp án sai.
Trên dải Jev 0,2-0,8, chỉ 7,6% query gửi cho LLM mà F1 đã đạt 79,7, ngang LLM một mình, bắt được 5 trên 8 lỗi rõ của Jev, trong khi cùng dải đó Luna chỉ bắt 3 trên 10 lỗi. Jev dự đoán số lỗi của chính nó khá chuẩn, kỳ vọng 17,5 lỗi và thực tế mắc 14,5 lỗi, còn Luna kỳ vọng chỉ 5,3 lỗi nhưng mắc tới 16,5 lỗi.
Tiết kiệm 4 lần chỉ đúng trên test dễ của Hightouch, test khó còn 1,8 lần
Con số 4 lần cần được đặt lại đúng chỗ, vì nó là kết quả của một độ khó cụ thể.
Test dễ Hightouch rẻ hơn 4,4 lần và Banking77 rẻ hơn 3,5 lần
Test dễ Hightouch rẻ hơn 4,4 lần, hybrid Jev 98,8% so với Opus 99,0%, chỉ leo thang 22% ca. Banking77 của OpenRouter là kiểm chứng độc lập thứ nhất cho cùng hướng kết luận trên một task khác hẳn, với 3.080 utterance, 77 intent ngân hàng, 40 mẫu mỗi intent, median 9 từ.
Jev 1.13 đạt 81,0% với khoảng tin cậy 95% từ 79,6 tới 82,3, macro-F1 80,5%. Opus 5 đạt 84,4% với khoảng tin cậy 83,1 tới 85,6, macro-F1 83,6%. Chênh 3,3 điểm với khoảng tin cậy bootstrap 2,3 tới 4,4 điểm, hai model đồng ý nhau 89,3%, Opus đúng một mình 175 ca, Jev đúng một mình 72 ca.
Cascade Banking77 theo ngưỡng: 0,99 đạt 84,3% với 1,13 đô; 0,95 đạt 84,2% với 0,88 đô; 0,90 đạt 84,0% với 0,69 đô, Jev giữ 75,9% ca, kém Opus tối đa 0,4 điểm, rẻ 3,5 lần.
Nới ngưỡng xuống nữa thì tiền càng nhẹ, mà điểm thì gần như đứng yên: 0,80 đạt 83,6% với 0,53 đô; 0,70 đạt 83,2% với 0,42 đô. Jev p50 175 ms, p95 270 ms, 0,11 đô cho mỗi 1.000. Opus p50 2.266 ms, p95 3.004 ms, 2,42 đô đã cache prompt, không cache thì khoảng 19 đô, tức Jev nhanh khoảng 13 lần và rẻ khoảng 1 phần 22. Lưu ý là Opus trong test này là Opus 5, bản cũ hơn Opus 5.5, temperature 0, reasoning tắt.
Test khó Hightouch chỉ còn 1,8 lần vì hệ thống tự chuyển nhiều ca hơn cho Opus
Chia 5,39 cho 2,94 thì test khó Hightouch chỉ còn khoảng 1,8 lần, hybrid Jev 95,3% so với Opus 95,1%, tỉ lệ leo thang ước tính khoảng 53% theo ezotony, so với khoảng 22% ở test dễ. Cơ chế tự co giãn này là tính năng của hệ thống: chi tiêu tăng khi dữ liệu khó để giữ chất lượng. Vì vậy anh em cần ngân sách theo độ khó, đừng chốt một con số cố định. Khung vendor rẻ hơn tới 90 lần là khung quảng cáo, tỉ lệ thực tế trên task này là khoảng 77 lần với Jev và khoảng 39 lần với Luna.
Hybrid Luna rẻ hơn hybrid Jev nhưng kém chính xác, chỉ hợp khi dữ liệu dễ
Trên test dễ, hybrid Luna rẻ hơn hybrid Jev, 0,33 đô so với 0,88 đô cho mỗi 1.000 ở dải tốt nhất, nhưng kém 0,3 điểm, 98,5% so với 98,8%, và trên test khó thì tụt mạnh còn 91,6% so với 95,3% của hybrid Jev. Chọn Luna khi dữ liệu dễ và chấp nhận kém 0,3 điểm, chọn Jev khi dữ liệu khó hoặc cần giữ chất lượng sát Opus. Bảng quy đổi tính bằng đô, anh em tự quy đổi sang VND theo tỉ giá hiện tại lúc đọc bài.
| Số quyết định | Opus một mình | Hybrid Jev rồi Opus | Tiết kiệm |
|---|---|---|---|
| 1.000 | $3,86 | $0,88 | $2,98 |
| 100.000 | $386 | $88 | $298 |
| 1 triệu | $3.860 | $880 | $2.980 |
NavyaAI đo Jev tốn 18,57 đô cho 1 triệu quyết định, đắt hơn cả bản DIY rẻ nhất ở 16,30 đô, và mình ghi rõ số NavyaAI chỉ đọc qua search snippet. Rẻ hơn Opus 4 lần vẫn khác với rẻ nhất có thể. Cascade Jev cộng Opus là lựa chọn cân bằng, vẫn còn những bản DIY rẻ hơn nó.
Vì sao Pith nói cascade không tăng điểm mà Hightouch vẫn tiết kiệm được 4,4 lần
Nếu cascade hay vậy sao có paper nói nó gần như không tăng điểm, hai bên đo hai thứ khác nhau.
Pith đọc v1 và arXiv v3 nói trần tăng điểm chỉ 1,5 tới 2,7 điểm
Paper arXiv 2609.29769 của Delip Rao và Chris Callison-Burch nộp ngày 24/09/2026, v3 sửa ngày 13/10/2026. Paper so Jev cộng Decider, bản tái tạo mở của Perplexity, với 3 LLM judge tầm flash, trên 9 panel từ 7 benchmark có nhãn con người, mọi judge nhận cùng tiêu chí.
Pith đọc abstract v1 nói LLM lặp lại 96,0% lỗi tự tin nhất của Jev, baseline độc lập là 50,3%. Cascade tăng tối đa 1,5 điểm với ngưỡng cross-fitted và 2,0 điểm với ngưỡng oracle. Còn arXiv v3 nói trên 85% phán quyết lặp lại lỗi, cascade tốt nhất tăng 2,7 điểm so với judge đơn lẻ mạnh nhất ngay cả với ngưỡng oracle, và fallback cao cấp hơn cũng chỉ tăng tối đa 1,7 điểm. Mình dùng số v3 làm chuẩn mới nhất, Pith chỉ đọc abstract v1, chưa đọc full text và figures.
LLM judge đắt hơn 16-357 lần và chậm hơn 5-350 lần. Mỗi decision model chỉ thua đáng kể trong tối đa 6 trên 27 phép so sánh, và trên tiêu chí nhị phân thì Jev ngang hoặc hơn.
Vì sao Hightouch và Pith không mâu thuẫn nhau, lỗi tương quan là trần của cascade
Hightouch đo rẻ hơn bao nhiêu mà chất lượng gần như giữ nguyên, 98,8% so với 99,0%. Còn Pith đo tăng được bao nhiêu điểm so với judge mạnh nhất, tối đa khoảng 2 tới 2,7 điểm. Mỗi bên đúng trong phạm vi thí nghiệm của mình. Cascade là công cụ giữ chất lượng trong khi giảm tiền, không phải công cụ dùng tiền ít mà được chất lượng cao hơn.
Nguyên nhân trần là lỗi tương quan, model lớn sai cùng chỗ với model rẻ. Abstract arXiv viết gọn một câu là cascade cần fallback đúng ở đúng chỗ tầng đầu sai, nhưng LLM judge phần lớn sai cùng chỗ với Jev. Jury trung vị 3 LLM judge cũng không hơn judge đơn lẻ giỏi nhất, và muốn tăng chính xác thì cần fallback sai khác chỗ với tầng đầu.
Tiền đề baseline độc lập cũng mong manh, nó giả định lỗi hai bên độc lập, mà nếu hai model chia sẻ prior huấn luyện thì con số tăng điểm bị phóng đại. Phản biện trên Hacker News cũng xoáy đúng chỗ này. theptip đặt vấn đề unknown-unknowns, còn nico và mannyv nhắc kết quả chỉ cho một task cụ thể với đúng phiên bản model và tham số đó.
Headline 4 lần thấp hơn gây hiểu lầm, nên nói rẻ hơn 4,4 lần hoặc còn 23% chi phí
Tiêu đề Hacker News của theanomaly là A Jev that can ask Opus for help gives Opus accuracy at 4x lower cost, và tranh luận ngôn ngữ trong thread chê 4x lower awkward, nên nói 0,25x hay 25% giá gốc, theo intervolz, ant6n và mjuarez.
Nói cho khỏi hiểu lầm thì cứ nói rẻ hơn khoảng 4,4 lần hoặc chỉ còn khoảng 23% chi phí Opus trên test dễ, kèm điều kiện test dễ, đừng dùng 4x lower. netshade kể khi Haiku 5.5 ra thì chênh lệch chi phí gần như biến mất với task của người đó, nên mọi con số chi phí trong bài đều có hạn sử dụng, anh em cần tự đo lại giá hiện tại trước khi quyết định.
Tự thử cascade trên dữ liệu của mình thì đo ngưỡng từ mẫu có nhãn trước
Đã biết cascade ăn ở đâu và thua ở đâu, phần còn lại là đo trên dữ liệu của mình, chứ copy nguyên ngưỡng 30-90% về thì khác gì mặc áo người khác, vừa hay chật.
Đừng copy ngưỡng 30-90% của Hightouch, đo lại trên mẫu có nhãn của mình
Ngưỡng 30-90% của Hightouch tối ưu cho task over-merging trên dữ liệu pseudopeople, nó chỉ đúng cho task đó. Cách làm đúng là lấy mẫu có nhãn của mình, chạy Jev lấy xác suất, vẽ độ chính xác theo bucket tin cậy, rồi kiểm tra lại trên mẫu giữ lại. Bảng cascade của OpenRouter dùng đúng cùng 3.080 mẫu đã đo nên nó là upper bound, chỉ để tham khảo trần, đừng lấy làm kỳ vọng thực tế.
Cảnh báo calibration OOD: nghiên cứu độc lập đo ECE ngoài phân phối là 0,107 so với noise floor 0,024. Trên task cố tình không thể biết, Jev cho xác suất trung bình 0,74 mà chỉ đúng 44,7%, và 1.051 trên 2.000 xác suất trả về đúng 0,00, nguồn thứ cấp qua Reticle và LMSPedia, chưa đọc repo gốc trực tiếp. Trên Hacker News, gbrindisi, dangoodmanUT, xfalcox và ghempton đều dùng hybrid tương tự và hiệu quả sau hiệu chuẩn ban đầu, trong đó dangoodmanUT giảm 70% khối lượng với 0% mất chất lượng theo benchmark của họ.
Ba mốc ngưỡng tham khảo, band 0,2-0,8 của Samaya và ngưỡng 0,95 của Teti
Ba mốc tham khảo dưới đây là điểm xuất phát để đo, anh em đo lại rồi mới dùng, đừng copy nguyên. Samaya dùng band Jev 0,2-0,8 với 7,6% query gửi cho LLM, F1 đạt 79,7 ngang LLM một mình, bắt 5 trên 8 lỗi rõ của Jev.
Daniele Teti trên email thật đặt ngưỡng hành động không cần xác nhận ở 0,95, tin cậy trên 0,95 thì đúng khoảng 96,5%, đây là test tay một người một domain, mình chỉ đọc qua search snippet nên chưa kiểm chứng sâu.
Banking77 dùng ngưỡng 0,90, Jev giữ 75,9% ca, đạt 84,0% với 0,69 đô, kém Opus tối đa 0,4 điểm. Trong 175 ca Opus sửa được ở Banking77 thì tin cậy trung vị của Jev là 0,67, 85% dưới 0,90, tức dải leo thang bắt được phần lớn ca Opus sửa được. Confidence của Jev vẫn là xác suất chưa hiệu chuẩn, dải giữa đánh giá quá cao. 58% ca tin cậy từ 0,99 trở lên thì đúng 96,3%, còn 3,5% ca dưới 0,5 thì chỉ đúng 29,6%.
Còn một điểm gợn nữa ở Banking77 là cả hai model đều 0 trên 40 ở class get_physical_card vì nhãn này thực ra hỏi PIN gửi riêng, không đoán được từ tên, bỏ class này thì Jev 82,1% và Opus 85,5%.
Checklist triển khai cho team nhỏ, từ mẫu nhãn tới theo dõi chi phí theo volume
Checklist 5 bước cho team nhỏ ít mẫu nhãn. Bước 1, gom mẫu có nhãn đủ lớn, Hightouch cần hơn 1.000 mẫu để sai số dưới cộng trừ 1%. Bước 2, chạy Jev lấy xác suất, đo ECE và độ chính xác theo bucket tin cậy. Bước 3, chọn dải leo thang trên một nửa mẫu, kiểm tra trên nửa còn lại. Bước 4, chạy thử hybrid với Opus làm fallback, ghi chi phí theo volume 1.000, 100.000 và 1 triệu quyết định. Bước 5, theo dõi tỉ lệ leo thang hàng tuần, tỉ lệ tăng vọt là tín hiệu dữ liệu khó lên hoặc lệch phân phối.
Một lựa chọn khác là advisor của Anthropic, để Sonnet và Haiku tự gọi Opus khi cần, theo ninininino trên Hacker News.
Những task không nên giao cho Jev và cascade Jev Opus
Biết cách thử rồi thì cần biết lúc nào dừng lại.
Task cần suy luận dài, giải thích và audit lý do thì Jev không hợp
Jev không viết được, không giải thích được, không thấy ảnh, yếu toán và đếm, yếu so sánh ngày tháng. Muốn Jev abstain thì tự thêm lựa chọn không đủ bằng chứng, vì Jev không tự abstain được.
Các câu hỏi trong một call không thấy đáp án của nhau, context tối đa 32K cho state cộng câu hỏi dài nhất, 64K mỗi request, vượt là lỗi, và cái gọi là không hallucinate thì chỉ đảm bảo đúng schema, chứ không đảm bảo đúng nội dung. Task cần audit được lý do thì không nên dùng Jev làm tầng duy nhất, vì Jev chỉ trả đáp án kèm xác suất, không có giải thích để kiểm tra lại. Task cần suy luận dài nhiều bước thì nên giữ LLM làm chính, Jev chỉ hợp quyết định có đáp án rõ ràng.
Dữ liệu ngoài phân phối và lỗi tự tin cao chiếm đa số thì cascade không cứu được
Calibration của Jev không bất biến, như con số OOD đã nêu ở phần đo ngưỡng, ECE ngoài phân phối lên tới 0,107, nguồn thứ cấp, mình chưa đọc repo gốc trực tiếp.
Lỗi tự tin cao là bẫy lớn nhất. Những ca Jev sai mà tự tin cao sẽ không bao giờ tới tay Opus, theo Pith thì LLM fallback lặp lại tới 96,0% theo v1 và trên 85% theo v3 những lỗi tự tin nhất đó. Nếu trên dữ liệu của anh em mà lỗi tự tin cao chiếm đa số, hoặc dữ liệu lệch phân phối so với dữ liệu Jev đã quen, thì không nên dùng cascade, cần đo calibration OOD trước hoặc giữ Opus làm chính.
Sreenath Menon tự chạy 320 quyết định đạt 97,8% với dưới nửa xu và 7,8 giây cho cả 320 ca, nhưng cũng cảnh báo benchmark vendor tự chạy và không có paper RLCD. Đây là test tay qua search snippet.
Chọn nhanh hybrid Jev Opus, giữ Opus hay dùng Luna
Chọn hybrid Jev rồi Opus khi task là quyết định có đáp án rõ ràng, có mẫu nhãn để đo ngưỡng, calibration trên dữ liệu của mình tốt, và lỗi tập trung ở vùng tin cậy thấp. Đổi lại là chấp nhận kém Opus khoảng 0,2 điểm để rẻ hơn khoảng 4,4 lần trên dữ liệu dễ. Giữ Opus một mình khi task cần suy luận dài, giải thích, audit lý do, dữ liệu ngoài phân phối, lỗi tự tin cao chiếm đa số, hoặc chi phí sai sót cao hơn nhiều chi phí tiết kiệm được.
Còn hybrid Luna rồi Opus thì chọn khi dữ liệu dễ, chấp nhận kém 0,3 điểm so với hybrid Jev, và ưu tiên rẻ hơn, 0,33 đô so với 0,88 đô cho mỗi 1.000 trên test dễ. Tránh Luna khi dữ liệu khó vì hybrid Luna sụt còn 91,6% trên test khó. Giá Opus 5.5 tham chiếu là 4 đô input và 20 đô output cho mỗi triệu token, giảm từ 5 và 25 đô của Opus 5. Cache read 0,20 đô, cache write 5 đô, output nhanh hơn Opus 5 trên 30%, rẻ hơn khoảng 40% trên workload điển hình theo Anthropic, giá này qua nguồn thứ cấp.
Jev cộng Opus đáng thử khi dữ liệu của anh em giống dữ liệu Hightouch đã đo
Jev nhờ Opus chấm lại ca khó là một cách giữ chất lượng trong khi giảm tiền, và giá trị của nó nằm ở chỗ anh em đo lại trên dữ liệu của mình trước khi tin con số 4 lần.
Ba con số chính để mang về: hybrid Jev 98,8% với 0,88 đô so với Opus 99,0% với 3,86 đô trên test dễ, test khó hybrid Jev 95,3% với 2,94 đô so với Opus 95,1% với 5,39 đô, và trần tăng điểm theo Pith và arXiv v3 chỉ 2,7 điểm.
Tức đừng kỳ vọng cascade cho thêm điểm, nó chỉ cho anh em giữ điểm với ít tiền hơn. Điều kiện dùng gói gọn trong ba ý: calibration tốt, lỗi nằm ở vùng tin cậy thấp, có mẫu nhãn để đo ngưỡng. Điều kiện không dùng cũng ba ý: task cần giải thích, dữ liệu ngoài phân phối, lỗi tự tin cao chiếm đa số.
Đo trước trên dữ liệu của mình, rồi mới tin con số 4 lần.
Nguồn tham khảo
Hightouch, LLM Judges for Identity Resolution at 4x Lower Cost: https://hightouch.com/blog/llm-judges-identity-resolution
Hacker News, thread 50397429: https://news.ycombinator.com/item?id=50397429
OpenRouter, Jev vs Claude Opus 5 Classification (Banking77): https://openrouter.ai/blog/insights/jev-vs-claude-opus-5-classification/
arXiv, paper 2609.29769: https://arxiv.org/abs/2609.29769
Pith, paper 2609.29769: https://pith.science/paper/2609.29769
OpenAI, Decisions API: https://openai.com/index/decisions-api/
OpenAI, API changelog: https://developers.openai.com/api/docs/changelog
OpenAI, Decisions API guide: https://developers.openai.com/api/docs/guides/decisions
Samaya, Calibrated Decision Models: https://samaya.ai/blog/calibrated-decision-models
OpenRouter, Jev vs LLM When to Use Each: https://openrouter.ai/blog/tutorials/jev-vs-llm-when-to-use-each/
OpenRouter, Jev vs LLM as a Judge: https://openrouter.ai/blog/tutorials/jev-vs-llm-as-a-judge/
Daniele Teti, Jev TypeSafe Delphi benchmark: https://www.danieleteti.it/post/jev-typesafe-delphi-benchmark-en/
Sreenath Menon, Jev the AI that returns a decision not a paragraph: https://sreenathmenon.com/blog/2026-09-20-jev-the-ai-that-returns-a-decision-not-a-paragraph/
Reticle, What Jev Cannot Do: https://www.reticle.sh/blog/what-jev-cannot-do
LMSPedia, Jev Limitations Calibration Confidence: https://lmspedia.org/jev-limitations-calibration-confidence/
NavyaAI, Jev TypeSafe Limitations Production: https://www.navyaai.com/blog/jev-typesafe-limitations-production
Zolty, Reviewing Jev Decision Model: https://blog.zolty.systems/posts/2026-09-25-reviewing-jev-decision-model/
Fractional, Jev Typed Decision Models: https://www.fractional.company/insights/jev-typed-decision-models
M. Clark, Identity Resolution post: https://m-clark.github.io/posts/2026-11-05-identity-resolution/
Unite.AI, OpenAI Decisions API Generally Available: https://www.unite.ai/openai-makes-decisions-api-generally-available-with-gpt-6-luna/

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Ram Altman gửi email báo RAM nhàn rỗi cho Sam Altman mỗi ngày
- Board Nvidia mở điều tra độc lập về Jensen Huang ngày 08/11, CEO thừa nhận ngoại tình nhưng cáo buộc gián điệp vẫn chưa được chứng minh
- Goldman Sachs thu hồi Claude Code khỏi tay banker và trader, chỉ để lại cho 12.000 kỹ sư
Bình luận & Trao đổi