📑 Mục lục chi tiết bài viết (33 mục)
- /teamwork đã có từ 27/08/2026, bài Google 13/11/2026 báo cáo thêm gì
- Lệnh /teamwork-preview từ 27/08/2026 đã giải 7 bài toán mở và đạt 71% trên TCSBench
- Báo cáo 13/11/2026 đưa kết quả mới trên ba model Gemini 4 và mở rộng /teamwork cho bên ngoài
- Falsifier độc lập và chia context theo cấu trúc là cách /teamwork vận hành
- Ba con số headline Weil, cờ vây 9×9 và 10 bài toán mở đọc ra sao
- Formalization giả thuyết Weil khoảng 1,8 triệu dòng Lean qua 28.800 lần gọi subagent
- Engine cờ vây 9×9 tăng khoảng 2.600 Elo lên 1.885 Elo trong chưa đầy 8 ngày
- 10 bài toán mở toán và CS lý thuyết trở lên gồm Courtade-Kumar và Deque Conjecture
- 50 triệu dòng Lean của chứng minh Courtade-Kumar thật ra chỉ có 238.690 dòng người đọc được
- Repo Courtade-Kumar đếm được 50.373.106 dòng Lean nhưng 99,5% là certificate sinh ra
- Audit trail của Courtade-Kumar vẫn mạnh với mệnh đề 63 dòng và rebuild giống hệt từng byte
- Google chỉ formalize lại chứng minh Deligne 1974, Axiom đã công bố trước một tuần
- Deligne chứng minh giả thuyết Weil năm 1974 và agent Google chỉ dịch chứng minh thành code Lean
- Axiom công bố AxiomMath/Weil ngày 06/11/2026 dưới Apache 2.0 và làm chưa đầy một ngày
- Các formalization LEAP khác cũng chưa có code công khai để kiểm chứng
- Kết quả ngoài toán học, từ NMR tới Zircon Rust và hạ tầng Borg
- NMR 95% top-1 với 30 agent, benchmark nhân quả 29 agent và Deep Review bắt lỗi thật cho STOC 2027
- FarArray, Zircon Rust và libgav1 viết lại bằng Rust, nhanh hơn được bao nhiêu
- DuoDiscover và lập lịch Borg tiết kiệm 1 PiB và giảm 24% preempt
- /teamwork, /boost, /swarm và Claude dynamic workflows khác nhau ở chỗ nào
- Subagent, /boost, /swarm và /teamwork phân biệt bằng horizon thời gian và hình dạng task
- Claude dynamic workflows spawn tối đa 1.000 subagent và khác Antigravity ở falsifier độc lập
- Auto mode đã có từ tháng 10/2026, câu chê không có auto mode đã cũ
- Dùng Antigravity /teamwork ngay hôm nay, giá Pro 19,99 USD và Ultra 99,99 USD ra sao
- Lệnh /teamwork-preview chỉ dành cho gói trả phí và chạy nhiều giờ tới nhiều ngày
- Giá Pro 19,99 USD mỗi tháng hết nhanh và Ultra 99,99 USD và 199,99 USD không có gói giữa
- Chương trình 10.000 nhà nghiên cứu dùng miễn phí 6 tháng tier cao nhất
- Kết quả nào của Google tin được, kết quả nào chưa kiểm chứng
- Có artifact thì tin được, chưa có code thì chưa kiểm chứng được
- Hacker News khen kết quả /teamwork có bằng chứng và chê bài blog viết dở
- Chọn nhanh theo nhu cầu, nhà nghiên cứu toán và CS nên thử, dev việc nhỏ nên chờ
- Bảng điểm 13/11/2026 đáng đọc nhưng phải đọc kèm dấu sao kiểm chứng
- Nguồn tham khảo
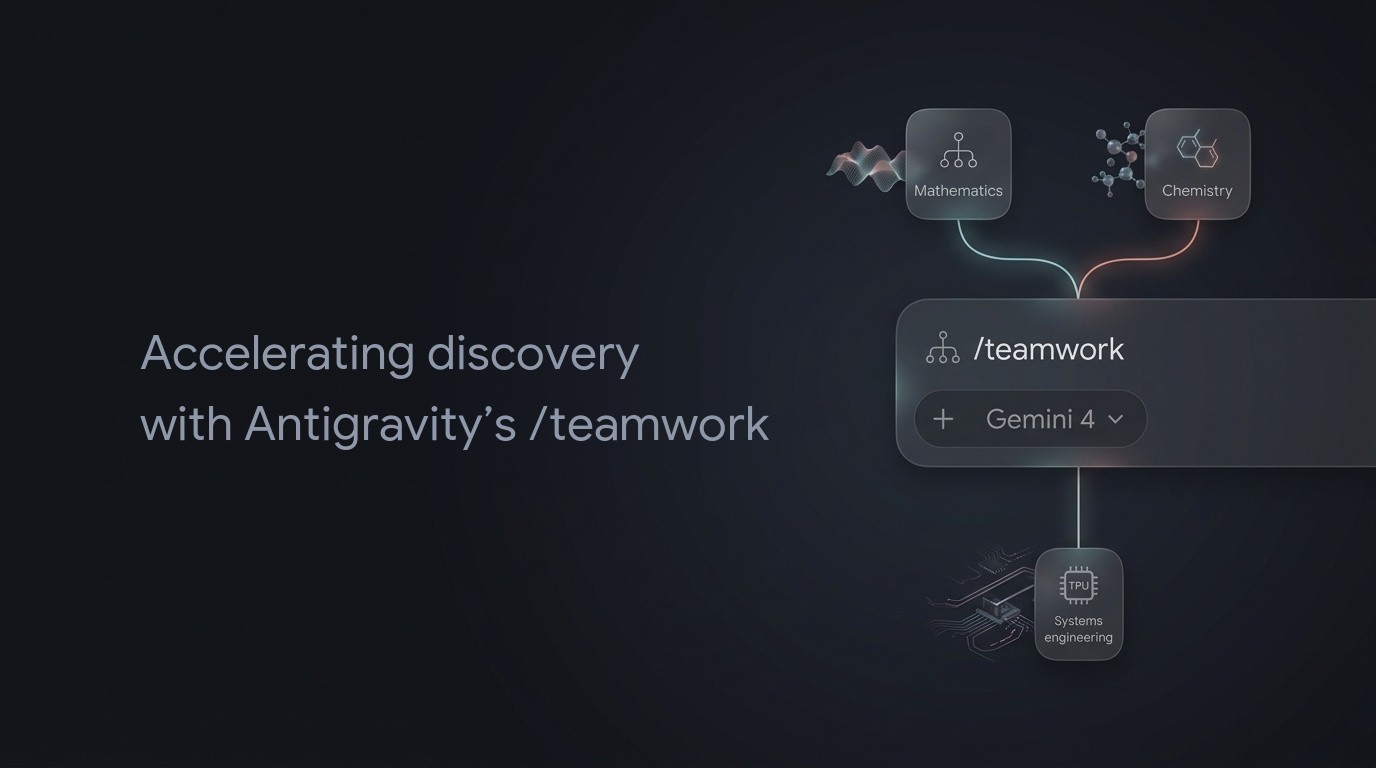
Để khỏi hiểu nhầm ngay từ đầu, /teamwork đã có từ 27/08/2026, bài Google đăng ngày 13/11/2026 chỉ là bảng điểm kết quả mới, và trong bảng điểm đó có ba con số headline là khoảng 1,8 triệu dòng Lean cho formalization giả thuyết Weil, engine cờ vây 9×9 tăng khoảng 2.600 Elo lên 1.885 Elo trong chưa đầy 8 ngày, cùng hơn 10 bài toán mở toán và CS lý thuyết đã được xử lý.
/teamwork đã có từ 27/08/2026, bài 13/11/2026 là báo cáo kết quả mới với Weil khoảng 1,8 triệu dòng Lean qua 28.800 lần gọi subagent, cờ vây 9×9 tăng khoảng 2.600 Elo lên 1.885 Elo, và hơn 10 bài toán mở, nhưng formalization Weil chưa có code công khai.
/teamwork đã có từ 27/08/2026, bài Google 13/11/2026 báo cáo thêm gì
Nói gọn lại thế này, /teamwork có từ tháng 8, bài 13/11 là bảng điểm kết quả mới.
Lệnh /teamwork-preview từ 27/08/2026 đã giải 7 bài toán mở và đạt 71% trên TCSBench
Ngày 27/08/2026, Google công bố /teamwork dưới dạng lệnh /teamwork-preview cho mọi gói trả phí, lúc đó chạy Gemini 3.7 Flash, đã giải 7 bài toán mở toán và CS lý thuyết, đạt 71% trên TCSBench, xây simulator CPU RISC-V boot được hệ điều hành từ đầu. /swarm mới là lệnh ra mắt thật sự trong đợt này, preview từ 10/11/2026.
Lúc đó /teamwork chạy bằng 5 pattern là Iterative Coding, Distributed Coding, Long Proof, Self-Verification và Document Review, và các tối ưu từ campaign đã được merge vào Eigen và ParlayHash.
Báo cáo 13/11/2026 đưa kết quả mới trên ba model Gemini 4 và mở rộng /teamwork cho bên ngoài
Bài Google Research ngày 13/11/2026 của Vahab Mirrokni nối tiếp các bài trước, đưa kết quả mới trên toán học, hóa học, code và hạ tầng với ba model Gemini 4 là Argon, Carbon và Hydrogen, Google cũng mở /teamwork và /boost cùng Deep Review rộng hơn cho bên ngoài. Trong thread Hacker News 50496811 ngày 14/11/2026, đạt 157 điểm và 36 bình luận, chính Mirrokni xác nhận nhiều phần của /teamwork đã công bố trước đó, và Gemini 4 Carbon mở cửa từ 10/11/2026 cũng là một phần của cùng đợt mở rộng đó.
Falsifier độc lập và chia context theo cấu trúc là cách /teamwork vận hành
/teamwork tổ chức nhiều agent chuyên biệt thành một team, mỗi agent một vai, có agent khác phê bình và kiểm chứng lại, để khắc phục hai giới hạn của model ngôn ngữ, model sinh đáp án khó đoán nên phải thử song song nhiều hướng rồi để bộ kiểm chứng độc lập loại đáp án sai, còn task dài ngày làm model lạc mất chi tiết vì context phình ra nên phải chia context theo cấu trúc, mỗi agent chỉ thấy đúng file và tool cần cho bước của nó.
Falsifier là checker máy khách quan, Lean 4 checker, test suite gốc không được sửa, simulator và bộ đếm phần cứng, một ứng viên chỉ được chấp nhận khi qua được falsifier, agent tự tin tới đâu cũng chưa đủ.
Ba con số headline Weil, cờ vây 9×9 và 10 bài toán mở đọc ra sao
Ba con số này đang được chia sẻ nhiều nhất, mà mỗi con số lại có một dấu sao riêng.
Formalization giả thuyết Weil khoảng 1,8 triệu dòng Lean qua 28.800 lần gọi subagent
LEAP, làm cùng Google Cloud AI và chạy với Gemini 4 Argon, đã tự động tạo ra formalization kiểm chứng bằng máy của các giả thuyết Weil, khoảng 1,8 triệu dòng Lean qua 28.800 lần gọi subagent, con số được ba nguồn độc lập nhắc lại giống nhau.
Deligne đã chứng minh các giả thuyết Weil từ 1974, agent chỉ dịch chứng minh thành code Lean để máy kiểm tra từng bước, và formalization Weil của Google chưa có code công khai nên chưa ai bên ngoài kiểm chứng được.
Engine cờ vây 9×9 tăng khoảng 2.600 Elo lên 1.885 Elo trong chưa đầy 8 ngày
Team hill-climbing trên Argon train engine cờ vây 9×9 từ đầu, bắt đầu từ một bản AlphaZero cơ bản, con người đặt chip và setup đánh giá, harness chạy campaign tự động, self-play nhanh hơn 2.300 lần, chỉ thăng hạng champion qua test thống kê trên record đã khóa, và trong chưa đầy 8 ngày engine tăng khoảng 2.600 Elo, đạt 1.885 Elo.
Mốc 1.885 Elo nằm giữa KataGo ở 16 và 32 visits mỗi nước đi, visits là số lần KataGo suy nghĩ thêm trước mỗi nước, càng nhiều visits thì càng mạnh, và không có code công khai cho engine cờ vây, nên đây cũng là số hãng tự đo, chưa kiểm chứng độc lập.
10 bài toán mở toán và CS lý thuyết trở lên gồm Courtade-Kumar và Deque Conjecture
Mirrokni tự liệt kê trong thread Hacker News là 10 bài toán mở trở lên, gồm chứng minh Lean 4 dài 50 triệu dòng cho Courtade-Kumar và tiến triển với Deque Conjecture của Tarjan, cùng adaptive data analysis đóng khoảng trống từ 2014, câu hỏi mở STOC 2024 về nhân ma trận Boolean, FOCS 2022 về cut sparsification, Deque Conjecture từ 1985 và cross-validation cho elastic net. Một số kết quả có artifact công khai, gồm thuật toán nhân ma trận Boolean trên arXiv:2611.06717 và Lean trong lockqueue/bmm, nhân số nguyên trong lockqueue/intmul, chặn deque trong sorrachai/SplayTree-Deque-Ordinal-Inverse-Ackermann-Bound, và chặn dưới Steiner spanner trong goranzuzic/high-dimensional-steiner-spanners.
Năm ví dụ còn lại trong danh sách của Google là câu hỏi lượng tử mở từ 2014 về hàm Boolean n-bit cần hơn n/2 truy vấn lượng tử, chặn dưới mạng thưa cho bài toán xấp xỉ khoảng cách từng cặp, câu hỏi mở 2025 về sketching chỉ cần căn log r số khác 0 mỗi hàng, online inverse linear optimization đưa thời gian từ hàm mũ xuống đa thức, và nhân số nguyên n-bit với thuật toán O(n log n) trên lưới 2D khớp GMP từng bit tới 1 tỷ bit.
50 triệu dòng Lean của chứng minh Courtade-Kumar thật ra chỉ có 238.690 dòng người đọc được
50 triệu dòng nghe như AI đã làm ra 50 triệu dòng toán, nhưng đếm thật repo công khai cho thấy chuyện khác hẳn.
Repo Courtade-Kumar đếm được 50.373.106 dòng Lean nhưng 99,5% là certificate sinh ra
Repo công khai dpwoodru/general-courtade-kumar-lean được đếm độc lập cho ra 45.510 file .lean với 50.373.106 dòng, con số 50 triệu khớp với bài Google, nhưng chỉ 1.359 file với 238.690 dòng là code chứng minh con người đọc được, còn 44.141 file còn lại, nặng 4,88 GB, là dữ liệu certificate sinh ra, chặn số trên từng mảnh không gian tham số mà Lean kernel kiểm tra, chủ yếu bằng lệnh decide.
Dưới 0,5% số dòng là chứng minh người đọc được, nên số dòng ở đây đo độ vất vả của checker chứ không đo lượng toán đã làm, và Gemini 4 Carbon đạt 85,4% trên MathArena nhưng mỗi bài tốn 15,70 USD cũng cho thấy benchmark toán của Google thì đắt và cần đọc kèm chi phí.
Audit trail của Courtade-Kumar vẫn mạnh với mệnh đề 63 dòng và rebuild giống hệt từng byte
Mệnh đề cần tin chỉ dài 63 dòng trong file GeneralCK/Statement.lean, README ghi rebuild sạch với file .olean cuối giống hệt từng byte, được Lean comparator chấp nhận so với mệnh đề trong google-deepmind/formal-conjectures, và toàn bộ 22.107.215 declarations được checker ngoài con-leche của Lean FRO chấp nhận, từ 23/09 tới 15/10/2026. Chứng minh Courtade-Kumar cũng không mới, preprint đăng ngày 21/09/2026 trên arXiv:2609.24931, và đã có nhiều chứng minh khác cùng lúc, Vu Khac Ky và Tuan Tran đăng một bản cùng ngày 21/09, Mahdavifar và Beirami đăng ngày 22/09, Kramer và Saglam đăng thêm một bản, OpenAI tung thêm 2 bản trong tháng 10.
Google chỉ formalize lại chứng minh Deligne 1974, Axiom đã công bố trước một tuần
Điểm dễ hiểu nhầm nhất trong cả bài báo cáo, tiêu đề giật gân làm người đọc tưởng AI vừa chứng minh xong giả thuyết Weil.
Deligne chứng minh giả thuyết Weil năm 1974 và agent Google chỉ dịch chứng minh thành code Lean
Pierre Deligne đã chứng minh giả thuyết Weil năm 1974, các giả thuyết này là kết quả mốc về đếm nghiệm phương trình đa thức trên trường hữu hạn, và việc agent làm là formalize lại chứng minh thành code Lean để máy kiểm tra từng bước. Bài Google về Weil chỉ link tới trang Wikipedia về giả thuyết Weil và Pierre Deligne, không có repo, không paper, không file mệnh đề, trong khi bản thân LEAP chỉ link tới paper framework arXiv:2606.03303.
Axiom công bố AxiomMath/Weil ngày 06/11/2026 dưới Apache 2.0 và làm chưa đầy một ngày
Axiom đã công bố AxiomMath/Weil ngày 06/11/2026, một tuần trước bài Google, dưới giấy phép Apache 2.0, nêu và chứng minh cả 4 giả thuyết Weil theo sách Freitag và Kiehl, README nói không có sorry, không native_decide, không thêm axiom, founder Axiom nói việc đó mất chưa đầy một ngày.
Con số 1,8 triệu dòng cũng không so sánh được nếu đứng một mình, Axiom đếm được 213.159 dòng trong repo Weil của họ, nhưng tính cả nền tảng Stacks Project thì tier AI viết là 18.356.552 dòng, tier người review là 37.378 dòng, khoảng 0,2% tổng số, nên tùy vẽ ranh giới ở đâu mà formalization Weil của Axiom là 213.000 dòng hoặc 18,6 triệu dòng.
Cho tới khi code được công bố, không ai nói được định lý nêu là gì, dùng axiom nào, có rebuild được không, hay trùng lặp bao nhiêu với công việc đã công khai, anh em có thể nghía qua Claude giải mã 16 sổ tay Gödel với Coq kiểm chứng để thấy hai cách AI tham gia toán học có kiểm chứng bằng máy, một bên dùng Coq, một bên dùng Lean.
Các formalization LEAP khác cũng chưa có code công khai để kiểm chứng
Danh sách LEAP còn dài, hơn 919.000 dòng Lean cho formalization đầu tiên của chứng minh gần đây về bài toán thứ mười của Hilbert, tái tạo formalization chứng minh blowup Navier-Stokes 3D, một trong 7 Millennium Prize, mở khoảng 90 năm, formalization đầu tiên của giả thuyết Birkhoff mở từ 1927 và giả thuyết 3D Bochner-Riesz mở hơn 50 năm, C1 regularity của hàm infinity-harmonic mở khoảng 20 năm, định lý Killip và Visan về KdV well-posed trong H-1, và kiểm chứng chứng minh informal của nhóm UCLA về Jamison Caterpillar 40 năm tuổi.
Trong danh sách đó, formalization giả thuyết 3D Bochner-Riesz còn tìm và sửa một lỗ hổng trong chứng minh informal vừa công bố, và còn có chặn trên cải tiến cho Erdős #1063. Tất cả đều chưa có code công khai được link trong bài gốc.
Kết quả ngoài toán học, từ NMR tới Zircon Rust và hạ tầng Borg
Toán học chiếm hết tiêu đề, nhưng báo cáo 13/11 còn có hóa học, benchmark và kỹ thuật hệ thống, vài con số ở đây thực dụng nhất cho dev vì gắn với test và phần cứng thật. Mình đọc tới đây thì thấy mấy con số này mới là thứ anh em cầm về dùng được ngay, vì benchmark toán thì xa, còn test pass và RAM giảm thì chạm được vào việc hằng ngày.
NMR 95% top-1 với 30 agent, benchmark nhân quả 29 agent và Deep Review bắt lỗi thật cho STOC 2027
Team NMR gồm 30 agent chuyên biệt thành vòng lặp tự sửa lỗi với simulator phổ có thông tin vật lý, đạt 95% top-1 exact match và 100% top-3 trên phân tử benchmark phức tạp, gần gấp đôi hiệu năng single-agent, trong bài toán xác định cấu trúc phân tử từ dữ liệu NMR.
Benchmark suy luận nhân quả, 29 agent chạy trên Argon trong 11,5 giờ, biến 13 bảng công khai thành benchmark 50 task, với 5 tiêu chí chấp nhận do người đặt ra.
Deep Review cho STOC 2027, 578 bài nộp, hơn 1/3 tổng số bài, đã đăng ký nhận feedback, khảo sát tác giả với N bằng 70 cho thấy 90% đánh giá feedback phần lớn hoặc gần như toàn bộ là đúng sự thật, 90% nói sẽ dùng lại, hơn 30% nói Deep Review bắt được lỗi chứng minh thực chất hoặc lỗi đánh máy có ý nghĩa toán học, 14% nói nó tìm ra khoảng trống kỹ thuật mất hơn 1 giờ để sửa, và mỗi người dùng được 2 lượt gọi Deep Review miễn phí mỗi tuần, nhưng mẫu chỉ 70 người và tự chọn nên đừng thổi phồng 90% thành kết luận chung.
FarArray, Zircon Rust và libgav1 viết lại bằng Rust, nhanh hơn được bao nhiêu
Với FarArray, Connected Components không khóa scale tới đồ thị 1 nghìn tỷ cạnh, throughput tăng 60 tới 90 lần, tốc độ tăng 40 tới 180 lần, RAM giảm 6 lần, InstantEmbedding giảm peak DRAM tới 14 lần, thời gian chạy giảm 11 tới 27 lần, và kernel TPU cho Graph Neural Networks giảm High Bandwidth Memory tới 185 lần, tăng tốc 8 tới 15 lần ở cả forward và backward.
Zircon bắt đầu từ 25% port ban đầu, campaign Argon 2 tuần viết lại phần code C++ còn lại, thêm khoảng 800.000 dòng safe Rust, pass toàn bộ unit test của kernel và boot được trên phần cứng arm64.
libgav1 được viết lại từ C++ sang khoảng 170.000 dòng Rust, đạt 100% bit-exact parity trên bộ test conformance rộng, ban đầu chậm hơn C++ gốc khoảng 4 lần, sau khi giao nhiệm vụ tối đa tốc độ thì nhanh hơn 20 tới 30% so với C++ gốc và assembly tối ưu tay, và không có code công khai được link cho 2 port này. Câu hỏi ngược trên Hacker News là nếu tối ưu C++ gốc thì liệu có lợi tốc độ hơn bản Rust không, và mình đồng tình có chọn lọc, vì 20 tới 30% là con số sau tối ưu.
DuoDiscover và lập lịch Borg tiết kiệm 1 PiB và giảm 24% preempt
Ở DuoDiscover, kernel JAX và Pallas đánh giá phần cứng đầy đủ mất 7 tới 32 phút, 4 agent song song xây bộ đánh giá proxy 23 giây gọi là yardstick, kiểm chứng liên tục bằng Kendall rank correlation, đạt tốc độ trung bình hình học 4,09 lần trên 17 kernel JAXBench và 2,99 lần trên 7 kernel Pallas vLLM TPU-Inference đã tối ưu tay.
Hạ tầng Google tiết kiệm bộ nhớ toàn fleet vượt ước tính ban đầu 1 PiB, lập lịch Borg giảm 24% số lần preempt workload TPU trên một số loại phần cứng, giữ SLO và mức sử dụng cluster, từ 2 thay đổi đã ship, và 1 PiB cùng 24% này là số hãng tự đo, người đọc ngoài không tự kiểm chứng được.
/teamwork, /boost, /swarm và Claude dynamic workflows khác nhau ở chỗ nào
Câu hỏi được hỏi nhiều nhất trong thread Hacker News, và bài gốc không trả lời. Mình thấy câu này hỏi đúng chỗ, vì chọn sai chế độ thì vừa tốn tiền vừa phí hàng giờ scoping cho việc chỉ cần 5 phút.
Subagent, /boost, /swarm và /teamwork phân biệt bằng horizon thời gian và hình dạng task
Quy tắc 10 giây theo softreviewed và Medium chia 4 chế độ theo đúng một tiêu chí là horizon thời gian, subagent cho việc lẻ vài giây, /boost cho bug logic sâu, vài giây tới vài giờ, /swarm cho job song song rộng, vài phút tới vài giờ, worker trong worktree riêng trên bảng live có verifier, còn /teamwork cho dự án horizon dài, nhiều giờ tới nhiều ngày, có phỏng vấn scoping do Sentinel Agent dẫn dắt và cổng kiểm tra milestone, và chạy /teamwork cho bug 5 phút thì phí hàng giờ cho scoping, nên anh em đừng dùng /teamwork cho mọi việc.
/boost đóng gói pattern coding lặp của /teamwork, còn /swarm preview từ 10/11/2026, cùng ngày Carbon mở rộng, conversation thành coordinator, chia task cho worker có tên, thêm verifier, trao đổi trên bảng chung, Google gợi ý Carbon cho coordinator và verifier, có trên Pro và Ultra, trong app và CLI, và Google cảnh báo swarm ngốn quota nhanh hơn nhiều so với conversation đơn. Phần Sentinel Agent và phỏng vấn scoping lấy từ trải nghiệm bên thứ ba, chưa đối chiếu tài liệu chính thức trong lượt research này.
| Chế độ | Horizon thời gian | Hình dạng task | Khi nào dùng |
|---|---|---|---|
| Subagent | Vài giây | Việc lẻ, một bước | Sửa một chỗ nhỏ, tra cứu nhanh |
| /boost | Vài giây tới vài giờ | Bug logic sâu, vòng lặp giải rồi kiểm chứng | Bug khó, cần lặp nhiều vòng |
| /swarm | Vài phút tới vài giờ | Job song song rộng, nhiều worker | Nhiều task độc lập chạy cùng lúc |
| /teamwork | Nhiều giờ tới nhiều ngày | Dự án dài, nhiều agent chuyên biệt, có milestone | Bài toán mở, formal proof, viết lại hệ thống lớn |
Claude dynamic workflows spawn tối đa 1.000 subagent và khác Antigravity ở falsifier độc lập
Claude Code có Dynamic Workflows ở dạng research preview, Claude lập kế hoạch, spawn hàng trăm subagent song song, tối đa 1.000 subagent với 16 chạy đồng thời, và kiểm chứng trước khi báo cáo lại.
Điểm khác biệt theo các bài so sánh là orchestration trong Claude Code là lớp thêm trên vòng agent đơn, còn trong Antigravity nó là khái niệm tổ chức trung tâm, Antigravity nhấn mạnh falsifier độc lập và chia context theo cấu trúc, còn Claude Code mạnh ở độ sâu terminal, auto mode và permission. Điểm độc lập của Artificial Analysis tháng 10/2026 cho thấy Claude Code 66 với Opus 5.5, 68 với Sonnet 5.5, Antigravity CLI 64 với Gemini 4 Argon. Chi phí và thời gian mỗi task, Opus 5.5 là 13,04 USD và 1,1 giờ, Gemini 4 Argon là 5,84 USD và 34,5 phút.
Nghĩa là Antigravity rẻ hơn khoảng một nửa mỗi task và nhanh hơn, nhưng điểm thấp hơn một chút, các bài so sánh này viết trước 13/11/2026 nên chưa phản ánh kết quả /teamwork mới.
| Công cụ | Điểm Artificial Analysis 10/2026 | Chi phí mỗi task | Thời gian mỗi task | Điểm mạnh thật |
|---|---|---|---|---|
| Claude Code với Opus 5.5 | 66 | 13,04 USD | 1,1 giờ | Terminal sâu, auto mode chín, privacy rõ ràng |
| Claude Code với Sonnet 5.5 | 68 | Chưa công bố riêng | Chưa công bố riêng | Điểm cao nhất trong nhóm so sánh |
| Antigravity CLI với Gemini 4 Argon | 64 | 5,84 USD | 34,5 phút | Rẻ hơn khoảng một nửa, nhanh hơn, falsifier độc lập |
Mình đọc bảng này thì thấy Antigravity rẻ hơn khoảng một nửa mỗi task là thật, nhưng điểm thấp hơn một chút cũng là thật, nên anh em nào cần rẻ và nhanh thì đáng thử, còn ai cần điểm cao nhất thì Sonnet vẫn hơn.
Auto mode đã có từ tháng 10/2026, câu chê không có auto mode đã cũ
CLI auto mode ra mắt tháng 10/2026, Auto (Preview) chạy lệnh trong sandbox và tự kiểm tra lệnh đi ra ngoài, cần app 2.23.0 trở lên, bật bằng agy --mode=auto hoặc Shift+Tab, chạy headless với –mode=auto sẽ hiện cảnh báo rồi rơi về default mode. Bình luận Hacker News nói auto mode đã có vài phiên bản và mới 1 tới 2 ngày trước trở thành mặc định, nhưng bình luận khác nói có –mode auto nhưng không truy cập được nếu không restart harness, vẫn gặp nhiều điểm dừng xin phép, phải dùng –dangerously-skip-permissions mới làm được việc, nên auto mode có thật nhưng chưa mượt hẳn.
Một giới hạn cần biết là auto mode không có cho tài khoản business và enterprise.
Dùng Antigravity /teamwork ngay hôm nay, giá Pro 19,99 USD và Ultra 99,99 USD ra sao
Câu hỏi còn lại là gõ lệnh gì, tốn bao nhiêu tiền mỗi tháng, và có cách nào dùng Argon miễn phí. Mình gom ba câu này vào một mục cho anh em khỏi phải lật lại từng bảng giá lẻ tẻ, vì tiền mới là thứ quyết định có thử được hay không.
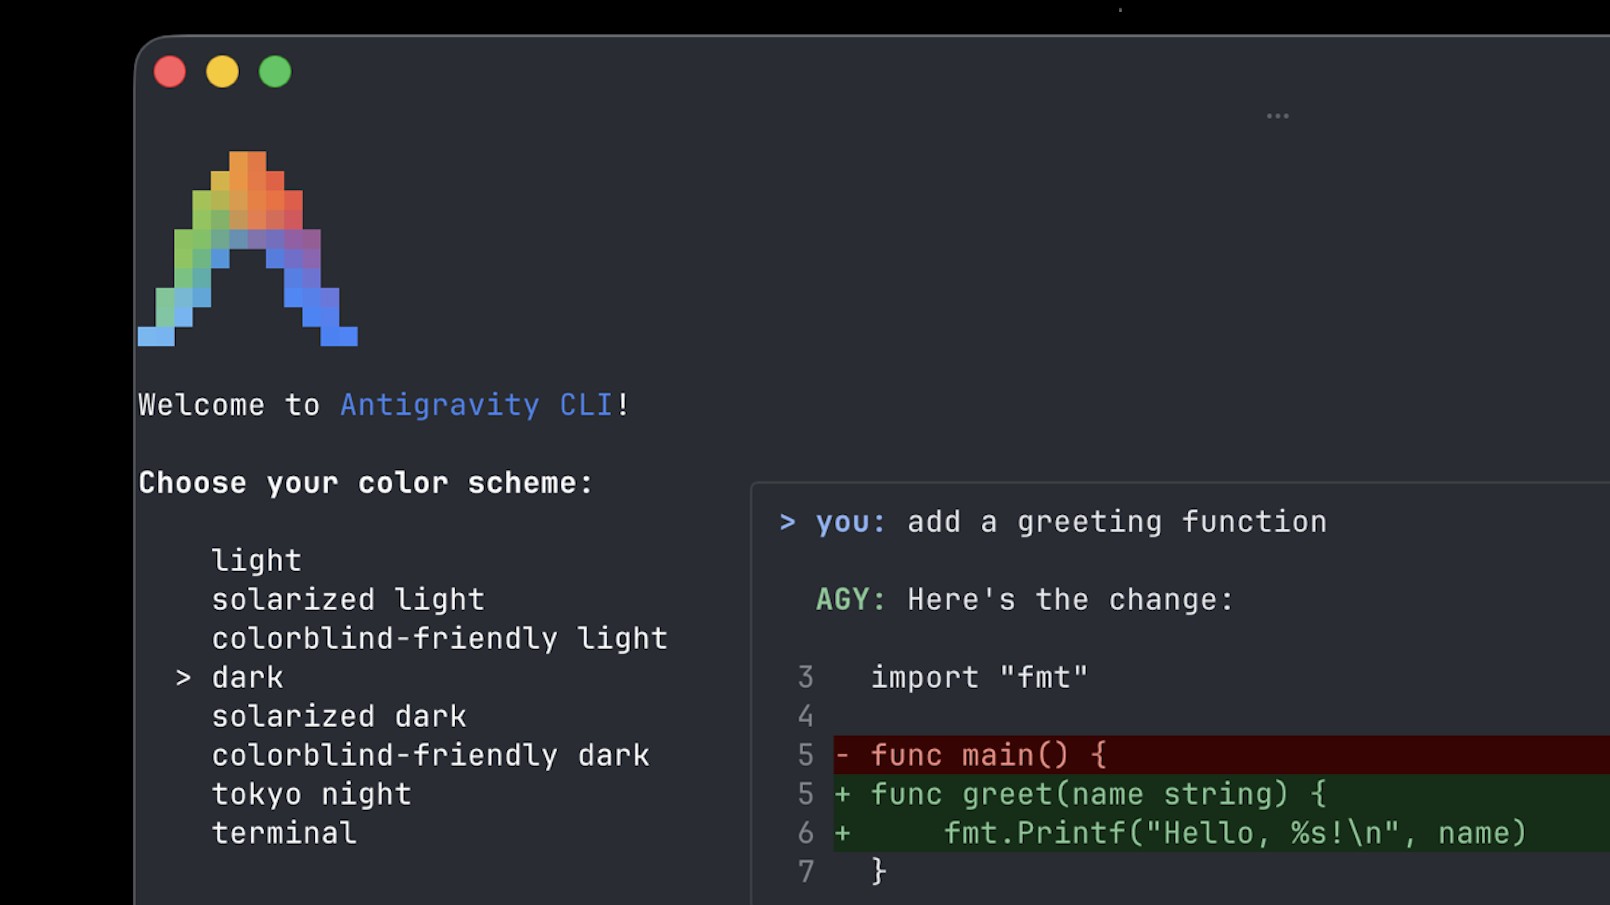
Lệnh /teamwork-preview chỉ dành cho gói trả phí và chạy nhiều giờ tới nhiều ngày
Cách gọi /teamwork là lệnh /teamwork-preview <task> trong Antigravity, chỉ dành cho gói trả phí, Gemini tự phân tích prompt và chọn cấu trúc team phù hợp, người dùng chỉ mô tả kết quả muốn đạt, không viết code orchestration, campaign chạy tự động trong nhiều giờ hoặc nhiều ngày, con người đặt mục tiêu và nghiệm thu kết quả cuối. Nhà khoa học và dev bên ngoài có thể dùng model Gemini 4 với /teamwork và /boost trong Antigravity và Deep Review ngay hôm nay, nhưng pattern formal proof vẫn chưa vào Antigravity, nên đừng tưởng gõ một lệnh là có ngay formalization Weil như trong báo cáo.
Giá Pro 19,99 USD mỗi tháng hết nhanh và Ultra 99,99 USD và 199,99 USD không có gói giữa
Giá Antigravity theo trang giá Google, kiểm chứng tới 01/11/2026, là Free 0 USD, Google AI Pro 19,99 USD mỗi tháng, Google AI Ultra 99,99 USD mỗi tháng, gấp 5 lần Pro, và 199,99 USD mỗi tháng, gấp 10 lần Pro, người dùng trả phí mua thêm được Google AI credit, và Google không công bố con số quota chính xác.
Sau 18/11/2026, gói Free và AI Plus chỉ còn Gemini 3.8 Flash. Mình nhìn bảng giá này thì thấy khoảng trống giữa Pro và Ultra là chỗ đau nhất, vì không có gói nào ở giữa cho người dùng vừa. Kinh nghiệm trên Hacker News nói Pro hết trong khoảng 2 ngày dùng casual, mua thêm credit nhưng giá không đáng, và người dùng muốn có gói ở giữa Pro và Ultra, đây là kinh nghiệm cá nhân chưa kiểm chứng độc lập, trên diễn đàn và review cũng có phàn nàn tương tự, ở Pro thỉnh thoảng bị chặn nhiều ngày sau khi hết hạn mức tuần.
Chương trình 10.000 nhà nghiên cứu dùng miễn phí 6 tháng tier cao nhất
Chương trình nhà nghiên cứu công bố 13/10/2026 cùng launch Gemini 4 Argon, tối đa 10.000 nhà khoa học được chọn, dùng miễn phí 6 tháng tier cao nhất Antigravity và model Gemini 4 Argon, dành cho nghiên cứu phi thương mại, người có affiliation đang hoạt động tại đại học, cơ sở cấp bằng, viện phi lợi nhuận hoặc lab quốc gia, gồm sinh viên thạc sĩ và tiến sĩ, phải nộp đơn qua Google form, Google chọn người được vào, nộp đơn không đảm bảo được chọn.
Tới 10/11/2026 đã nhận hơn 27.000 đơn và cấp quyền cho 3.000 nhà khoa học đầu tiên, từ 10/11 mở rộng quyền Carbon cho người tham gia, và ngoài chương trình này thì người dùng cá nhân cần gói Ultra mới dùng được Argon trong Antigravity.
Google không công bố hạn chót nộp đơn, và nâng cấp áp dụng cho tài khoản cá nhân, không qua gói Enterprise của tổ chức. Anh em nào đang làm nghiên cứu phi thương mại thì nộp đơn sớm vẫn hơn, vì 27.000 đơn đã nộp mà mới cấp cho 3.000 người, tỉ lệ chọi không hề thấp.
Kết quả nào của Google tin được, kết quả nào chưa kiểm chứng
Gom phần kiểm chứng lại thành một bảng tin được hay chưa, rồi đối chiếu với ý kiến cộng đồng cả hai phía.
Có artifact thì tin được, chưa có code thì chưa kiểm chứng được
Có artifact công khai, anh em tự tải về kiểm tra được, cứ tin, gồm Courtade-Kumar, một số thuật toán có arXiv và repo Lean như thuật toán nhân ma trận Boolean, nhân số nguyên, chặn deque, chặn dưới Steiner spanner.
Chưa có code công khai, ghi rõ luôn là chưa kiểm chứng độc lập, gồm Weil, LEAP, Zircon, libgav1, cờ vây, Borg, cùng các formalization LEAP khác như Hilbert, Birkhoff, Bochner-Riesz và Navier-Stokes.
Tiêu chí tự đánh giá mọi claim khác của Google là falsifier mạnh hay yếu, vì falsifier của Google là checker máy khách quan như Lean kernel, test suite gốc không sửa và hardware counter, nên kết quả tốt nhất trong bài đều gắn với falsifier mạnh.
Về privacy, Antigravity không có cam kết no-training công khai như Claude Code, Anthropic đã công bố rõ là không train model trên dữ liệu gói trả phí, còn Antigravity không có cam kết preview rõ ràng chống lại việc train trên code độc quyền, nên người cần privacy cho code độc quyền thì nên chờ hoặc dùng Claude Code.
| Nhóm kết quả | Ví dụ | Trạng thái kiểm chứng |
|---|---|---|
| Có artifact công khai | Courtade-Kumar, nhân ma trận Boolean, nhân số nguyên, chặn deque, Steiner spanner | Tin được, tự tải về kiểm tra được |
| Chưa có code công khai | Weil, LEAP, Zircon, libgav1, cờ vây, Borg | Chưa kiểm chứng độc lập, số hãng tự đo |
Hacker News khen kết quả /teamwork có bằng chứng và chê bài blog viết dở
Bài blog gốc viết dở thật, mình đồng tình một phần, bài gốc nhồi quá nhiều chi tiết cấp thấp kiểu Gemini tới mức người đọc phải đoán ý chính, nên bài này mở bằng ý chính rồi mới đi vào chi tiết.
Đúng là báo cáo kết quả, mình đồng tình hoàn toàn, khép lại bằng chính lời tác giả Mirrokni.
Khác Claude ở đâu, mình làm rõ bằng bảng phân biệt 4 chế độ và lệnh /teamwork-preview, đồng thời sửa hiểu lầm không có auto mode, auto mode đã có từ tháng 10/2026 và mới trở thành mặc định.
Antigravity chậm hơn trước, nghi lễ nhiều, giá Pro hết nhanh, mình đồng tình có chọn lọc, /teamwork không dành cho việc nhỏ và nghi lễ nhiều là cái giá của falsifier.
Auditor báo hoàn thành sai, mình thừa nhận giới hạn này còn nguyên, khi falsifier yếu hoặc không có, như review văn bản chung chung, vấn đề auditor báo sai vẫn còn.
User wslh kể trải nghiệm tích cực, mình đồng tình, người này dùng Antigravity không bật /boost hay /teamwork cho playground research và có phát hiện thật trong mật mã arXiv:2611.00512 cùng tăng tốc Python, repo là github.com/srw/cpython-experimental, nhưng bản Python chưa rõ ổn định, chỉ pass test đi kèm, và arXiv cùng repo chưa kiểm chứng độc lập nội dung trong lượt research này.
Một chuyên gia làm việc của cả phòng R&D, nghe lạc quan đấy, mình đồng tình có điều kiện, kết quả lớn nhất đều có chuyên gia con người kèm, falsifier mạnh và thời gian chạy hàng ngày.
Chọn nhanh theo nhu cầu, nhà nghiên cứu toán và CS nên thử, dev việc nhỏ nên chờ
Nhà nghiên cứu toán và CS có bài toán dài ngày và falsifier mạnh, đáng thử, đặc biệt qua chương trình 10.000 suất dùng miễn phí 6 tháng, vì đó là con đường rẻ nhất để chạm vào Argon. Dev làm việc nhỏ, bug 5 phút thì không nên dùng /teamwork, cứ dùng subagent hoặc /boost cho nhanh, vì chạy /teamwork cho việc nhỏ là phí hàng giờ cho scoping. Người cần privacy cho code độc quyền thì nên chờ hoặc dùng Claude Code, vì Antigravity chưa có cam kết no-training công khai rõ ràng. Anh em nào đã dùng Antigravity thật thì chia sẻ trải nghiệm ở dưới nhé.
Bảng điểm 13/11/2026 đáng đọc nhưng phải đọc kèm dấu sao kiểm chứng
Giá trị của bảng điểm 13/11 nằm ở chỗ phân biệt được phần nào đã có artifact để kiểm chứng và phần nào vẫn chỉ là số hãng tự đo.
Đọc hết bảng điểm thì còn lại mấy ý chính, /teamwork đã có từ 27/08/2026, bài 13/11/2026 là báo cáo kết quả mới, ba con số headline là Weil khoảng 1,8 triệu dòng Lean qua 28.800 lần gọi subagent nhưng chưa có code công khai, cờ vây 9×9 tăng khoảng 2.600 Elo lên 1.885 Elo trong chưa đầy 8 ngày, và hơn 10 bài toán mở trở lên, còn 50 triệu dòng Lean thì 99,5% là certificate, chỉ 238.690 dòng là chứng minh người đọc được, và Axiom đã công bố formalization Weil công khai ngày 06/11/2026 trước Google một tuần.
Nhà nghiên cứu toán và CS có bài toán dài ngày và falsifier mạnh, đáng thử qua chương trình 10.000 suất. Dev việc nhỏ và người cần privacy cho code độc quyền thì nên chờ hoặc dùng Claude Code, và anh em đã thử Antigravity hay Claude Code cho việc thật rồi thì chia sẻ trải nghiệm ở dưới nhé.
Nguồn tham khảo
- Google Research Blog, Advancing science and engineering with Antigravity’s /teamwork feature: https://research.google/blog/advancing-science-engineering-with-antigravitys-teamwork-feature/
- Hacker News, thread 50496811: https://news.ycombinator.com/item?id=50496811
- Sysnote, kiểm chứng độc lập 50 triệu dòng Lean và formalization Weil: https://sysnote.net/news/google-s-teamwork-math-claims-checked-99-5-of-the-50-million-lean-lines-are-cert
- AI Frontier Post, Google Antigravity /teamwork và giả thuyết Weil: https://aifrontierpost.com/articles/google-antigravity-teamwork-weil-conjectures/
- The Agent Times, Antigravity /teamwork mở rộng cho bên ngoài: https://theagenttimes.com/articles/google-research-makes-antigravity-teamwork-available-to-outs-4ce26b3f
- AI Profit Boardroom, Google Antigravity /teamwork 27/08/2026: https://aiprofitboardroom.com/blog/google-antigravity-teamwork/
- TechWyse, Google Antigravity /teamwork multi-agent: https://www.techwyse.com/news/ai-search/google-antigravity-teamwork-multi-agent-gemini-math-engineering
- CellCog, Google Antigravity /swarm: https://cellcog.ai/blog/google-antigravity-swarm/
- The Hype News, Google Antigravity /swarm: https://thehype.news/google-antigravity-swarm/
- SoftReviewed, Google Antigravity /boost, /swarm và /teamwork: https://softreviewed.com/google-antigravity-boost-swarm-teamwork/
- Medium, Antigravity multi-agent walkthrough: https://medium.com/@jovin2/google-antigravity-multi-agent-walkthrough-when-to-use-subagents-boost-swarm-or-teamwork-04071307afe8
- DigIntoAI, Antigravity for Science sáu tháng miễn phí: https://digintoai.com/en/articles/antigravity-for-science-six-months
- Google Roundtable, Antigravity cho nhà khoa học dùng Gemini 4 Argon miễn phí: https://geroundtable.com/google-antigravity-scientists-free-gemini-4-argon/
- Google Form, chương trình nhà nghiên cứu Antigravity: https://docs.google.com/forms/d/e/1FAIpQLScSnOMSFSm8zfM9siaXufuqAeR6ZP6R33DTzxjqJObjW61GzQ/viewform?usp=send_form
- LetsDataScience, Google Antigravity /teamwork multi-agent tools: https://letsdatascience.com/news/google-releases-antigravity-teamwork-multi-agent-tools-for-r-7ba6bf20
- AI Weekly, Google Antigravity /teamwork formalizes Weil và Hilbert: https://aiweekly.co/alerts/googles-antigravity-teamwork-multi-agent-system-formalizes-weil-hilberts-10th
- Interesting Engineering, Google Antigravity multi-agent research: https://interestingengineering.com/ai-robotics/google-antigravity-multi-agent-research
- Wattba, AI agent teams giúp chứng minh giả thuyết 2013: https://wattba.eu/news/googles-ai-agent-teams-help-prove-a-mathematical-conjecture-from-2013
- AwesomeClaude, Claude Code vs Antigravity: https://awesomeclaude.ai/claude-code-vs-antigravity
- TechTruis, 7 điều cần biết về Google Antigravity: https://techtruis.com/7-things-to-know-about-google-antigravity/
- CurioLink, Claude Code vs Codex CLI vs Antigravity CLI: https://www.curiolink.net/2026/10/claude-code-vs-codex-cli-antigravity-cli-comparison.html
- QuantSlant, Google Antigravity models, pricing và limits: https://quantslant.com/google-antigravity-models-pricing-limits-claude/
- Bito, Antigravity vs Claude Code: https://bito.ai/ai-tools/antigravity-vs-claude-code/
- BitsMinds, Claude Code vs Codex vs Antigravity 2026: https://www.bitsminds.com/news/claude-code-vs-codex-vs-antigravity-2026
- Layer3 Labs, Google Antigravity vs Claude Code: https://www.layer3labs.io/comparisons/google-antigravity-vs-claude-code
- Cubed, Google Antigravity vs Claude Code: https://cubed.run/blog/google-antigravity-vs-claude-code
- ScriptByAI, Antigravity CLI cheatsheet: https://www.scriptbyai.com/antigravity-cli-cheatsheet/
Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- OpenAI ra mắt Daybreak Red Team và Defense Factory ngày 12/11, bán vòng lặp tìm rồi vá chứ không bán thêm model
- Google Project Zero bỏ quy tắc 90+30 ngày: lỗ hổng sẽ công bố đúng hẹn dù chưa có patch
- Gemini đọc Google Wallet và tài khoản ngân hàng qua Plaid, đọc được gì, ai đọc lại, tắt ở đâu
Bình luận & Trao đổi