📑 Mục lục chi tiết bài viết (26 mục)
- Perplexity Decider v1.3 là gì: model nhận câu hỏi đóng và trả xác suất thay vì viết chữ
- Ba dạng câu hỏi gốc của Decider v1.3 là yes/no, multiple choice và score
- Locate là tính năng mới của Decider v1.3, trích đoạn văn bản kèm vị trí ký tự
- Hãng tự dùng Decider v1.3 để rà log agent và lọc chất lượng trang web như thế nào
- Decider v1.3 khác LLM sinh chữ và classifier chuyên biệt cổ điển ở chỗ nào
- LLM sinh chữ phải viết từng token rồi parse chữ, Decider v1.3 trả số để gắn ngưỡng
- Classifier chuyên biệt cổ điển rẻ nhưng mỗi task phải train riêng, Decider v1.3 nhận task mới qua câu hỏi
- Giá thật của Decider v1.3 và cách dùng miễn phí trên OpenRouter tới 19/11
- Bảng giá Decisions API của Perplexity cho Decider v1.3 và Decider Flash v1.3
- Cách dùng miễn phí trên OpenRouter và mốc 19/11 chỉ suy từ post X của Perplexity
- Con số 91,6% của hãng nghĩa là gì và điểm Decision Index 67,7 trái chiều ra sao
- Benchmark 91,6% của Perplexity đo trên 63 task phân loại query nội bộ, đáp án do frontier LLM gán nhãn
- Decision Index độc lập cho Decider v1.3 67,7 điểm, thấp hơn v1.2 là 68,0 điểm
- Test độc lập 782 quyết định của Mohammad Adyatma: Decider v1.3 thắng 4 hạng mục, thua nặng ở phân loại ảnh giao diện
- Thiết kế test 782 quyết định và kết quả tổng 5 model trên 702 item chung
- Decider v1.3 thắng 4 hạng mục triage, log, confidence và cost trong test 782 quyết định
- Decider v1.3 chỉ đạt 67,7% ở phân loại lỗi giao diện trên screenshot trong test 782 quyết định
- Cộng đồng Hacker News khen chê Decider v1.3 ra sao: senjin, waximabbax, redanddead, stri8ted, nchmy
- senjin khen Decider là model yêu thích nhưng chê v1.3 là bước lùi, stri8ted khen chạy tốt trên benchmark local
- waximabbax chê bản Flash và redanddead chê Decider thiếu sáng tạo, nchmy chỉ ra Locate có đối thủ tương đương
- Giới hạn và bẫy của Decider v1.3 cần biết trước khi tích hợp
- Ngưỡng xác suất của Decider v1.3 phải tự tune trên dữ liệu của mình, không dùng ngưỡng cố định
- Chạy local Decider v1.3 cần GPU chứa khoảng 49 GiB weights và repo Hugging Face vẫn ghi private
- Flash thua Jev ở finance, programming và law, và Decider v1.3 không đọc được PDF hay audio
- Nên thử hay chờ: chọn bản Decider nào cho từng việc
- Nguồn tham khảo
Perplexity Decider v1.3 ra mắt ngày 12/11/2026, dùng miễn phí trên OpenRouter trong tuần đầu, giá sau đó chỉ 0,02 USD cho mỗi triệu token đầu vào với bản lớn và 0,01 USD với bản Flash, token đầu ra miễn phí, mà điểm đáng chú ý nhất là model này không viết chữ, nó chỉ trả xác suất cho câu hỏi đóng.
Decider v1.3 ra mắt 12/11/2026, model quyết định trả xác suất thay vì sinh chữ, miễn phí trên OpenRouter trong tuần đầu, các bên theo dõi ghi hạn 19/11, giá sau đó 0,02 USD cho mỗi triệu token đầu vào, bản Flash 0,01 USD. Hãng tự đo 91,6% trên 63 task, test độc lập 782 quyết định cho 91,0% và thắng 4 hạng mục, nhưng yếu ở ảnh giao diện với 67,7%.
Perplexity Decider v1.3 là gì: model nhận câu hỏi đóng và trả xác suất thay vì viết chữ
Cần hiểu đúng thứ này làm gì trước đã, vì Decider không phải chatbot.
Ba dạng câu hỏi gốc của Decider v1.3 là yes/no, multiple choice và score
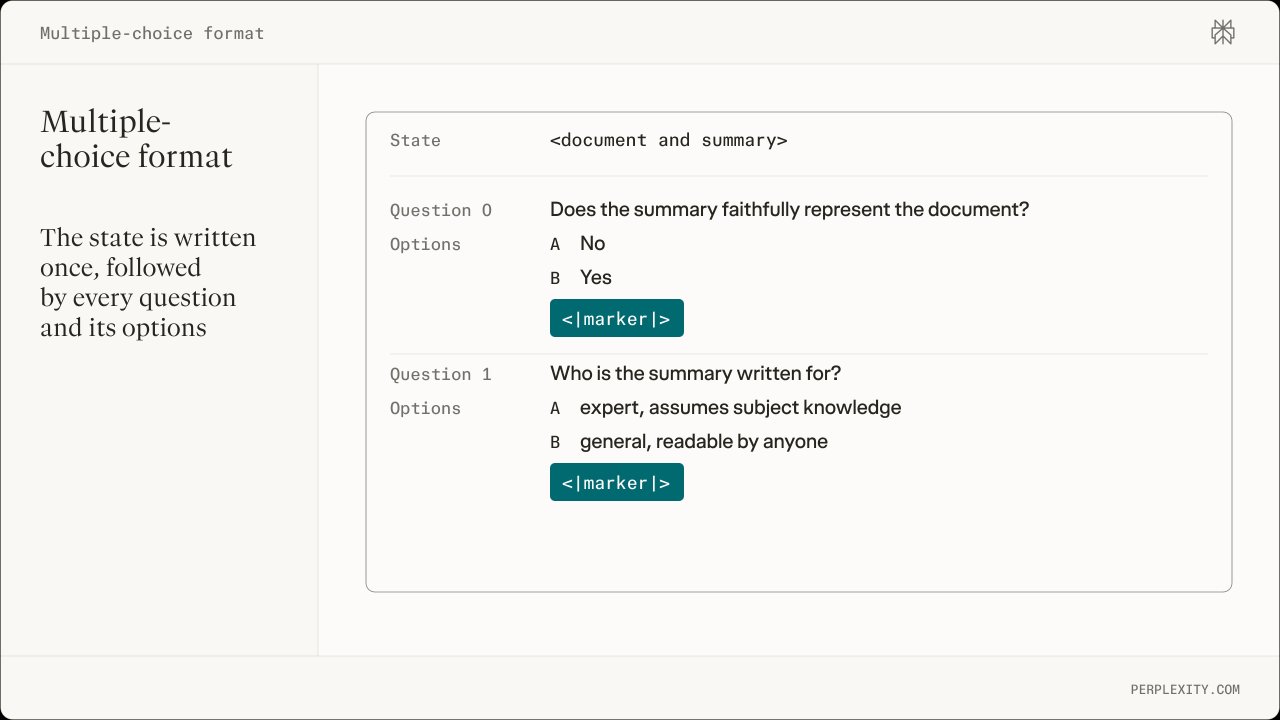
Decision model là classifier đa năng, anh em đưa vào một đoạn nội dung gọi là state, gồm văn bản, JSON hoặc ảnh, kèm câu hỏi có sẵn đáp án, rồi model trả về phân phối xác suất trên các đáp án đó, không sinh chữ nào.
Ba dạng gốc theo blog Perplexity là yes/no, multiple choice và score theo thang có thứ tự, thẻ model thêm dạng locate, một request hỏi được nhiều câu về cùng một state. Đợt này có hai model, bản lớn pplx-decider-v1.3 backbone Qwen3.8-27B, 26B tham số, weights khoảng 49 GiB, còn bản pplx-decider-flash-v1.3 backbone Qwen3.5-4B, khoảng 5B tham số, weights khoảng 8,5 GiB, distill từ bản lớn.
Locate là tính năng mới của Decider v1.3, trích đoạn văn bản kèm vị trí ký tự
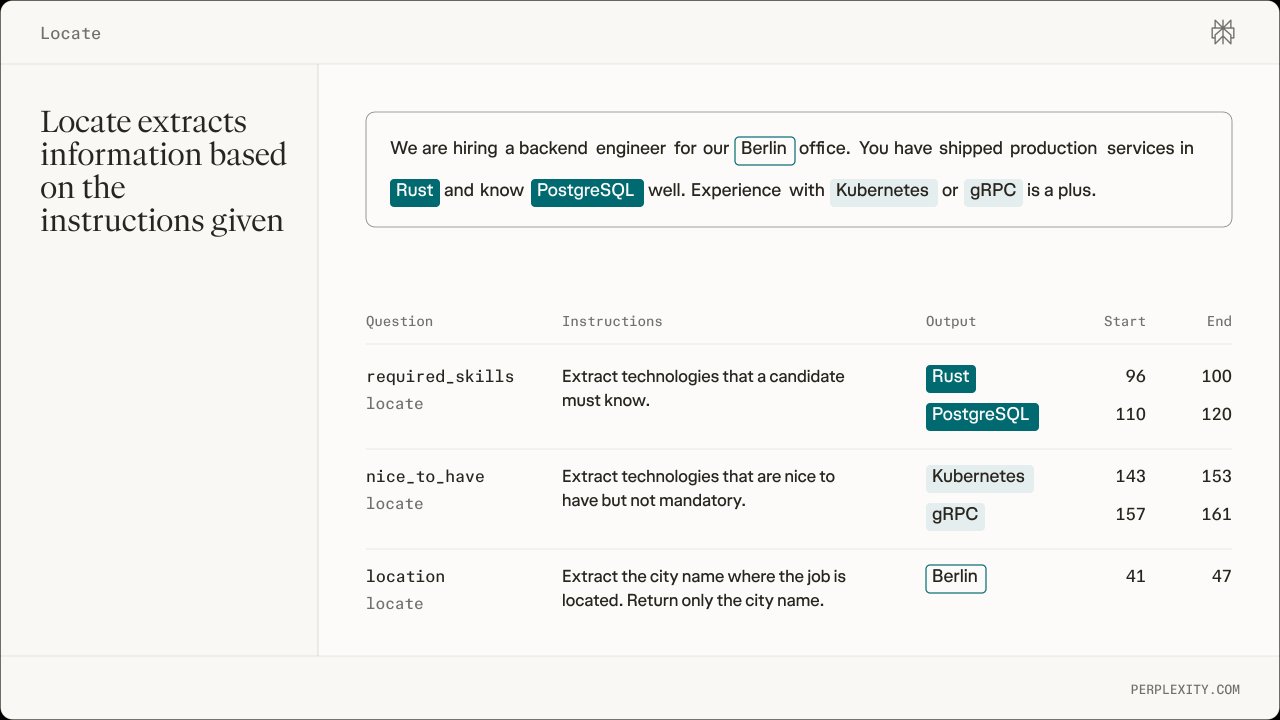
Locate là tính năng mới của v1.3, thay vì chọn trong các đáp án có sẵn, model trích đúng đoạn văn bản trong state khớp với yêu cầu, kèm vị trí ký tự bắt đầu và kết thúc cùng điểm confidence, không tìm thấy thì trả danh sách rỗng. Anh em dùng Locate cho nhận diện thực thể tên riêng, phát hiện thông tin cá nhân và hỏi đáp trích xuất, và một request trộn được câu hỏi locate với câu hỏi phân loại.
Cơ mà nghía qua giới hạn thì mình thấy Locate hơi kén: nó chỉ làm việc trên state văn bản, không nhận ảnh, tối đa 128 câu hỏi locate mỗi request, adapter giữ tách riêng, trộn thì chậm hơn, và bật fast=True thì Locate bị tắt luôn.
Điểm Locate hãng tự đo trên 17 task ngoài domain là v1.3 đạt 69,0, Flash 63,6, so với Liquid d1 43,3, Clairic của Cloudflare 41,5 và GLiNER large v2.5 33,6. Nhắc lại: đây vẫn là số hãng tự đo.
Hãng tự dùng Decider v1.3 để rà log agent và lọc chất lượng trang web như thế nào
Hãng liệt kê mấy việc dùng nó gồm chấm điểm đầu ra, routing theo độ khó, kiểm duyệt và bảo mật, lọc và gắn thẻ kho nội dung lớn. Hãng tự dùng nó rà log agent, một ngày đọc 1 tỷ token trên 7.000 session agent, tìm ra lỗi dẫn tới 14 bản sửa rule, 6 bản được duyệt và ship trong hai ngày, rule bận nhất giảm 52% lượng cảnh báo. Các con số này hãng tự đo, chưa có kiểm chứng độc lập.
Decider v1.3 khác LLM sinh chữ và classifier chuyên biệt cổ điển ở chỗ nào
Hiểu Decider là gì rồi thì câu hỏi tiếp theo là nó thay được cái gì.
LLM sinh chữ phải viết từng token rồi parse chữ, Decider v1.3 trả số để gắn ngưỡng
LLM sinh chữ phải viết từng token rồi mới parse ra đáp án, vừa tốn tiền token đầu ra vừa dễ sai định dạng, khó gắn ngưỡng vì không trả phân phối xác suất đã hiệu chuẩn, trong khi decision model bỏ bước sinh token, trả xác suất để code gắn ngưỡng xử lý tiếp, mà vẫn nhận task mới qua câu hỏi viết bằng ngôn ngữ tự nhiên.
Tiền thật thì test của Mohammad Adyatma đo được, mỗi 1.000 quyết định chỉ tốn 0,009 tới 0,123 USD tùy model, Decider v1.3 rẻ nhất với khoảng 0,009 USD, ước tính bằng giá v1.2 vì lúc test còn miễn phí.
Classifier chuyên biệt cổ điển rẻ nhưng mỗi task phải train riêng, Decider v1.3 nhận task mới qua câu hỏi
Classifier cổ điển rẻ nhất, nhanh nhất, chạy được trên CPU, nhưng mỗi task mới phải thu thập dữ liệu và train lại, không xử lý được task chưa từng gặp, còn decision model nhận task mới qua câu hỏi viết bằng ngôn ngữ tự nhiên, không cần train lại, một model phủ được nhiều task.
Task hẹp, ổn định, đã có dữ liệu nhãn sẵn thì classifier cổ điển vẫn hơn, còn Decider v1.3 không thay được LLM ở việc mở như viết hay tóm tắt, nó chỉ thay được LLM judge ở việc đóng là phân loại, routing, chấm rubric, kiểm duyệt và rerank. Làn sóng này đang đông dần, Gemini Decision 1 ra mắt 11/11, Salesforce Koa Decisions ra mắt 06/11, anh em đọc thêm bài về Salesforce Koa Decisions trên site và bài về Kanana 2 v-Decide trên site để đối chiếu.
Giá thật của Decider v1.3 và cách dùng miễn phí trên OpenRouter tới 19/11
Tuần miễn phí chỉ còn vài ngày, mà hiểu nhầm về hạn hay cách gọi API thì mất công tích hợp xong lại vướng.
Bảng giá Decisions API của Perplexity cho Decider v1.3 và Decider Flash v1.3
Giá chính thức trên trang pricing của docs Perplexity, cập nhật 13/11/2026, là pplx-decider-v1.3 0,02 USD cho mỗi triệu token đầu vào, pplx-decider-flash-v1.3 0,01 USD, token đầu ra miễn phí, không thu phí theo request, giá giữ nguyên so với v1.2. State, câu hỏi và ảnh đều tính vào token đầu vào, endpoint là POST https://api.perplexity.ai/v1/decisions, kèm alias pplx-decider-latest và pplx-decider-flash-latest hiện trỏ sang v1.3.
Đặt cạnh đối thủ mới thấy mức rẻ, Gemini Decision 1 giá 0,10 USD cho mỗi triệu token đầu vào, gấp 5 lần Decider v1.3, Jev 1.14 giá 0,042 USD, anh em xem thêm trong bài về Gemini Decisions API trên site để khỏi nhầm là Decider rẻ hơn thì hơn mọi mặt. Thú thật là mình thấy mức giá này hợp để thử nghiệm số lượng lớn, chứ rẻ mà dùng sai việc thì vẫn tốn công như thường.
Làm theo ngay: request mẫu tối giản, anh em thay API key của mình vào là chạy.
curl https://api.perplexity.ai/v1/decisions \
  -H "Authorization: Bearer $PERPLEXITY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "pplx-decider-v1.3", "state": "Ticket ho tro: khach bao bao don hang giao cham 3 ngay.", "questions": [{"question": "Ticket nay co khan khong?", "options": ["yes", "no"]}]}'
Cách dùng miễn phí trên OpenRouter và mốc 19/11 chỉ suy từ post X của Perplexity
Trên OpenRouter, cả hai model đều có bản :free, perplexity/pplx-decider-v1.3:free và perplexity/pplx-decider-flash-v1.3:free, giá niêm yết 0 USD cho cả token đầu vào và đầu ra, context 262.144 token, phát hành 12/11/2026, độ trễ khoảng 0,59 giây theo snapshot ngày 14/11/2026.
Anh em chọn đúng model có hậu tố :free, gọi qua Decisions API riêng, vì model này không dùng được SDK chat completions thông thường, và hiện chưa hỗ trợ EU in-region routing. Cảnh báo nhỏ: mốc 19/11/2026 chỉ suy ra từ bài đăng của @perplexitydevs trên X ngày 12/11/2026, nói hai model miễn phí trên OpenRouter trong một tuần, còn trang OpenRouter chỉ ghi giá 0 mà không ghi ngày kết thúc, anh em tự kiểm tra lại trước khi tin mốc 19/11.
Làm theo ngay: muốn thử miễn phí thì mở trang model perplexity/pplx-decider-v1.3:free trên OpenRouter, lấy API key của mình rồi gọi qua Decisions API route của OpenRouter, chọn đúng model có hậu tố :free, vì route này khác hẳn SDK chat completions thông thường, gọi nhầm là không chạy.
Bản Flash thì dùng perplexity/pplx-decider-flash-v1.3:free theo đúng cách gọi đó, và nhớ là bản miễn phí vẫn chịu giới hạn tốc độ theo chính sách chung của OpenRouter, nên chạy số lượng lớn thì kiểm tra trên trang OpenRouter trước, đồng thời kiểm tra trên trang model xem cửa sổ miễn phí còn mở không trước khi tin mốc 19/11.
Con số 91,6% của hãng nghĩa là gì và điểm Decision Index 67,7 trái chiều ra sao
Con số 91,6% chỉ đúng trong phạm vi hãng đo, nên mục này bóc đúng phạm vi từng con số.
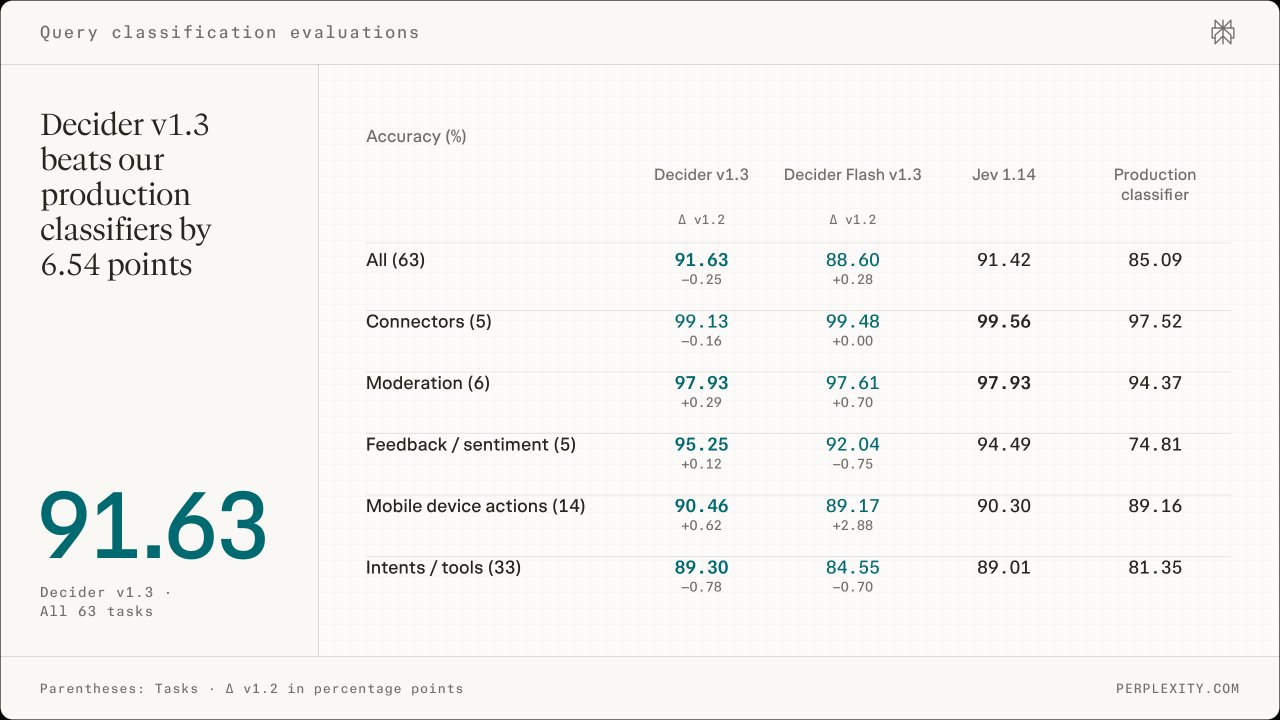
Benchmark 91,6% của Perplexity đo trên 63 task phân loại query nội bộ, đáp án do frontier LLM gán nhãn
91,6% là accuracy trung bình trên 63 task phân loại query nội bộ của Perplexity, hơn classifier production của hãng 6,54 điểm phần trăm, mà đáp án tham chiếu được gán nhãn lại độc lập bởi một frontier LLM, tức là số hãng tự đo trên sân nhà. Nhắc lại: con số này hãng tự đo, chưa qua tay bên thứ ba.
Phân loại ảnh trên 5 task thì v1.3 đạt 76,99%, hơn Jev 1,14 1,47 điểm, Flash 72,77%, cũng theo bảng hãng tự công bố. Về độ ổn định, trên 372 câu hỏi trắc nghiệm, v1.3 chỉ đổi đáp án 0,27% số câu mỗi phép biến đổi, so với 2,69% tới 4,84% của Jev 1.14, mà đây vẫn là số hãng tự đo.
Decision Index độc lập cho Decider v1.3 67,7 điểm, thấp hơn v1.2 là 68,0 điểm
Bản mirror benchlm.ai snapshot ngày 12/11/2026 ghi Decider v1.3 đạt 67,7 điểm, còn v1.2 đạt 68,0 điểm, tức v1.3 thấp hơn v1.2 một chút trên bảng này, trái với cảm giác bản mới toàn thắng trong blog hãng, nhưng hai bảng đo hai thứ khác nhau, một bảng là sân nhà của hãng, một bảng là sân chung, nên hai con số cùng đúng được.
Test độc lập 782 quyết định của Mohammad Adyatma: Decider v1.3 thắng 4 hạng mục, thua nặng ở phân loại ảnh giao diện
Số của hãng thì hãng nào chả đẹp, nên mục này là phần quan trọng nhất của bài.
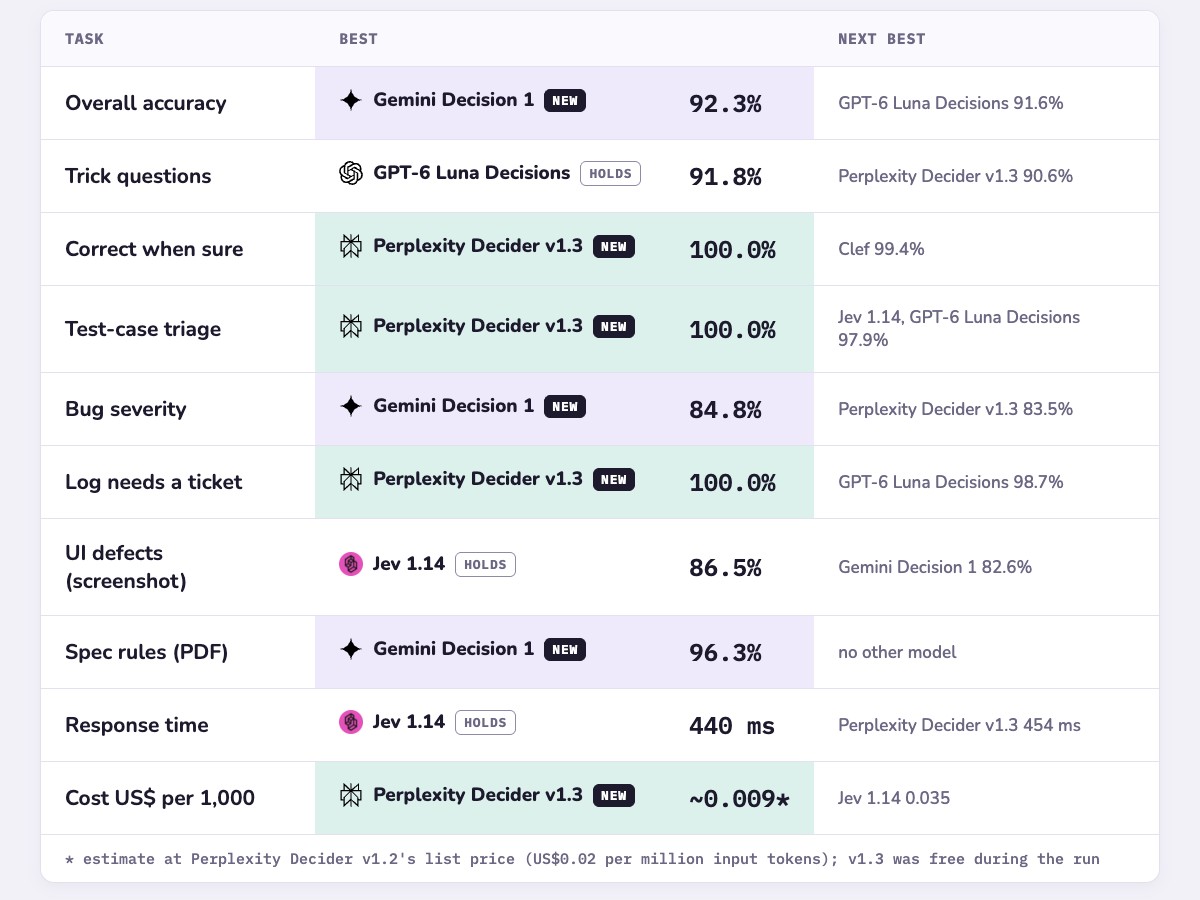
Thiết kế test 782 quyết định và kết quả tổng 5 model trên 702 item chung
Bài viết “Gemini Decision 1 vs Perplexity Decider v1.3: A Tester’s Bench”, tác giả Mohammad Adyatma, đăng trên Medium ngày 13/11/2026, thiết kế gồm 782 item, 6 dạng quyết định tester hay gặp, mỗi item có đáp án đúng biết trước vì tác giả tự xây theo rule, khoảng một phần ba là câu bẫy, và 80 item dạng PDF một trang về spec có nêu rule không.
Model tham gia gồm Gemini Decision 1, Perplexity Decider v1.3, GPT-6 Luna Decisions, Jev 1.14 và Cloudflare Clef, chỉ Gemini đọc được 80 PDF nên điểm tổng so trên 702 item mà cả 5 model đều xử lý được.
Kết quả tổng là Gemini 92,3%, Luna 91,6%, Perplexity 91,0%, Jev 90,3%, Clef 88,5%, chênh lệch giữa nhất và nhì chỉ 5 item.
Mình tin test này hơn bảng của hãng là vì tác giả tự xây đáp án đúng trước rồi mới chạy model, chứ không lấy số hãng công bố rồi đối chiếu lại, nên điểm số ở đây nói về việc thật chứ không phải sân nhà của ai. Decider v1.3 thắng 4 hạng mục là triage, log, confidence và cost, Gemini thắng 3 hạng mục là accuracy tổng, bug severity và PDF, Jev thắng mục UI defect, Luna thắng mục câu bẫy.
Decider v1.3 thắng 4 hạng mục triage, log, confidence và cost trong test 782 quyết định
Điểm mạnh nhất của Decider là 156 trên 156 item “log có cần ticket không” đều đúng, tốt nhất trong 5 model, và về confidence thì mọi đáp án mà Decider tự tin từ 0,8 trở lên đều đúng, 594 đáp án, phủ 84,6% số item, kể cả ở mục UI defect nơi nó yếu nhất thì mọi đáp án sai đều nằm trong nhóm không tự tin.
Chi phí thì Decider rẻ nhất với khoảng 0,009 USD cho mỗi 1.000 quyết định, ước tính bằng giá v1.2 vì lúc test còn miễn phí, còn Clef đắt nhất với 0,123 USD.
Decider v1.3 chỉ đạt 67,7% ở phân loại lỗi giao diện trên screenshot trong test 782 quyết định
Điểm yếu nhất của Decider là UI defect trên screenshot chỉ 67,7%, kém Jev 86,5% và Gemini 82,6% tới gần 19 điểm, mà tác giả lưu ý blog của Perplexity nói Decider hơn Jev 1,5 điểm ở phân loại ảnh, nhưng ảnh hãng dùng là hóa đơn và thú cưng, còn ảnh của test này là lỗi giao diện, tức benchmark của hãng chỉ nói về dữ liệu của hãng.
PDF thì Gemini đúng 77 trên 80, đạt 96,3%, 4 model còn lại không nhận được input PDF nên không có điểm. Giới hạn tác giả tự nêu, dataset xây theo rule, không có case audio hay video, mỗi item chỉ chạy một lần.
Hai test độc lập khác đều chạy trên v1.2, Plainlamp thì Decider v1.2 đúng 190 trên 190 lượt đọc, Flash v1.2 đúng 180 trên 190, còn AzoozGeek thì Flash v1.2 đạt 100% với 84 trên 84, bản lớn chỉ 86% với 62 trên 72 vì 12 request lỗi, mục logic bản lớn chỉ 29% còn Flash 100%.
Cộng đồng Hacker News khen chê Decider v1.3 ra sao: senjin, waximabbax, redanddead, stri8ted, nchmy
Thread Hacker News về blog Perplexity, 131 điểm theo snapshot Algolia khoảng 17:30 giờ Việt Nam ngày 14/11/2026, là nơi người dùng thật nói thẳng họ dùng Decider vào việc gì và thất vọng ở đâu, còn ý kiến Reddit thì không có trong bài này vì thread r/LocalLLaMA chưa đọc được. Mình đọc thread này thì thấy khen chê đều có tên người nói và số liệu đi kèm, chứ không phải cảm nhận chung chung.
senjin khen Decider là model yêu thích nhưng chê v1.3 là bước lùi, stri8ted khen chạy tốt trên benchmark local
senjin nói Decider là model quyết định mới mà người này thích nhất, nhưng v1.3 lại là bước lùi trong benchmark của chính họ cho việc của họ, và Decision Index cũng đồng tình, khiến họ nghĩ nên xem model xếp hạng cao hơn. stri8ted thì nói model chạy tốt trên benchmark local của người này, giá cạnh tranh, thời điểm ra mắt tốt vì Inception Labs đang ngừng Mercury API mà người này dùng trước đây.
Mình thấy senjin nói đúng chỗ này, vì Decision Index cũng ghi v1.3 thấp hơn v1.2 một chút, nên khen hay chê thì vẫn phải nhìn bảng độc lập chứ không đọc mỗi blog hãng.
waximabbax chê bản Flash và redanddead chê Decider thiếu sáng tạo, nchmy chỉ ra Locate có đối thủ tương đương
waximabbax không hào hứng với bản flash, vì decision model sinh ra để trả kết quả nhanh cho lượng request lớn với chi phí rẻ hơn reasoning model, trong khi reasoning model vốn chính xác hơn dù chậm và đắt hơn, nên flagship phải vừa nhanh nhất vừa chính xác nhất. Trừ khi nhận thêm dạng input khác ngoài ảnh và text thì người này không thấy lý do cần cả hai bản. Về số liệu thì người này ghi nhận trên AA Decision Index v1.3 và v1.2 có benchmark như nhau, còn v1.3 flash hơn v1.2 flash 4 điểm.
Mình chú ý là waximabbax không chê Decider yếu, người này chỉ hỏi vì sao phải tách hai bản khi flagship lẽ ra phải vừa nhanh vừa chính xác nhất, và mình thấy câu hỏi đó vẫn chưa có câu trả lời gọn từ phía hãng.
redanddead cho rằng đây chỉ là bản sao kém sáng tạo của một công nghệ dễ tái tạo, và Google với Decisions API cũng vậy. nchmy cho rằng cơ chế locate của Decider 1.3 có đối thủ tương đương là Clairic của Cloudflare và Extract của ScaleDown. Chưa có bình luận nào có tên người nói hỏi sao không dùng luôn LLM, nhưng blog Perplexity đã tự trả lời trước.
Giới hạn và bẫy của Decider v1.3 cần biết trước khi tích hợp
Trước khi tích hợp thì còn một loạt bẫy nằm ở ngưỡng xác suất, GPU, repo và chế độ fast.
Ngưỡng xác suất của Decider v1.3 phải tự tune trên dữ liệu của mình, không dùng ngưỡng cố định
Blog khuyên tune ngưỡng trên một tập dev nhỏ có nhãn thay vì dùng ngưỡng cố định, và tự hiệu chuẩn lại theo traffic của mình, nhiệt độ hiệu chuẩn lưu trong decision_config.json đã fit trên dữ liệu held-out. Mỗi câu hỏi tối đa 255 lựa chọn, dạng score cần 2 tới 255 mức. Test AzoozGeek trên v1.2 đã cho thấy bản lớn chưa chắc hơn bản nhỏ, nên bài học là test cả hai bản trên dữ liệu của mình rồi hãy chọn.
Chạy local Decider v1.3 cần GPU chứa khoảng 49 GiB weights và repo Hugging Face vẫn ghi private
Yêu cầu theo thẻ model là Python 3.12 trở lên, GPU CUDA chứa được khoảng 49 GiB weights BF16, cài requirements.txt rồi tải repo bằng snapshot_download("perplexity-ai/pplx-decider-v1.3"), dùng package pplx_decider đi kèm, gọi Decider.from_pretrained(checkpoint, device="cuda") và decider.decide(), và chưa ai trong phạm vi nghiên cứu chạy thử local trên GPU thật, mọi con số phần cứng đều từ thẻ model.
Mình chưa chạy thử local trên GPU thật nên mọi con số phần cứng ở mục này mình lấy nguyên từ thẻ model, anh em đừng đọc thành trải nghiệm thực tế của mình.
Mâu thuẫn cần biết trước khi tải, thẻ model vẫn ghi dòng “The repository is private: authenticate with a Hugging Face token that has access to it”, tức có thể vẫn cần token dù blog gọi là open weights. Mà API của Hugging Face đã liệt kê cả hai model là public, với license apache-2.0, nên anh em tự kiểm tra trước khi kết luận. Đọc license trước, đừng đọc sau.
Mặc định local max_length là 32.768 token, input vượt giới hạn thì báo lỗi LengthError chứ không cắt ngắn, và bật fast=True thì tắt Locate.
Flash thua Jev ở finance, programming và law, và Decider v1.3 không đọc được PDF hay audio
Theo blog hãng, Flash thua Jev ở finance, programming và law, trong khi v1.3 dẫn đầu cả 7 domain, hơn tới 12,9 điểm ở finance và 9,3 điểm ở law, nên Flash chỉ hợp routing và lọc số lượng lớn, không hợp phán đoán khó ở 3 domain này. Nhắc lại: đây là số hãng tự đo, chưa qua kiểm chứng độc lập.
Decider chỉ nhận text và ảnh, không nhận audio, video hay PDF trực tiếp, trong khi Gemini Decision 1 nhận đủ 5 loại input, tối đa 262.144 token, nhận tới 1.000 câu hỏi trong một request, và test của Mohammad Adyatma cho thấy Gemini là model duy nhất đọc được PDF với 96,3%, tức 77 trên 80.
Nên thử hay chờ: chọn bản Decider nào cho từng việc
Khuyến nghị của hãng là dùng v1.3 cho phán đoán tinh tế và việc mà lỗi đắt, dùng Flash cho routing, gắn nhãn và lọc số lượng lớn, mà đối chiếu với test độc lập thì Decider v1.3 hợp log, triage, chấm rubric và việc cần rẻ, Gemini Decision 1 hợp khi cần đọc PDF và chấm severity, Jev 1.14 hợp khi cần phân loại ảnh giao diện, còn không dùng Decider cho việc cần viết chữ hay tóm tắt.
Verdict của mình là nên thử ngay trong tuần miễn phí trên OpenRouter, vì thử không tốn tiền và test trên dữ liệu của mình là cách duy nhất biết model có hợp việc của mình không.
Mọi người cứ thử trong tuần miễn phí rồi hãy quyết, nhưng đừng tích hợp production vội trước khi tune ngưỡng và test cả hai bản trên dữ liệu thật, vì test độc lập đã cho thấy bản lớn chưa chắc lúc nào cũng hơn bản nhỏ, và nhắc lại mốc 19/11 là suy ra từ post X, anh em kiểm tra lại trên trang OpenRouter trước khi lên kế hoạch. Anh em nào đã chạy Decider v1.3 vào log, triage hay QA giao diện thì chia sẻ trải nghiệm đo thật ở dưới bình luận nhé.
Nguồn tham khảo
- Blog Perplexity về Decider v1.3: https://www.perplexity.ai/hub/blog/perplexity-decider
- Thẻ model Hugging Face perplexity-ai/pplx-decider-v1.3: https://huggingface.co/perplexity-ai/pplx-decider-v1.3
- Trang OpenRouter perplexity/pplx-decider-v1.3:free: https://openrouter.ai/perplexity/pplx-decider-v1.3:free
- Trang pricing docs Perplexity: https://docs.perplexity.ai/docs/getting-started/pricing
- Bài test 782 quyết định của Mohammad Adyatma trên Medium: https://medium.com/@madyatma/gemini-decision-1-vs-perplexity-decider-v1-3-tester-bench-df79c1f9c4e3
- Thread Hacker News về blog Perplexity: https://news.ycombinator.com/item?id=50488464
- Bài test 420 request của AzoozGeek: https://www.azoozgeek.com/en/posts/we-tested-5-decision-models-on-420-real-requests
- Bài test 27 decision model của Plainlamp: https://www.plainlamp.com/blog/decision-models
- Blog Google về Gemini Decisions API: https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
- Bài Salesforce Ben về Koa Decisions: https://www.salesforceben.com/salesforce-unveils-cheaper-quicker-ai-decisions-model-koa-decisions/
- Bản lưu post X của @perplexitydevs: https://www.techtwitter.com/tweet/1ec952e1-367f-4271-8d36-b9f26e7cccbf
- Bài respan.ai về decision model: https://www.respan.ai/articles/best-ai-decision-models
- Bản mirror Decision Index trên benchlm.ai: https://benchlm.ai/benchmarks/decisionindex
- Bài viết về OpenRouter free tier trên klymentiev.com: https://klymentiev.com/blog/openrouter-free-tier

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- WSJ Nvidia Huang circular financing: Huang dung tien Nvidia tai tro startup mua chip cua chinh Nvidia khi thua silicon TSMC
- ChatGPT Wallet ra mắt cho Pro Mỹ, còn vé United thì agent vẫn không mua được
- Claude vào họp Google Meet: làm docs ngay trong cuộc họp, chỉ gói Team và Enterprise được dùng beta
Bình luận & Trao đổi