📑 Mục lục chi tiết bài viết (29 mục)
- Nhóm Michigan cắm đồng hồ đo điện thật vào 5 model Qwen 3, Gemma 3 và Llama 3.1 trên 122 ngôn ngữ Belebele
- Tiếng Pashto tốn 3.147 kJ so với 17,6 kJ của tiếng Anh trên cùng 900 câu Belebele
- Hindi tốn 7,9 lần và Bengali tốn 15,3 lần năng lượng so với tiếng Anh
- Khoảng 5,2 tỷ người phải tốn hơn gấp đôi năng lượng khi dùng tiếng mẹ đẻ
- Tokenizer chẻ chữ Devanagari và Bengali thành mảnh vụn trong khi tiếng Trung vẫn rẻ ngang tiếng Anh
- Bộ tách từ BPE của Llama 3.1 khiến Bengali tốn 6,32 lần token so với tiếng Anh
- Token nhiều hơn kéo theo bộ nhớ chật, batch nhỏ hơn và năng lượng trên mỗi token tăng
- Model trả lời bằng tiếng Shan và Tigrinya lặp lại cùng một câu tới 45 lần
- Người hỏi bằng ngôn ngữ mẹ đẻ trả tiền API cao hơn, mất cửa sổ ngữ cảnh và nhận câu trả lời kém chính xác hơn
- Giá API tính theo token nên hệ số token của Bengali trên Llama 3.1 thành hệ số giá 6,3 lần
- Cửa sổ 128 nghìn token của Llama 3.1 chỉ chứa khoảng 20 nghìn token Bengali
- Tiếng Shan chỉ đúng 10,6% và tiếng Tigrinya chỉ đúng 25,3% trong khi tiếng Anh đúng 94,6%
- Tiếng Việt tốn 39.513 J so với 17.588 J của tiếng Anh trên Qwen3-8B và phụ phí token đã hạ trên model mới
- Tiếng Việt đạt 88,6% chính xác trên Qwen3-8B với 0,11 J cho mỗi token
- Phép đo Aeonic tháng 10/2026 cho thấy tiếng Việt chỉ còn phụ phí token 1,24 lần trên Qwen và Gemini
- Model thử nghiệm đã cũ khoảng 18 tháng và phép đo lại trên DeepSeek V4.1 Flash cho tiếng Trung rẻ hơn tiếng Anh
- Chu kỳ xuất bản khiến model Qwen 3, Gemma 3 và Llama 3.1 đã cũ khoảng 18 tháng khi tin lên sóng
- Phép đo lại trên DeepSeek V4.1 Flash cho tiếng Trung 0,72 lần và tiếng Nga 0,80 lần năng lượng so với tiếng Anh
- Paper Michigan bỏ qua speculative decoding và thước đo người bản xứ làm tiếng Anh trông rẻ hơn thực tế
- Dịch prompt sang tiếng Anh dùng được ngay, model chuyên biệt như Sarvam đã chứng minh và H-Net vẫn là nghiên cứu
- Dịch sang tiếng Anh rồi dịch kết quả về giảm cả năng lượng lẫn sai sót, trừ nhiệm vụ nặng văn hóa
- Model chuyên biệt như Sarvam giữ phụ phí token dưới 2,6 lần ở mọi ngôn ngữ Ấn Độ
- H-Net học cách chunk byte ngay trong model nhưng số liệu Cartesia chưa có bên ngoài tái lập
- Người Việt dùng AI hằng ngày nên viết prompt tiếng Anh khi làm việc dài và giữ tiếng Việt cho hội thoại ngắn
- Viết prompt tiếng Anh khi làm việc dài, dịch kết quả về tiếng Việt sau cùng
- Chọn model có tokenizer tốt cho tiếng Việt, Gemma 3 làm ví dụ về vốn từ rộng
- Cứ viết tiếng Việt khi hội thoại ngắn và khi sắc thái văn hóa quan trọng hơn vài phần trăm chi phí
- Nghiên cứu Michigan đo bằng điện thật một bất bình đẳng anh em đã thấy qua hóa đơn token, và tiếng Việt nằm trong nhóm khá
- Nguồn tham khảo
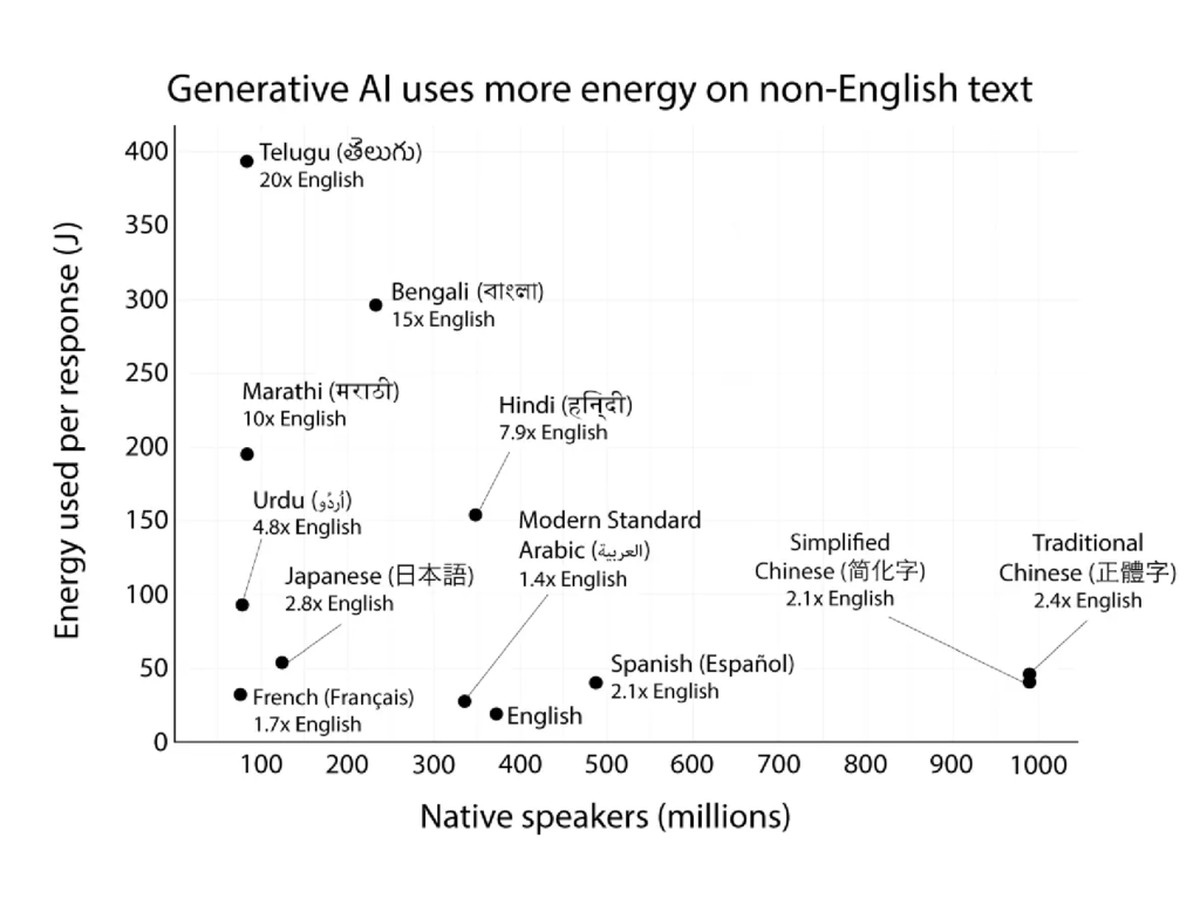
Cùng một bộ 900 câu hỏi, tiếng Pashto tốn gấp 179 lần năng lượng so với tiếng Anh theo paper, 180 lần theo bài báo do làm tròn, và đó là trường hợp tệ nhất. Nghiên cứu đăng ngày 05/11/2026, thread Hacker News lên ngày 10/11/2026, bài này viết ngày 15/11/2026 nên độ nóng đã hạ, model được đo là thế hệ 2024-2025 gồm Qwen 3, Gemma 3 và Llama 3.1.
Đọc lướt thì giữ lại mấy con số này, nghiên cứu Michigan đo điện thật trên GPU, cùng một bộ 900 câu thì tiếng Anh tốn 17,6 kJ còn tiếng Pashto tốn 3.147 kJ, tức 179 lần theo paper và 180 lần theo bài báo do làm tròn, Hindi 7,9 lần, Bengali 15,3 lần, tiếng Việt khoảng 2,25 lần trên Qwen3-8B, hầu hết ngôn ngữ Tây Âu gấp đôi trở xuống, và ngôn ngữ nào tốn nhiều điện nhất thì cũng trả lời kém chính xác nhất.
Nhóm Michigan cắm đồng hồ đo điện thật vào 5 model Qwen 3, Gemma 3 và Llama 3.1 trên 122 ngôn ngữ Belebele
Trước khi bàn con số 180 lần, anh em cần biết nhóm Michigan đo bằng cái gì, vì đọc xong cách đo thì mấy con số sau mới có trọng lượng.
Nhóm Michigan cắm đồng hồ đo thật vào GPU, dùng framework ML.Energy, đọc bộ đếm phần cứng GPU NVIDIA qua thư viện Zeus với sai số trong khoảng 5%, rồi cho 5 model thuộc 3 họ trả lời cùng 900 câu Belebele ở 122 ngôn ngữ. Nhóm chạy model qua server vLLM trên cụm Great Lakes, đo ở giai đoạn ổn định khi batch đã bão hòa, để ngôn ngữ chạy nhanh như tiếng Anh không bị phạt oan vì chi phí khởi động.
Giáo sư Rada Mihalcea, giám đốc U-M AI Lab, nói rõ quan điểm của nhóm: “AI developers should be creating more resources for those languages with an energy and cost disparity.”
Tiếng Pashto tốn 3.147 kJ so với 17,6 kJ của tiếng Anh trên cùng 900 câu Belebele
Trên Qwen3-8B, cùng một bộ 900 câu, tiếng Anh tốn 17,6 kJ còn tiếng Pashto tốn 3.147 kJ, tức 179 lần theo paper và 180 lần theo bài báo do làm tròn.
Con số này đắt vì hai lớp chồng lên nhau, Pashto vừa tốn 0,84 J cho mỗi token, vừa sinh tới 4.164 token cho mỗi câu trả lời so với 186 token của tiếng Anh, tức nhiều hơn 20 tới 25 lần số token đầu ra để nói cùng một ý, rồi trả lời chỉ đúng 40,4%. Mình đọc tới đây thì thấy đây mới là trường hợp tệ nhất đáng nhớ, vừa trả nhiều điện nhất vừa nhận câu trả lời kém nhất.
| Ngôn ngữ | J/token | Tổng 900 câu | Hệ số | Chính xác |
|---|---|---|---|---|
| Tiếng Anh | 0,10 | 17.588 J | 1,0 lần | 94,6% |
| Tiếng Trung giản thể | 0,10 | 36.983 J | 2,1 lần | 89,6% |
| Tigrinya | 0,73 | 2.413.328 J | 137 lần | 25,3% |
| Shan | 0,70 | 2.948.722 J | 168 lần | 10,6% |
| Tây Tạng | 0,85 | 3.002.867 J | 171 lần | 21,9% |
| Pashto miền Nam | 0,84 | 3.146.541 J | 179 lần | 40,4% |
Hindi tốn 7,9 lần và Bengali tốn 15,3 lần năng lượng so với tiếng Anh
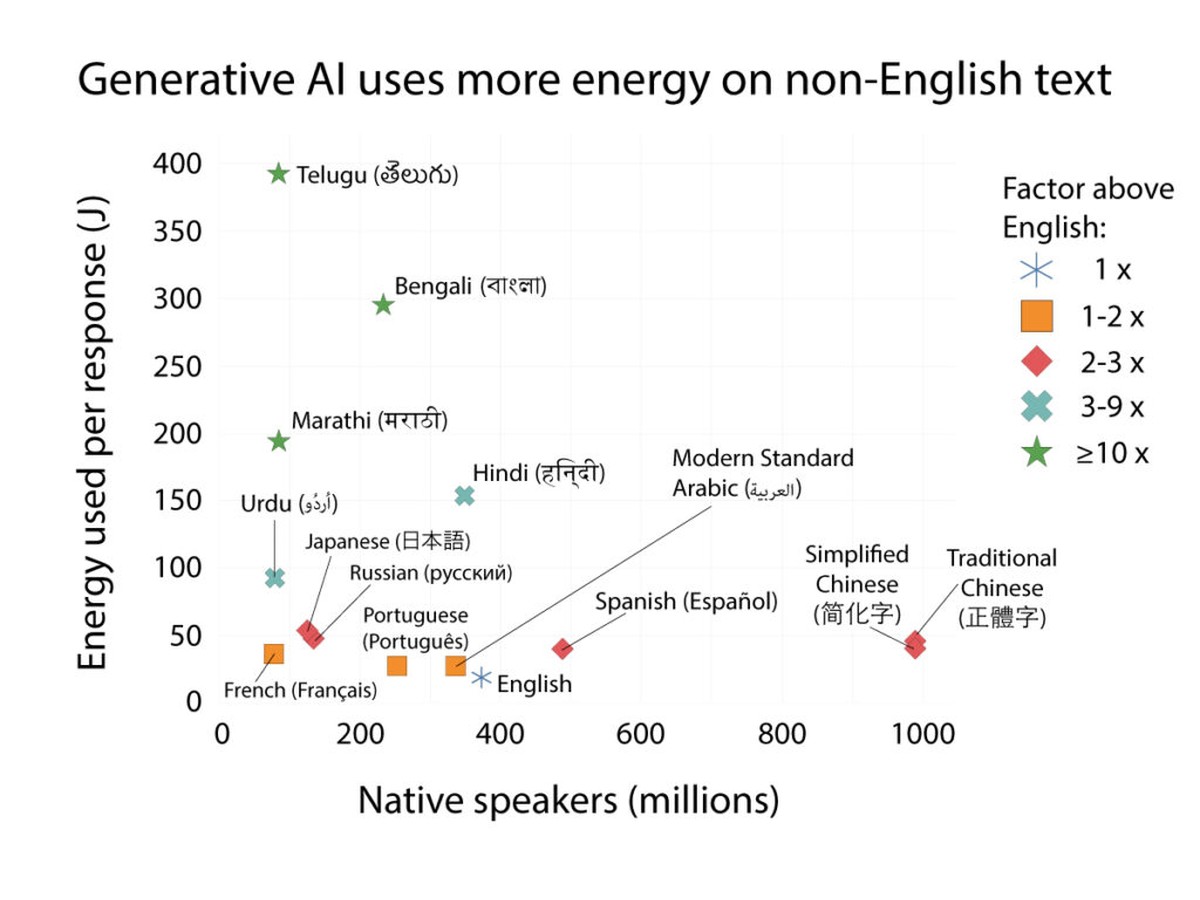
Hindi tốn 7,9 lần và Bengali tốn 15,3 lần năng lượng so với prompt tiếng Anh tương đương, theo bài báo Michigan News, còn Bảng 5 của paper cho số gần tương đương là 8,1 lần và 15,0 lần. Bản tin Michigan Engineering còn ghi trên tiêu đề phụ là tới 15 lần cho các ngôn ngữ phổ biến, khớp đúng hai con số này.
Điểm đáng tiền nhất ở hai ngôn ngữ này nằm ở cái bẫy chữ Latin, viết Hindi và Bengali bằng chữ Latin thì rẻ hơn rõ rệt nhưng chính xác tụt mạnh, Hindi Latin chỉ đúng 66,7% so với 75,9% bản Devanagari, còn Bengali Latin tụt xuống chỉ 29,9% so với 78,3% bản Bengali. Đổi chữ viết để tiết kiệm điện mà mất hơn nửa độ chính xác thì đúng là đổi chác lỗ vốn.
Mình đồng tình một nửa với mấy bình luận trên Hacker News bảo chuyện này ai cũng biết từ lâu, vì từ lúc các hãng nói văn bản ngoài tiếng Anh tốn thêm chừng một phần ba token thì ai cũng đoán ra điện cũng tốn hơn. Cơ mà đoán ra với đo được bằng đồng hồ điện thật là hai chuyện khác nhau, giá trị của paper nằm ở hai con số cụ thể này.
Khoảng 5,2 tỷ người phải tốn hơn gấp đôi năng lượng khi dùng tiếng mẹ đẻ
Khoảng 5,2 tỷ người hiện phải tốn hơn gấp đôi năng lượng để tạo văn bản bằng tiếng mẹ đẻ so với người nói tiếng Anh, theo số đo của nhóm nghiên cứu cộng dữ liệu nhân khẩu từ Ethnologue, trong khi hầu hết ngôn ngữ Tây Âu chỉ tốn gấp đôi trở xuống. Con số 5,2 tỷ này đứng vững vì khoảng cách không chỉ xuất hiện trên bài đọc hiểu Belebele, mà còn ở cả bài toán đố GSM8K lẫn đoạn chat mở LM-Arena, nơi khoảng cách là 10,6 lần, và trên cả hai loại GPU là NVIDIA L40S 48GB và RTX 6000 Pro Blackwell 96GB, với mọi batch size từ 16 tới 512.
janalsncm trên Hacker News bảo model tốn ít điện cho tiếng Anh thì có khi lại là tối ưu, vì phân bố ngôn ngữ phục vụ thực tế vốn nghiêng về tiếng Anh. Mình phản biện lại điểm này, tối ưu cho phân bố hiện tại chính là cách duy trì bất bình đẳng, vì phân bố hiện tại phản ánh ai đang dùng AI nhiều nhất, không phản ánh ai cần AI nhất, và người thiệt vẫn là 5,2 tỷ người kia.
Tokenizer chẻ chữ Devanagari và Bengali thành mảnh vụn trong khi tiếng Trung vẫn rẻ ngang tiếng Anh
Con số 180 lần nghe như bản án dành cho mọi ngôn ngữ không phải tiếng Anh, nhưng cơ chế đằng sau nó nằm ở bộ tách từ tokenizer, và cơ chế này sửa được.
Cơ chế nó rõ ràng hẳn, token là đơn vị dữ liệu cơ bản của AI, model chuyển prompt thành token để xử lý rồi chuyển token đầu ra thành chữ đọc được, còn chữ Devanagari và chữ Bengali có ký tự chính biến hình và kết hợp với dấu, tạo ra tới hàng triệu ký tự riêng biệt có thể có, nên tokenizer phải chẻ nhỏ ra từng mảnh vụn.
Hai lớp chênh lệch này nhân với nhau ra con số tổng, chi phí trên mỗi token chênh nhau tới 8,3 lần, số token sinh ra để nói cùng một ý nhiều hơn hẳn, có khi gấp 20-25 lần tiếng Anh, còn tiếng Trung giản thể vẫn đạt khoảng 0,10 J/token. Nghe thì giống bản án dành cho mọi ngôn ngữ, cơ mà với mình thì đây lại là tin tốt, vì cơ chế nào nhìn rõ được thì cơ chế đó sửa được.
Bộ tách từ BPE của Llama 3.1 khiến Bengali tốn 6,32 lần token so với tiếng Anh
Bài đếm tay của Frank Chu, đo bằng tokenizer thật của cả 3 model, cho thấy Bengali tốn 278 token so với 44 token tiếng Anh trên Llama 3.1, tức 6,3 lần, còn trên Gemma 3 chỉ 51 so với 44, tức 1,16 lần. Gemma 3 có vốn từ 262 nghìn token phủ thật sự chữ viết Ấn Độ, trong khi vốn từ 128 nghìn token của Llama 3.1 xây trên kho dữ liệu mà Bengali gần như không xuất hiện, nên cùng một ý mà chỉ khác tokenizer thì giá đã chênh nhau hơn 5 lần.
Tranh luận trên Hacker News về chuyện này khá hay, dosinga và brainwad bảo BPE thiên vị tiếng Anh chỉ là hệ quả tự nhiên vì tiếng Anh chiếm đa số trong dữ liệu huấn luyện, còn vova_hn2 phản biện rằng ít ai dùng toàn bộ dataset để huấn luyện tokenizer, thường chỉ dùng vài chục tới vài trăm GB rồi chọn tay tỷ lệ từng ngôn ngữ, nên hoàn toàn có thể chủ đích chia lại vốn từ, và cubefox bổ sung rằng tokenizer thường được tối ưu cho tiếng Anh, ví dụ có quy tắc riêng cho dạng rút gọn trong tiếng Anh.
Mình đứng về phía thứ hai, vì Gemma 3 và Sarvam đã chứng minh chia lại vốn từ là làm được ngay, và cơ chế này còn rộng hơn chữ Ấn Độ, tiếng Phần Lan, Thổ Nhĩ Kỳ hay Hàn Quốc dồn gốc từ, thì và cách vào một từ dài mà BPE khó tách đúng ranh giới, còn chữ abjad như Arabic lược bỏ nguyên âm ngắn nên model phải suy ra từ ngữ cảnh.
Token nhiều hơn kéo theo bộ nhớ chật, batch nhỏ hơn và năng lượng trên mỗi token tăng
Chỗ này mới là cái bẫy ít ai để ý, nhiều token hơn thì chiếm nhiều bộ nhớ hơn, model còn ít bộ nhớ để xử lý nên phải chạy theo lô nhỏ hơn, mà lô nhỏ thì tốn nhiều năng lượng hơn trên mỗi token.
Con số cụ thể nằm ở chỗ năng lượng tuyệt đối trên mỗi token tăng theo kích thước model, tiếng Anh từ 0,10 J/token ở Qwen3-8B lên 0,17 ở Qwen3-14B và 0,51 ở Qwen3-32B, nhưng khoảng cách giữa ngôn ngữ đắt nhất và rẻ nhất không hề thu hẹp, 8,3 lần ở Qwen3-8B, 12,2 lần ở Qwen3-14B, 9,0 lần ở Qwen3-32B, 8,2 lần ở Gemma 3 và 7,1 lần ở Llama 3.1. Nghiên cứu của Petrov năm 2023 cũng đã ghi một số ngôn ngữ cần gấp tới 15 lần số token so với tiếng Anh, nên đây là vấn đề biết trước từ lâu, chỉ là tới giờ mới có người đo ra điện thật.
Với mình thì tokenization mới là sàn của mức phạt, chưa phải trần, vì sau tokenizer còn cả vòng lặp sinh token dài dòng lẫn độ chính xác tụt theo, thành ra cùng một lỗi gốc mà hóa đơn cứ đội lên thêm mấy lớp.
Model trả lời bằng tiếng Shan và Tigrinya lặp lại cùng một câu tới 45 lần
Token explosion là chi tiết đắt nhất của paper, với Shan, Pashto, Tây Tạng, Tigrinya, Miến Điện và Amharic, model sinh tới khoảng 4.700 token đầu ra cho một câu hỏi, rơi vào vòng lặp mà không chốt được câu trả lời ngắn, ví dụ một câu Tigrinya lặp lại tới 45 lần. Độ dài đầu ra mới là điểm ngạc nhiên thật sự, nó biến câu chuyện từ tokenizer kém thành model vừa tốn tiền vừa trả lời tệ.
Còn ba hiện tượng nữa cũng đáng tiền không kém, Latvian sinh tới 896 token cho cùng một ý, gấp 3,4 lần tiếng Anh, vì model hiểu lơ mơ rồi trả lời dài dòng, tiếng Tây Tạng chỉ đạt 0,78 ký tự cho mỗi token so với 4,84 ký tự của tiếng Anh, tức mỗi token mang chưa tới một ký tự, và hỏi bằng tiếng Khmer mà model trả lời luôn bằng tiếng Anh.
Phemist trên Hacker News bảo tiếng Serbia thiệt vì dùng cả hai chữ viết, chữ Cyrillic với chữ Latin, mà bản Latin lại có thêm biến thể bỏ hết dấu, nên văn bản Serbia chia ba hướng, còn shevy-java bảo tiếng Đức tốn điện vì phức tạp hơn tiếng Anh, có der die das với từ ghép siêu dài, mình làm rõ lại chỗ này, phức tạp cỡ nào cũng chưa quyết định tiền điện, bằng chứng là tiếng Trung phức tạp về chữ viết mà vẫn rẻ ngang tiếng Anh, cái quyết định là tokenizer và dữ liệu huấn luyện.
Người hỏi bằng ngôn ngữ mẹ đẻ trả tiền API cao hơn, mất cửa sổ ngữ cảnh và nhận câu trả lời kém chính xác hơn
Năng lượng nghe có vẻ là chuyện của trung tâm dữ liệu, nhưng với anh em dùng API thì nó hiện thẳng ra hóa đơn, còn với anh em dùng chatbot thì nó hiện ra ở chỗ tài liệu dài bị cắt ngắn và câu trả lời kém hẳn đi.
Naihao Deng, tác giả đầu, cho biết ngôn ngữ nào tốn nhiều năng lượng hơn thì cũng có xu hướng cho độ chính xác thấp hơn, và paper nhấn mạnh hai thứ này chỉ đồng xuất hiện cùng nhau, chưa chứng minh được cái này gây ra cái kia. Deng còn cảnh báo, hình phạt kép này khiến một số người có nguy cơ bị đẩy khỏi AI vì giá, còn công ty thì ngại phục vụ những ngôn ngữ đó. Chi phí AI đổi ra tiền thật cho mỗi việc thì không chỉ là chuyện ngôn ngữ, như bài toán tốn 15,70 USD mỗi bài trên MathArena cho thấy một bài toán khó cũng có thể ngốn cả chục USD tiền suy luận.
Giá API tính theo token nên hệ số token của Bengali trên Llama 3.1 thành hệ số giá 6,3 lần
Giá API thường tính theo số token tạo ra nên hệ số token chính là hệ số giá, cùng đoạn văn bằng Bengali tốn gấp 6,3 lần giá tiếng Anh qua endpoint dùng Llama và 1,2 lần qua endpoint dùng Gemma. Ở mức thực dụng thì mình đứng về phía rhdunn và simonw trên Hacker News, vì người dùng API chỉ nhìn được số token và hóa đơn, nhưng anh em nhớ rõ số token chỉ là con số ước lượng qua trung gian, phép đo điện thật mới là điểm mới của paper Michigan.
Ví dụ ước tính từ nghiên cứu về thuế token Ấn Độ, dùng giá niêm yết chính thức ngày 05/11/2026, bot hỗ trợ xử lý 100.000 chat mỗi tháng trên GPT-4o tốn khoảng 56.640 rupee Ấn Độ bằng tiếng Anh và 102.829 rupee bằng tiếng Marathi, đây là ước tính chứ không phải chi phí sản xuất đo được.
Cửa sổ 128 nghìn token của Llama 3.1 chỉ chứa khoảng 20 nghìn token Bengali
Cửa sổ ngữ cảnh là giới hạn số token model đọc được trong một lần, hết cửa sổ là tài liệu bị cắt, và cùng một tài liệu dài thì cửa sổ 128 nghìn token của Llama 3.1 chứa được khoảng 128 nghìn token tiếng Anh nhưng chỉ khoảng 20 nghìn token Bengali, theo bài đếm tay của Frank Chu.
Over-generation càng làm cửa sổ chật thêm, vì model sinh dài dòng ở ngôn ngữ ít tài nguyên trong khi vẫn phải giữ toàn bộ ngữ cảnh trong bộ nhớ. Mình hay nghĩ cửa sổ ngữ cảnh giống như cái bàn làm việc, bàn đã chật mà model còn bày bừa thêm thì tài liệu dài cỡ nào cũng phải cắt bớt.
Tiếng Shan chỉ đúng 10,6% và tiếng Tigrinya chỉ đúng 25,3% trong khi tiếng Anh đúng 94,6%
Độ chính xác trên Belebele theo Bảng 1 của paper, Pháp đạt 91,7% và Nga đạt 90,9%, còn nhóm ít tài nguyên thì tụt hẳn, thấp nhất là Shan chỉ 10,6%, nên nhóm Michigan đề xuất model đa ngôn ngữ phải báo cáo năng lượng cho từng ngôn ngữ riêng, coi năng lượng là một trục đánh giá hạng nhất. Mình ủng hộ đề xuất này, vì một model đạt 95% ở tiếng Anh với 0,10 J/token mà chỉ 22% ở tiếng Tây Tạng với 0,85 J/token thì thực tế là hai hệ thống khác hẳn nhau.
Tiếng Việt tốn 39.513 J so với 17.588 J của tiếng Anh trên Qwen3-8B và phụ phí token đã hạ trên model mới
Tới đây mới là câu hỏi quan trọng nhất của bài này, tiếng Việt nhà mình nằm ở đâu trong bảng xếp hạng, tin tốt là tiếng Việt nằm trong nhóm khá, nhưng con số 2,25 lần đó đo trên model cũ, còn model mới hơn thì bức tranh đã khác đi nhiều, và anh em nào muốn đọc sâu về model tiếng Việt thì có thể xem đánh giá năng lực xử lý ngữ cảnh bản địa của các model ngôn ngữ lớn tiếng Việt.
Tiếng Việt đạt 88,6% chính xác trên Qwen3-8B với 0,11 J cho mỗi token
Số riêng cho tiếng Việt trong Bảng 5 của paper trên Qwen3-8B là 0,11 J/token, 359.211 token, tổng 39.513,2 J, độ chính xác 88,6%, so với tiếng Anh 17.588 J thì tiếng Việt tốn khoảng 2,25 lần tổng năng lượng. So với nhóm đắt nhất thì tiếng Việt rẻ hơn hẳn, nhưng vẫn đắt hơn gấp đôi tiếng Anh và kém chính xác hơn, 88,6% so với 94,6%. Mình đọc con số này mà nhẹ cả người, vì tiếng Việt nằm trong nhóm khá, chỉ cần chọn đúng model là đã tiết kiệm được một khoản.
Phép đo Aeonic tháng 10/2026 cho thấy tiếng Việt chỉ còn phụ phí token 1,24 lần trên Qwen và Gemini
19/10/2026, Aeonic Asia đo lại và ra con số anh em nên giữ trong đầu, phụ phí token tiếng Việt đã hạ nhiều so với 2,45 lần trên tokenizer GPT-4 năm 2023, nhưng mức hạ còn khác nhau khá nhiều giữa các model. Ở cùng giá niêm yết 2 USD cho mỗi triệu token đầu vào, chi phí đầu vào cho cùng tin nhắn tiếng Việt trên Claude Sonnet 5.5 cao gấp khoảng 2,2 lần so với Gemini 4 Argon, nhưng Google đã thông báo giá đầu vào của Gemini 4 Argon tăng gấp đôi vào 01/12/2026, thu hẹp chênh lệch xuống còn khoảng 1,1 lần.
| Model | Phụ phí token tiếng Việt | Mốc đo |
|---|---|---|
| Qwen | 1,24-1,27 lần | 19/10/2026, Aeonic Asia |
| Gemini | 1,24-1,27 lần | 19/10/2026, Aeonic Asia |
| GPT-6 | 1,40 lần | 19/10/2026, Aeonic Asia |
| Claude | 2,00 lần | 19/10/2026, Aeonic Asia |
| GPT-4 | 2,45 lần | 2023 |
Model thử nghiệm đã cũ khoảng 18 tháng và phép đo lại trên DeepSeek V4.1 Flash cho tiếng Trung rẻ hơn tiếng Anh
Thread Hacker News đã xoáy đúng vào điểm yếu lớn nhất của nghiên cứu, model được đo đã cũ, và có người đã tự đo lại trên model mới hơn với kết quả đảo ngược ở vài ngôn ngữ. Đọc thread này thì phần đáng tiền nhất với mình lại nằm ở đây, vì nó quyết định xem con số 180 lần còn dùng được tới đâu hôm nay.
Chu kỳ xuất bản khiến model Qwen 3, Gemma 3 và Llama 3.1 đã cũ khoảng 18 tháng khi tin lên sóng
Paper trình bày tại EMNLP 2026, tin Michigan News đăng 05/11/2026, thread Hacker News lên 10/11/2026, và các model được đo đều ra mắt 2024-2025, tức đã cũ khoảng 18 tháng so với thời điểm tin lên sóng. Trên Hacker News, câu trả lời chung cho chu kỳ xuất bản dài là chạy lại thí nghiệm rất tốn kém và khó tái lập. Chu kỳ xuất bản dài thì đúng là đặc thù học thuật, mình chỉ giữ lại một lưu ý cho anh em, đọc số liệu cứ trừ hao 18 tháng trong đầu.
Phép đo lại trên DeepSeek V4.1 Flash cho tiếng Trung 0,72 lần và tiếng Nga 0,80 lần năng lượng so với tiếng Anh
scottcha, tự nhận làm ở Neuralwatt Cloud, đã tái lập một phần paper trên DeepSeek V4.1 Flash, mỗi ngôn ngữ 50 câu trả lời, và thấy tiếng Trung chỉ tốn 0,72 lần và tiếng Nga 0,80 lần năng lượng so với tiếng Anh, trong khi Pashto miền Nam 2,96 lần, Tigrinya 2,79 lần, Shan 4,21 lần, Tây Tạng 1,81 lần. Anh em nhớ rõ đây là số đo tự báo cáo của một cá nhân trên Hacker News, chưa có kiểm chứng độc lập. Cùng đợt đo đó, trên Qwen3.8-27B-FP8 thì Pashto lên tới 12,49 lần, Tigrinya 13,24 lần và Shan 22,62 lần, nên hướng chênh lệch vẫn còn nguyên với nhóm ít tài nguyên nhất.
Lúc ghi vào watchlist thread này đạt 171 điểm với 95 bình luận, tới lúc mình đọc lại ngày 15/11/2026 thì đã lên 188 điểm với 102 bình luận, tranh luận vẫn đang nóng dần lên chứ chưa nguội.
Paper Michigan bỏ qua speculative decoding và thước đo người bản xứ làm tiếng Anh trông rẻ hơn thực tế
Paper không nhắc tới speculative decoding, kỹ thuật mà hầu hết hệ thống phục vụ thật đều dùng, nên số đo trong phòng thí nghiệm có thể khác với chi phí thật khi chạy dịch vụ, nhưng tỷ lệ chấp nhận đo thêm trên GLM 5.3 khá tương đồng giữa các ngôn ngữ, khoảng 70-80%, nên điểm này chưa đủ để lật kết luận chính.
Nói nôm na, speculative decoding là cách cho một model nhỏ đoán trước nhiều token một lúc rồi để model lớn kiểm tra lại một lượt, nên chạy nhanh hơn và tốn ít điện hơn. PhilipRoman trên Hacker News chỉ ra một điểm tinh tế, thước đo theo số người bản xứ khiến tiếng Anh trông rẻ hơn thực tế, vì người dùng tiếng Anh như ngôn ngữ thứ hai đông gấp khoảng 3 lần người bản xứ và đã viết ra phần lớn kho tài liệu huấn luyện. Mình đồng tình với lưu ý này, khoảng cách đo được phản ánh phần nào chuyện ai viết ra internet, nhưng chênh lệch năng lượng đo bằng điện thật vẫn còn nguyên.
Còn ba ý trên thread đáng nhắc nốt, ion_trapper trên Hacker News chê đo bằng năng lượng thay vì chi phí thì giống activism hơn là benchmark nghiêm túc, mình phản biện lại chỗ này, năng lượng là số đo vật lý trực tiếp, còn chi phí chỉ là hệ quả của nó qua giá token.
manmal bảo trả lời bằng tiếng Đức cũng nhanh như tiếng Anh nên model mới chẳng còn chênh lệch, mình làm rõ là nhanh theo cảm giác cá nhân thì chưa phải số đo, có thể do câu trả lời ngắn hoặc do server rảnh lúc đó.
Và akssri bảo chuyện này Sarvam đã nói nhiều năm nay rồi, cộng với nghiên cứu Nga mà kgeist nhắc tới, đổi tokenizer sang nhiều token Cyrillic hơn rồi post-training lại thì model giữ nguyên chất lượng mà dùng ít token hơn hẳn, và với mình thì đây là bằng chứng vấn đề sửa được bằng thiết kế tokenizer.
Dịch prompt sang tiếng Anh dùng được ngay, model chuyên biệt như Sarvam đã chứng minh và H-Net vẫn là nghiên cứu
Biết mình thiệt ở đâu rồi thì câu hỏi tiếp theo là sửa bằng cách nào, ở đây có cách dùng được ngay hôm nay, có cách đã có người làm thật, và có cách vẫn nằm trên giấy.
Nhóm Michigan nêu gọn hai hướng, định tuyến tới model chuyên cho từng ngôn ngữ, hoặc dịch prompt sang tiếng Anh trước khi đưa vào model tổng quát, và paper đề xuất thêm tối ưu phục vụ theo ngôn ngữ, với batch size và giới hạn độ dài đầu ra riêng từng ngôn ngữ. Ví dụ sống cho hướng model chuyên là model dịch Nhật-Anh 0.8B chạy trên iPhone và hãng tự đo vượt model lớn hơn 30 lần, anh em nhớ đây là số hãng tự đo, chưa có kiểm chứng độc lập.
Dịch sang tiếng Anh rồi dịch kết quả về giảm cả năng lượng lẫn sai sót, trừ nhiệm vụ nặng văn hóa
Pipeline này gồm dịch đầu vào sang tiếng Anh, suy luận bằng tiếng Anh rồi dịch ngược kết quả về ngôn ngữ gốc, có thể giảm tổng năng lượng ngay cả khi tính thêm chi phí hai bước dịch, và còn cải thiện độ chính xác vì bước suy luận chính diễn ra bằng ngôn ngữ model giỏi nhất, nhưng không áp dụng được cho nhiệm vụ nặng sắc thái văn hóa, thành ngữ hay ngữ vực xã hội, vì bản dịch có thể trôi nghĩa.
Tổng hợp khoảng 11 paper cho thấy chain-of-thought hầu như luôn bằng tiếng Anh ngay cả khi đầu vào là ngôn ngữ khác, và English-Pivoted CoT Training đã cải thiện tới 28,33% so với baseline. pridy trên Hacker News hỏi thẳng AI có xử lý bằng tiếng Anh bên trong không, gundugi-man kể hỏi bằng tiếng Hàn thì model thường chuyển sang tiếng Anh ở giữa, và số đo mCoT cho thấy cùng bài toán logic thì model đúng 60% bằng tiếng Anh mà chỉ 5% bằng tiếng Swahili.
Giả thuyết 3 giai đoạn giải thích chuyện này, model suy nghĩ bằng tiếng Anh ở lớp giữa rồi sinh đáp án khớp ngôn ngữ gốc ở lớp cuối, nhưng wongarsu phản biện rằng kiến trúc tương lai có thể suy luận trừu tượng mà không cần token ngôn ngữ nữa, và mình đồng tình có điều kiện, quan sát thực tế là đúng nhưng đây là hệ quả của dữ liệu huấn luyện nghiêng hẳn về tiếng Anh.
Model chuyên biệt như Sarvam giữ phụ phí token dưới 2,6 lần ở mọi ngôn ngữ Ấn Độ
Sarvam là bằng chứng sống đáng tiền nhất của cả bài này, Sarvam-30B và 105B là tokenizer bên thứ ba duy nhất giữ dưới 2,6 lần ở mọi ngôn ngữ Ấn Độ, trung vị 1,53, trong khi trên tokenizer GPT-4o cùng nội dung cần từ 1,57 lần với Hindi tới 5,01 lần với Odia, và 13,7 lần với tiếng Santali chữ Ol Chiki.
Đo trên 4 nền tảng cho thấy prompt Hindi và Marathi tốn nhiều token hơn bản tiếng Anh ở mọi nơi trừ Sarvam AI, nơi prompt tiếng Ấn Độ tốn ít token hơn cả tiếng Anh, Hindi chỉ 0,78 lần, Marathi 0,89 lần, và từ Hindi sanganak nghĩa là máy tính bị tokenizer chuẩn tách thành 6-8 byte con trong khi từ tiếng Anh computer thường là 1 token, nên Sarvam là bằng chứng sống rằng vấn đề sửa được bằng thiết kế tokenizer. Mình giữ lại đúng một kết luận từ mục này, vấn đề nằm ở thiết kế tokenizer, và cái gì thiết kế được thì sửa được.
H-Net học cách chunk byte ngay trong model nhưng số liệu Cartesia chưa có bên ngoài tái lập
Hướng dài hạn từ cộng đồng là bỏ tokenizer cố định, chuyển sang H-Net học cách chunk byte ngay trong model, hiểu đơn giản thì thay vì cắt văn bản thành token theo một bảng cố định từ trước, model tự học cách gom các byte lại thành từng cụm có nghĩa ngay trong lúc chạy, nên ngôn ngữ nào cũng được đối xử theo đúng chữ viết của nó. H-Net một tầng ở mức byte vượt Transformer dùng token BPE khi khớp về compute và dữ liệu, nhưng mọi con số đều là của chính Cartesia, chưa có bên ngoài tái lập độc lập, và bản cải tiến vẫn chưa phát hành, nên đây vẫn là nghiên cứu.
Lập luận tổng bằng không mà vova_hn2 nêu ra thì mình chỉ đồng tình có điều kiện, số lượng token trong vốn từ có hạn, thêm token cho ngôn ngữ này thì phải bớt token cho ngôn ngữ khác, nên tokenizer cố định kiểu gì cũng có người thiệt, cubefox thì đồng tình là H-Net không dùng tokenizer cố định mà dùng các khối byte thích ứng động, còn lifthrasiir bổ sung rằng lượng thông tin vốn có của các ngôn ngữ gần như nhau, nên tokenization nhận biết chữ viết sẽ làm vấn đề này biến mất. Hay thì hay thật, cơ mà tới lúc có sản phẩm thật để anh em dùng thì vẫn còn xa.
Người Việt dùng AI hằng ngày nên viết prompt tiếng Anh khi làm việc dài và giữ tiếng Việt cho hội thoại ngắn
Sau tất cả số liệu và tranh luận, anh em chỉ cần một bộ quy tắc gọn để dùng ngay từ hôm nay, viết bằng tiếng nào, chọn model nào, và khi nào cứ viết tiếng Việt cũng không sao.
Viết prompt tiếng Anh khi làm việc dài, dịch kết quả về tiếng Việt sau cùng
Viết prompt bằng tiếng Anh khi làm việc dài và phức tạp, workflow nhiều bước, tài liệu dài, viết code, vì model suy luận tốt hơn bằng tiếng Anh, tốn ít token hơn và ít rơi vào vòng lặp token explosion hơn, rồi dịch kết quả về tiếng Việt sau cùng khi cần, và cách này người dùng quốc tế đã dùng từ lâu, load-bearing trên Hacker News bảo mình đã làm vậy để tiết kiệm token rồi, còn pmontra dùng tiếng Anh cho AI viết code vì tài liệu ngành hầu hết bằng tiếng Anh.
wickedsight kể từng thuyết trình ở công ty, được hỏi prompt bằng tiếng Hà Lan có ổn không, đã trả lời tiếng Anh có lẽ tốt hơn, nhưng chưa từng nghĩ tới chuyện còn tốn năng lượng hơn, và mình cũng làm kiểu này từ lâu mà tới giờ mới biết nó còn tiết kiệm điện.
Chọn model có tokenizer tốt cho tiếng Việt, Gemma 3 làm ví dụ về vốn từ rộng
Chọn model có tokenizer tốt cho tiếng Việt khi phải làm việc bằng tiếng Việt, vì tokenizer mới là thứ quyết định phụ phí token, và mục tokenizer ở trên đã cho thấy cùng một việc mà đổi sang model có tokenizer tốt hơn thì chi phí giảm mạnh mà không cần đổi cách viết, nên anh em đối chiếu phụ phí token trong bảng Aeonic ở trên trước khi chọn model cho việc dài bằng tiếng Việt.
Còn một hướng nữa ít ai nhắc tới, nghiên cứu Language Matters của Appier cho thấy model thường chuyển sang tiếng Anh để suy luận nội bộ ngay cả khi anh em hỏi bằng ngôn ngữ khác, và nhóm này đề xuất reasoning-language routing, tức chọn ngôn ngữ suy luận theo từng nhiệm vụ, từng thị trường và ngữ cảnh văn hóa, vì suy luận bằng ngôn ngữ địa phương có khi lại hiệu quả hơn ở nhiệm vụ mang tính văn hóa và phát hiện an toàn.
Áp dụng vào tiếng Việt thì quy tắc gọn là thế này, việc dài và nặng logic thì viết tiếng Anh cho model suy luận, việc cần sắc thái văn hóa hay phát hiện nội dung nhạy cảm thì giữ tiếng Việt để model suy luận đúng ngữ cảnh, và trước khi chọn model thì đối chiếu phụ phí token trong bảng Aeonic ở trên.
Cứ viết tiếng Việt khi hội thoại ngắn và khi sắc thái văn hóa quan trọng hơn vài phần trăm chi phí
Cứ viết tiếng Việt khi hội thoại ngắn, hỏi đáp nhanh, việc lặt vặt hằng ngày, vì chênh lệch ở hội thoại ngắn không lớn, và khi nhiệm vụ dựa nhiều vào sắc thái văn hóa, thành ngữ hay ngữ vực xã hội thì viết bằng tiếng Việt giữ được nghĩa gốc mà bản dịch sang tiếng Anh có thể làm trôi. Tiếng Việt nằm trong nhóm khá, nên người Việt không chịu thiệt nặng như nhóm ngôn ngữ ít tài nguyên, việc cần làm chỉ là chọn đúng model và đúng lúc viết tiếng Anh. Mình giữ nguyên thói quen này cho việc lặt vặt hằng ngày, vì vài phần trăm chi phí không đáng để đánh đổi nghĩa gốc.
Nghiên cứu Michigan đo bằng điện thật một bất bình đẳng anh em đã thấy qua hóa đơn token, và tiếng Việt nằm trong nhóm khá
Bức tranh tới đây đã đủ rõ, nghiên cứu Michigan là bằng chứng đo bằng điện thật cho một bất bình đẳng mà anh em đã thấy qua hóa đơn token từ lâu, và với người Việt thì tin tốt là mình nằm trong nhóm khá, chỉ cần chọn đúng model và đúng lúc viết tiếng Anh.
Giá trị lớn nhất của nghiên cứu là đặt năng lượng thành một trục đánh giá chính thức bên cạnh độ chính xác, và anh em nhớ, tin gốc 05/11/2026 đã nguội, model đo là thế hệ 2024-2025, 180 lần là trường hợp tệ nhất với tiếng Pashto, và trên model mới hơn thì tiếng Trung và tiếng Nga thậm chí rẻ hơn tiếng Anh. Anh em đang dùng model nào cho tiếng Việt, và có thấy phụ phí token rõ rệt không, chia sẻ trải nghiệm thật dưới bài để mọi người cùng đối chiếu nhé.
Nguồn tham khảo
- Michigan News, Generative AI uses more energy on non-English text: https://news.umich.edu/generative-ai-uses-more-energy-on-non-english-text/
- Paper EMNLP 2026, The Language-Energy Divide: https://aclanthology.org/2026.emnlp-main.2113/
- Hacker News, thread 50441444: https://news.ycombinator.com/item?id=50441444
- Frank Chu, Bengali costs 6.3x the tokens English does, Dev.to: https://dev.to/frankchu/bengali-costs-63x-the-tokens-english-does-i-counted-3eoh
- Aeonic Asia, Vietnamese token tax: https://www.aeonic.asia/insights/vietnamese-token-tax/
- Michigan Engineering News: https://news.engin.umich.edu/2026/11/generative-ai-uses-more-energy-on-non-english-text/
- TechXplore: https://techxplore.com/news/2026-11-generative-ai-energy-english-text.html
- Nghiên cứu thuế token Ấn Độ, arXiv: https://arxiv.org/html/2611.13058v1
- Sarvam token tax report: https://www.vmugdha.in/blog/token-tax-report.html
- H-Net, arXiv: https://ar5iv.labs.arxiv.org/html/2507.07955
- Vietnam.vn, dùng tiếng Việt với AI agent: https://www.vietnam.vn/en/gallery-dung-dung-tieng-viet-voi-ai-agent-neu-khong-muon-bay-token
- ML.Energy Benchmark, NeurIPS 2025: https://papers.nips.cc/paper_files/paper/2025/file/9dc510e3d7b0b3b2a58ffed7a3ad6b0f-Paper-Datasets_and_Benchmarks_Track.pdf
Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- OpenAI ra mắt Daybreak Red Team và Defense Factory ngày 12/11, bán vòng lặp tìm rồi vá chứ không bán thêm model
- Google Project Zero bỏ quy tắc 90+30 ngày: lỗ hổng sẽ công bố đúng hẹn dù chưa có patch
- Gemini đọc Google Wallet và tài khoản ngân hàng qua Plaid, đọc được gì, ai đọc lại, tắt ở đâu
Bình luận & Trao đổi