📑 Mục lục chi tiết bài viết (30 mục)
- GroundingPI 4B là model chỉ nhìn và chỉ vị trí, XPeng làm ra để làm System 1 cho robot Iron và xe tự lái
- Grounding là gì khi GroundingPI nhìn ảnh và trả tọa độ point và bounding box
- Kiến trúc GroundingPI 4B gồm MoonViT-V2, Qwen3-4B và 1.000 token tọa độ
- 11 nhóm năng lực nhận diện của GroundingPI và vai trò System 1 bên cạnh System 2
- Điểm trung bình 73.68 của GroundingPI so với 71.54 của GPT-6 Astra tính trên 11 nhóm năng lực
- Điểm 73.68 của GroundingPI là trung bình 11 nhóm năng lực có trọng số bằng nhau, tính riêng từng nhóm rồi mới gộp
- Khoảng cách 2.14 điểm giữa GroundingPI và GPT-6 Astra nhỏ hơn nhiều so với chênh lệch từng benchmark
- Vì sao điểm trung bình 73.68 của GroundingPI chưa đủ để nói GroundingPI mạnh hơn GPT-6 Astra nói chung
- GroundingPI thắng GPT-6 Astra ở Dense200, SROIE, M6Doc và RefCOCO
- Dense200 cho GroundingPI thắng đậm nhất 74.53 so với 65.04 của GPT-6 Astra
- SROIE và M6Doc cho GroundingPI thắng GPT-6 Astra ở OCR tài liệu và bố cục văn bản
- RefCOCO, RefCOCO+ và RefCOCOg cho GroundingPI thắng GPT-6 Astra ở grounding theo mô tả
- GPT-6 Astra thắng lại GroundingPI ở ScreenSpot-Pro, RefSpatial và OSWorld-G
- ScreenSpot-Pro cho GPT-6 Astra thắng GroundingPI 93.17 so với 65.78, chênh 27.39 điểm
- RefSpatial và OSWorld-G cho GPT-6 Astra giữ lợi thế spatial và GUI trước GroundingPI
- TotalText và COCO ở IoU 0.95 cho GroundingPI lộ giới hạn biên chính xác
- Robot RoboCasa và RoboTwin cùng xe tự lái nuScenes cho GroundingPI kết quả mô phỏng, tỉ lệ thành công tuyệt đối còn thấp
- RoboTwin 2.0 cho GroundingPI đạt 66.20% ở Full và 17.60% khi đổi môi trường
- RoboCasa-GR1 cho GroundingPI đạt 28.75% với 50% demonstrations, hơn RynnBrain 27.75% với 75%
- nuScenes cho GroundingPI sai số L2 0.296 m, đánh giá open loop, chưa phải lái xe thật
- Thử GroundingPI ngay bằng demo HF Spaces hay tự chạy repo GitHub cần GPU datacenter
- Demo GroundingPI trên HF Spaces là cách thử nhanh nhất, giới hạn demo chưa kiểm chứng
- Lệnh chạy repo GroundingPI cần Linux, Python 3.12, vLLM 0.18.x và GPU B300, B200, H200 hoặc H800
- License GroundingPI chia hai lớp Apache 2.0 và Kimi K3, ngưỡng 20 triệu USD và 100 triệu MAU cần đọc trước khi dùng thương mại
- Bộ benchmark 34 bài của GroundingPI do chính team XPeng lắp ráp và chưa có bên thứ ba chạy lại
- AI Weekly đặt câu hỏi về bộ benchmark GroundingPI do chính team XPeng lắp ráp
- Không có thảo luận GroundingPI trên Hacker News, Reddit hay X tính đến sáng 06/11/2026, OpenAI chưa phản hồi
- Báo chí chia hai phía về GroundingPI, Enchilada và Febspot câu view còn The AI Insider đặt caveat
- Ai nên thử GroundingPI ngay và ai nên chờ bản GroundingPI chạy local nhẹ hơn
- Nguồn tham khảo
Ngày 04/11/2026, XPeng công bố model GroundingPI 4B đạt 73.68 điểm so với 71.54 điểm của GPT-6 Astra trên 34 benchmark nhận diện, chênh 2.14 điểm, anh em khoan tin vội, 2.14 điểm này đo cái gì và ai đo, khi toàn bộ phép đo đều do chính nhóm nghiên cứu thực hiện trên bộ benchmark do chính họ lắp ráp, chưa có bên thứ ba chạy lại độc lập tính đến ngày 06/11/2026.
Tóm tắt nhanh: GroundingPI 4B đạt 73.68 điểm so với 71.54 điểm của GPT-6 Astra, thắng đậm nhất ở Dense200 với 74.53 điểm so với 65.04 điểm, thua đậm nhất ở ScreenSpot-Pro với 65.78 điểm so với 93.17 điểm, thử nhanh nhất bằng demo trên HF Spaces, còn tự chạy repo thì cần GPU datacenter.
GroundingPI 4B là model chỉ nhìn và chỉ vị trí, XPeng làm ra để làm System 1 cho robot Iron và xe tự lái
Trước khi bàn con số 73.68 đáng tin tới đâu, cần rõ GroundingPI làm việc gì, vì model này chỉ làm một việc duy nhất. Mình chốt chỗ này trước vì mọi con số sau đó đều đo đúng việc đó.
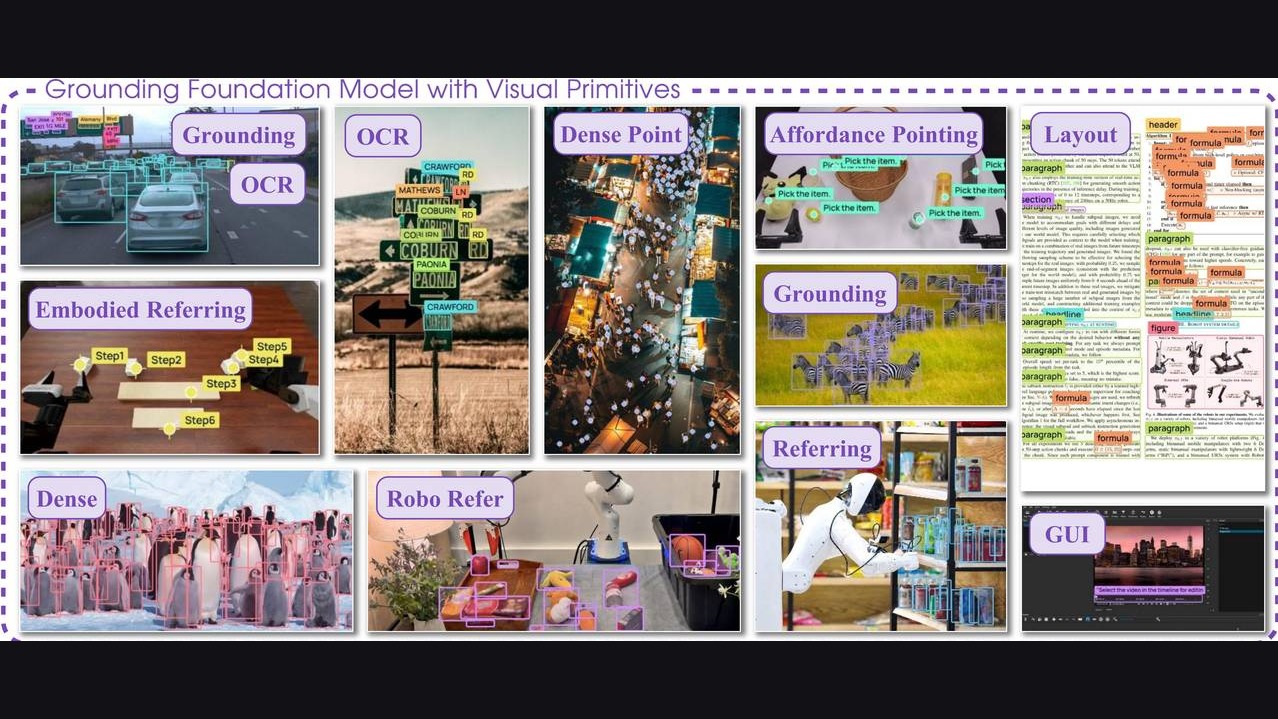
Grounding là gì khi GroundingPI nhìn ảnh và trả tọa độ point và bounding box
GroundingPI là model nhận diện thị giác khoảng 4 tỉ tham số, việc duy nhất là nhìn một tấm ảnh rồi chỉ ra vật cần tìm đang ở đâu, bằng tọa độ point và bounding box trên lưới 0-999 kèm nhãn ngữ nghĩa. Anh em cứ hình dung đưa ảnh căn bếp rồi nhờ tìm cái chảo đỏ, model trả về đúng tọa độ cái chảo đó thay vì mô tả bằng lời. Mình thích kiểu làm hẹp này, chỉ đúng hay chỉ sai là biết ngay.
Kiến trúc GroundingPI 4B gồm MoonViT-V2, Qwen3-4B và 1.000 token tọa độ
GroundingPI gồm vision encoder MoonViT-V2 lấy từ Kimi K3, language decoder Qwen3-4B-Instruct-2507, projector 2×2 spatial aggregation cộng MLP 2 lớp, 1.000 token tọa độ lượng tử từ <0> đến <999>, class GroundingPIForConditionalGeneration và giao thức GAM. Huấn luyện đi qua multimodal và spatial pretraining, SFT rồi RL với GRPO, dùng dữ liệu public cộng data engine riêng của team, một ảnh một request, video bị tắt ở cấu hình deploy mặc định.
11 nhóm năng lực nhận diện của GroundingPI và vai trò System 1 bên cạnh System 2
11 nhóm năng lực mà paper đo gồm object detection, dense object localization, referring expression grounding, OCR, document layout understanding, UI element recognition, robotic spatial localization, cùng các nhóm pointing và visual prompting, với các benchmark cụ thể là COCO, LVIS, Dense200, VisDrone, HumanRef, RefCOCO, RefCOCO+, RefCOCOg, RefSpatial, RoboSpatial, ScreenSpot-V2, ScreenSpot-Pro, OSWorld-G, HierText, ICDAR2015, TotalText, SROIE, DocLayNet, M6Doc và FSC147.
XPeng đặt GroundingPI làm nền tảng nhận diện cho System 1, bổ trợ model lớn lo suy luận ở System 2, model huấn luyện không dùng nhãn hành động của robot, chỉ dùng dữ liệu nhận diện thuần túy. Chatbot trả lời bằng chữ thì không giúp robot cầm đúng cái chảo hay xe nhìn rõ vật cản, nên XPeng làm model chỉ nhìn và chỉ vị trí trước, để chuyện suy luận cho model lớn ở System 2 lo sau.
XPeng bán 429.445 xe trong năm 2025, tăng 126% so với cùng kỳ, đầu năm 2026 hãng gộp hai trung tâm thành trung tâm trí tuệ tổng quát do Liu Xianming dẫn dắt, hãng nói rõ đây là đóng góp nghiên cứu học thuật, chưa có kế hoạch tích hợp vào xe hay robot. Timeline đi khá nhanh, paper arXiv 2609.39601 v1 ngày 30/09/2026 của Qize Yu và 25 đồng tác giả, weights lên Hugging Face ngày 01/10/2026, code lên GitHub ngày 03/10/2026, project site ra mắt ngày 04/10/2026, hạng 1 Paper of the Day ngày 13/10/2026 rồi weights lên ModelScope ngày 14/10/2026, paper sửa v2 ngày 16/10/2026, rồi thông cáo XPeng ngày 04/11/2026 công bố con số 73.68 so với 71.54.
Điểm trung bình 73.68 của GroundingPI so với 71.54 của GPT-6 Astra tính trên 11 nhóm năng lực
Con số headline nghe rất kêu, nhưng cách tính điểm mới là thứ quyết định con số đó có ý nghĩa gì. Mình đọc kỹ mục này vì headline thì ai cũng viết cho kêu được.
Điểm 73.68 của GroundingPI là trung bình 11 nhóm năng lực có trọng số bằng nhau, tính riêng từng nhóm rồi mới gộp
Điểm headline 73.68 của GroundingPI so với 71.54 của GPT-6 Astra, theo số hãng tự đo, là trung bình của 11 điểm năng lực tính độc lập, mỗi nhóm trọng số bằng nhau, chứ 34 benchmark riêng lẻ không cộng thẳng vào một phép trung bình chung. Với cách tính này, GroundingPI cao nhất trong 44 baseline được đo. GPT-6 Astra ra mắt tháng 09/2026, thuộc nhóm trên 1.000 tỉ tham số, còn GroundingPI chỉ khoảng 4B, nên đây là so sánh chéo nhóm kích thước. Mình thấy điểm đáng nói là model 4B chuyên biệt cạnh tranh được với model frontier ở mảng hẹp, và là model duy nhất trong nhóm dưới 10B làm được điều đó ở điểm tổng hợp.
Khoảng cách 2.14 điểm giữa GroundingPI và GPT-6 Astra nhỏ hơn nhiều so với chênh lệch từng benchmark
Khoảng cách headline chỉ 2.14 điểm, trong khi chênh lệch ở từng benchmark riêng lẻ lên tới 27.39 điểm, Dense200 chênh 9.49 điểm theo hướng GroundingPI còn ScreenSpot-Pro chênh 27.39 điểm theo hướng Astra, nghĩa là điểm trung bình đã nén một bức tranh lởm chởm thành một con số trông rất hiền. Anh em chỉ đọc headline sẽ tưởng hai model ngang nhau ở mọi việc, đọc bảng thắng thua mới thấy mỗi bên thắng đậm ở sân riêng.
Vì sao điểm trung bình 73.68 của GroundingPI chưa đủ để nói GroundingPI mạnh hơn GPT-6 Astra nói chung
Chính thông cáo XPeng đã tự giới hạn phạm vi con số này bằng một câu ngắn, “The comparison relates to the evaluated perception benchmarks and does not represent a broader assessment of general AI intelligence or reasoning capabilities.”, tức là so sánh này chỉ đo benchmark nhận diện, không đo trí tuệ hay suy luận nói chung. GroundingPI chỉ đo nhận diện, không đo trò chuyện, viết code hay suy luận nhiều bước, nên đọc headline thành thắng toàn diện là đọc quá, toàn bộ phép đo do chính nhóm nghiên cứu thực hiện trên bộ benchmark do chính họ lắp ráp, chưa có bên thứ ba chạy lại độc lập. Mình thấy câu giới hạn này đáng giá vì chính hãng tự viết ra.
GroundingPI thắng GPT-6 Astra ở Dense200, SROIE, M6Doc và RefCOCO
Sau cách tính điểm thì tới phần đáng tiền nhất của bài, bảng thắng với con số cụ thể từng benchmark. Anh em cứ đối chiếu từng hàng mà đọc.
| Benchmark | GroundingPI | GPT-6 Astra | Chênh lệch |
|---|---|---|---|
| Dense200 box | 74.53 | 65.04 | +9.49 |
| COCO | 62.98 | 62.75 | +0.23 |
| LVIS | 56.02 | 54.97 | +1.05 |
| VisDrone | 40.44 | 37.12 | +3.32 |
| HumanRef referring | 88.56 | 83.01 | +5.55 |
| RefCOCO | 85.62 | 74.98 | +10.64 |
| RefCOCO+ | 84.36 | 78.91 | +5.45 |
| RefCOCOg | 83.92 | 77.81 | +6.11 |
| HumanRef pointing | 88.79 | 83.83 | +4.96 |
| RefCOCOg val pointing | 90.26 | 87.80 | +2.46 |
| RefCOCOg test pointing | 90.06 | 84.90 | +5.16 |
| COCO pointing | 84.79 | 82.17 | +2.62 |
| LVIS pointing | 79.51 | 77.14 | +2.37 |
| VisDrone pointing | 67.47 | 65.62 | +1.85 |
| RoboSpatial Context | 73.77 | 65.69 | +8.08 |
| HierText | 41.70 | 39.58 | +2.12 |
| ICDAR2015 | 55.68 | 48.87 | +6.81 |
| SROIE | 72.47 | 53.57 | +18.90 |
| DocLayNet | 85.08 | 77.54 | +7.54 |
| M6Doc | 74.82 | 60.59 | +14.23 |
Dense200 cho GroundingPI thắng đậm nhất 74.53 so với 65.04 của GPT-6 Astra
Dense200 là benchmark thắng đậm nhất của GroundingPI, 74.53 so với 65.04 của GPT-6 Astra, hơn 9.49 điểm theo số hãng tự đo, cứ tưởng tượng một tấm ảnh đông vật giống nhau, phải khoanh đúng từng cái một chứ không được khoanh gộp hay bỏ sót. COCO chỉ thắng sát nút 0.23 điểm, 62.98 so với 62.75, nên mình không tính đây là thắng lớn.
SROIE và M6Doc cho GroundingPI thắng GPT-6 Astra ở OCR tài liệu và bố cục văn bản
Ở nhóm OCR tài liệu, GroundingPI thắng rõ, SROIE hơn tới 18.90 điểm, 72.47 so với 53.57, M6Doc hơn 14.23 điểm, 74.82 so với 60.59. Đọc hóa đơn rồi chỉ đúng ô số tiền và ô ngày tháng là việc văn phòng dùng mỗi ngày, nên mình thấy đây mới là chỗ đáng tiền. SenseNova-Vision dẫn nhẹ ở DocLayNet với 85.53 điểm, trên GroundingPI 85.08 điểm.
RefCOCO, RefCOCO+ và RefCOCOg cho GroundingPI thắng GPT-6 Astra ở grounding theo mô tả
Nhóm grounding theo mô tả là nhóm thắng đều nhất của GroundingPI trước Astra, RefCOCO hơn tới 10.64 điểm, 85.62 so với 74.98, trong khi RefCOCO+ chỉ hơn 5.45 điểm, 84.36 so với 78.91, và RefCOCOg hơn 6.11 điểm, 83.92 so với 77.81, mà mình thấy khoảng hơn 10.64 điểm ở RefCOCO là con số thuyết phục nhất trong ba cái này, vì nó vừa thắng đậm vừa thắng trên benchmark ai cũng biết. Anh em nhờ tìm người mặc áo đỏ đứng giữa trong ảnh đông người thì sẽ thấy việc này khó ở chỗ model phải hiểu cả mô tả lẫn vị trí.
GPT-6 Astra thắng lại GroundingPI ở ScreenSpot-Pro, RefSpatial và OSWorld-G
Bảng thắng chỉ là một nửa câu chuyện. Anh em đọc tiếp bảng thua với cùng độ chi tiết, vì thiếu nửa còn lại thì headline 73.68 dễ lừa độc giả.
| Benchmark | GroundingPI | GPT-6 Astra | Chênh lệch |
|---|---|---|---|
| ScreenSpot-Pro | 65.78 | 93.17 | -27.39 |
| ScreenSpot-V2 | 96.15 | 97.88 | -1.73 |
| OSWorld-G | 74.82 | 86.70 | -11.88 |
| RefSpatial trung bình | 75.50 | 85.93 | -10.43 |
| RefSpatial Unseen | 75.32 | 81.93 | -6.61 |
| Dense200 pointing | 81.27 | 86.57 | -5.30 |
| TotalText | 49.32 | 53.55 | -4.23 |
ScreenSpot-Pro cho GPT-6 Astra thắng GroundingPI 93.17 so với 65.78, chênh 27.39 điểm
ScreenSpot-Pro là benchmark thua đậm nhất của GroundingPI, chỉ 65.78 so với 93.17 của GPT-6 Astra, kém 27.39 điểm theo số hãng tự đo, đây là benchmark grounding giao diện người dùng ở độ khó cao, tìm đúng nút bấm và ô nhập trên màn hình. Mình đọc con số này thì thấy rõ một điều, GUI dễ thì làm được, GUI khó ở đẳng cấp frontier thì chưa. Nghịch lý ở ScreenSpot-V2, GroundingPI đạt 96.15 so với 97.88 của Astra, gần trần nên GUI dễ vẫn làm được, GUI khó mới lộ khoảng cách, paper tự ghi rõ, “Astra remains stronger overall on both benchmarks. Near-ceiling ScreenSpot-V2 performance therefore does not imply that broader GUI grounding is solved.”
RefSpatial và OSWorld-G cho GPT-6 Astra giữ lợi thế spatial và GUI trước GroundingPI
Ở nhóm spatial, Astra cũng giữ lợi thế rõ, RefSpatial trung bình 85.93 so với 75.50 của GroundingPI, hơn 10.43 điểm, OSWorld-G 86.70 so với 74.82, hơn 11.88 điểm. Spatial là việc nắm vị trí tương đối của vật trong không gian ba chiều, năng lực robot cần khi cầm nắm và di chuyển, nên mình thấy khoảng thua này nặng hơn vẻ ngoài của nó. Paper ở mục 11 Limitations tự thừa nhận, “GroundingPI’s aggregate strength is not uniform dominance: tiny-box localization, high-IoU boundaries, TotalText OCR, FSC147 visual prompting, and frontier-level GUI grounding retain clear gaps.”, tức là sức mạnh tổng hợp của GroundingPI chưa phải thắng đều mọi mặt.
TotalText và COCO ở IoU 0.95 cho GroundingPI lộ giới hạn biên chính xác
Các hàng thua còn lại trong bảng gồm TotalText 49.32 so với 53.55 của Astra, giới hạn biên nằm ở COCO, ở ngưỡng IoU 0.95 thì F1 của GroundingPI chỉ 22.84 dù F1 ở ngưỡng IoU 0.50 đạt 81.16, paper tự ghi đây là giới hạn về độ chính xác biên ngay cả với vật phổ biến. Anh em hình dung khoanh gần đúng thì được điểm ở ngưỡng dễ, khoanh khít mép vật ở ngưỡng khắt khe thì rớt điểm. Robot cần cầm đúng mép vật nên mình không xem đây là lỗi nhỏ. Phụ lục 12.1 nói thêm, “The aggregate gain therefore should not be read as uniformly superior boundary precision: extremely strict localization remains a limitation even on common objects.”, tức là điểm tổng hợp tăng chưa đồng nghĩa biên khoanh chính xác hơn ở mọi ngưỡng.
Robot RoboCasa và RoboTwin cùng xe tự lái nuScenes cho GroundingPI kết quả mô phỏng, tỉ lệ thành công tuyệt đối còn thấp
Nhìn tốt hơn có giúp robot làm việc tốt hơn thật không, và câu trả lời nằm trong mô phỏng với tỉ lệ thành công tuyệt đối còn thấp. Anh em đọc mục này thì nhớ một điều, mọi con số dưới đây đều là mô phỏng.
| Bài test downstream | GroundingPI | Đối chiếu |
|---|---|---|
| RoboTwin 2.0 Full | 66.20% | Nhất bảng |
| RoboTwin 2.0 Clean2Random OOD | 17.60% | Rex-Omni 14.10%, đứng nhì |
| RoboCasa-GR1 Full | 37.75% | RynnBrain 39.00% |
| RoboCasa-GR1, 50% demonstrations | 28.75% | RynnBrain 27.75% với 75% demonstrations |
| nuScenes L2 trung bình | 0.296 m | Qwen3-VL-4B 0.301 m, RynnBrain 0.308 m |
RoboTwin 2.0 cho GroundingPI đạt 66.20% ở Full và 17.60% khi đổi môi trường
RoboTwin 2.0 Full đạt 66.20%, nhất bảng theo số hãng tự đo, nhưng ở thiết lập Clean2Random OOD đổi môi trường thì chỉ còn 17.60% so với Rex-Omni 14.10%, đứng nhì, RoboTwin 2.0 có 50 nhiệm vụ tabletop bimanual. OOD là robot tập trong một căn bếp rồi chuyển sang căn bếp khác bày đồ khác chỗ, tỉ lệ thành công rơi từ 66.20% xuống 17.60%, đổi môi trường vẫn khó, và mình thấy khoảng rơi này mới là con số đáng nhớ. Tất cả đều là mô phỏng và offline, thông cáo XPeng cũng ghi rõ, “The research remains exploratory. Its downstream results are based on simulation and offline evaluations and do not establish readiness for real-world commercial deployment.”
RoboCasa-GR1 cho GroundingPI đạt 28.75% với 50% demonstrations, hơn RynnBrain 27.75% với 75%
RoboCasa-GR1 Full đạt 37.75% so với RynnBrain 39.00%, Type OOD 28.94%, Appearance OOD 37.78%, Container OOD 37.86%, RoboCasa-GR1 là tay khéo léo hình người, quan sát từ camera đầu, không camera cổ tay, nên tỉ lệ thành công tuyệt đối ở đây còn thấp hơn RoboTwin.
Điểm sáng thật sự nằm ở hiệu quả dữ liệu, RoboCasa-GR1 với 50% demonstrations đạt 28.75% so với RynnBrain 27.75% với 75% demonstrations, vì phần nhìn tốt nên policy hành động tận dụng luôn. Anh em đừng để tỉ lệ 28.75% đánh lừa, thắng ở đây là thắng vì học việc nhanh hơn khi đã biết nhìn đồ. Mọi backbone dùng chung Action DiT, dữ liệu hành động và ngân sách huấn luyện, chỉ thay backbone thị giác, nên chênh lệch gán được cho phần nhìn, hiệu quả dữ liệu hành động chỉ test trong manipulation, chưa test ở mảng khác.
nuScenes cho GroundingPI sai số L2 0.296 m, đánh giá open loop, chưa phải lái xe thật
nuScenes cho sai số L2 trung bình 0.296 m so với Qwen3-VL-4B 0.301 m và RynnBrain 0.308 m, cải thiện khiêm tốn và nhất quán, nhất bảng ở phép đo này, nhưng đây là đánh giá open loop, không đo closed-loop hay độ trễ.
Open loop là model đoán quỹ đạo trên dữ liệu ghi sẵn thay vì cầm lái thật, nên sai số 0.296 m chưa nói được xe chạy ngoài đường sẽ an toàn tới đâu, và mình thấy 0.005 m cải thiện so với baseline gần nhất thì đúng là cải thiện, nhưng chưa đủ để kể thành câu chuyện lớn. Paper cũng ghi rõ giới hạn, lái xe chỉ đánh giá open loop, tính nhân quả riêng của OCR vẫn là giả thuyết, physical prompting và System-1 execution mới là hướng gợi ý, chưa chứng minh độc lập.
Thử GroundingPI ngay bằng demo HF Spaces hay tự chạy repo GitHub cần GPU datacenter
Độc giả thử được ngay không, câu trả lời chia đôi, thử demo thì được ngay, tự chạy repo thì cần máy datacenter. Anh em chỉ muốn xem model chỉ vật ra sao thì mở demo là đủ, khỏi cài repo cho mất công.
Demo GroundingPI trên HF Spaces là cách thử nhanh nhất, giới hạn demo chưa kiểm chứng
Cách thử nhanh nhất là demo trên HF Spaces tại model card Hugging Face, link nằm trong box Nguồn tham khảo cuối bài, anh em mở link đó lên rồi thử trực tiếp, đưa ảnh vào và nhờ model chỉ vật. Giới hạn cụ thể của demo chưa được kiểm chứng, gồm cần đăng nhập không, giới hạn lượt dùng, tốc độ phản hồi, mình không bịa các chi tiết này. Anh em tự mở thử rồi kiểm tra.
Lệnh chạy repo GroundingPI cần Linux, Python 3.12, vLLM 0.18.x và GPU B300, B200, H200 hoặc H800
Tự chạy repo thì yêu cầu phần cứng và môi trường khá nặng, Linux x86_64, Python 3.12, Torch và vLLM 0.18.x có sẵn, Transformers 5.7.0 fork đi kèm repo, accelerator đã test gồm NVIDIA B300, B200, H200, H800 và PPU, không có hướng dẫn cho GPU tiêu dùng, laptop, bản GGUF hay Ollama.
git clone https://github.com/groundingpi/GroundingPI.git
pip install -r requirements.txt huggingface_hub
hf download GroundingPI/GroundingPI --local-dir weights/vlm
python3 run.py setup serve
python3 run.py serve
Chạy xong, server mở ở endpoint http://127.0.0.1:8000/v1 với model ID groundingpi, mặc định BF16, eager execution, TP=1, 1 sequence, context 16.384 token, 0.7 accelerator-memory utilization, client Python thì gọi như sau, task bbox trả về box, task point trả về điểm, tọa độ trả về trên lưới 0-999, repo public, tạo ngày 30/09/2026, 25 commit, 363 stars, 14 forks, 2 watchers tại thời điểm đọc 06/11/2026.
from grounding_pi import GroundingPi

client = GroundingPi(
    base_url="http://127.0.0.1:8000/v1",
    model="groundingpi",
)

result = client.predict("your_image.jpg", "the red car", task="bbox")
print(result.to_dict())
License GroundingPI chia hai lớp Apache 2.0 và Kimi K3, ngưỡng 20 triệu USD và 100 triệu MAU cần đọc trước khi dùng thương mại
Đóng góp gốc của project theo Apache 2.0, không thêm hạn chế từ project, material bên thứ ba giữ license riêng, gồm Kimi K3 License cho material dẫn xuất từ Kimi. Hai ngưỡng theo các bài giải thích của bên thứ ba, doanh nghiệp Model as a Service có doanh thu nhóm trên 20 triệu USD trong 12 tháng liên tiếp cần thỏa thuận riêng với Moonshot AI trước khi dùng thương mại, sản phẩm thương mại trên 100 triệu MAU hoặc trên 20 triệu USD doanh thu tháng phải hiển thị tên Kimi K3, dùng nội bộ và dùng qua sản phẩm chính thức hoặc đối tác được chứng nhận của Moonshot được miễn.
Toàn văn file LICENSE của repo GroundingPI chưa đọc trực tiếp, các ngưỡng trên là theo bài giải thích của bên thứ ba, anh em đọc file LICENSE trước khi dùng thương mại. Đọc license trước, đừng đọc sau. Người dùng cá nhân và nghiên cứu thì gần như không chạm ngưỡng này.
Bộ benchmark 34 bài của GroundingPI do chính team XPeng lắp ráp và chưa có bên thứ ba chạy lại
Mọi con số trong bài đều đi qua một bộ benchmark duy nhất, nên mục này soi đúng bộ benchmark đó, ai chọn, ai đo, và cộng đồng đã kịp nói gì. Mình đặt mục này ở cuối vì muốn độc giả đọc hết bảng thắng thua rồi mới quay lại hỏi, số đẹp thì đẹp thật, nhưng ai là người chấm.
AI Weekly đặt câu hỏi về bộ benchmark GroundingPI do chính team XPeng lắp ráp
AI Weekly đặt câu hỏi ngắn mà đắt, “The benchmark lead comes from Xpeng’s own evaluation on a suite it assembled, with no third-party rerun yet, and the project is still described as a scientific prototype.”, tức là vị trí dẫn đầu đến từ phép đo của chính XPeng trên bộ benchmark do chính team lắp ráp, chưa có bên thứ ba chạy lại, project vẫn được mô tả là scientific prototype. Giới hạn phương pháp trong paper cũng ghi rõ, prompt và parser compatibility giới hạn một số phép đo baseline, các foundation khác nhau về scale, kiến trúc và supervision, nên chênh lệch giữa các model không tách sạch được thành chênh lệch của riêng phần nhìn.
Không có thảo luận GroundingPI trên Hacker News, Reddit hay X tính đến sáng 06/11/2026, OpenAI chưa phản hồi
Đã tra trực tiếp API Algolia của Hacker News và tìm kiếm theo site trên Reddit và X, không có thread hay bài đăng nào về GroundingPI tính đến sáng 06/11/2026, các kết quả trả về đều là false positive do substring grounding, gồm GroundingDINO và FAA grounding Boeing 737 Max, tin mới 2 ngày tuổi nên cộng đồng chưa kịp bàn, mình không lấp chỗ trống bằng bình luận tưởng tượng. Cũng không tìm thấy phản hồi công khai nào từ OpenAI về GroundingPI tính đến 06/11/2026.
Báo chí chia hai phía về GroundingPI, Enchilada và Febspot câu view còn The AI Insider đặt caveat
Phía hype, trong các bài viết lại ngày 05/11/2026, Enchilada viết, “a carmaker beating a frontier LLM on embodied perception with a 4B model and giving it away, perception-first beats scale in robots”, video Febspot đặt tiêu đề, “Xpeng GroundingPI: A Car Maker Just Beat OpenAI at Seeing?!”, mình đồng tình ở chỗ perception-first thắng scale là ý đúng, cơ mà chữ beat OpenAI thì nói quá, vì Astra vẫn thắng đậm ở GUI và spatial, ScreenSpot-Pro chênh tới 27.39 điểm.
Phía thận trọng, The AI Insider dùng chữ they claim cho tuyên bố vượt Astra, nhấn mạnh kết quả chỉ là mô phỏng, tỉ lệ thành công robot còn thấp, hãng chưa có kế hoạch tích hợp sản phẩm, bài này nêu cả hai chiều, Dense200 thắng và ScreenSpot-Pro thua. AISengTech ở góc địa chính trị công nghệ, đây là góc nhìn thị trường, khác với đánh giá kỹ thuật, còn CnEVPost trung lập, dẫn lời XPeng, giải thích System 1 và System 2, nêu 2 thách thức triển khai mà mô phỏng đã kiểm chứng, ghi rõ nghiên cứu ở giai đoạn scientific prototype.
Ai nên thử GroundingPI ngay và ai nên chờ bản GroundingPI chạy local nhẹ hơn
Chọn nhanh theo nhu cầu, dev và người làm robotics muốn vọc perception, có GPU datacenter hoặc chỉ cần thử demo HF Spaces thì thử ngay, còn người dùng máy cá nhân và laptop muốn chạy local thì chờ bản nhẹ hơn, đừng cài repo rồi kẹt ở yêu cầu GPU datacenter, ai định đưa vào sản phẩm thương mại thì đọc file LICENSE trước vì còn lớp Kimi K3.
Thắng ở Dense200 74.53 so với 65.04 và SROIE 72.47 so với 53.57, thua ở ScreenSpot-Pro 65.78 so với 93.17 và RefSpatial 75.50 so với 85.93, điểm trung bình 73.68 so với 71.54 là số hãng tự đo trên bộ benchmark do chính team lắp ráp, chưa có bên thứ ba chạy lại. Anh em thử demo xong thì chia sẻ trải nghiệm thật ở phần bình luận, đặc biệt chỗ model chỉ sai vị trí.
Nguồn tham khảo

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Ram Altman gửi email báo RAM nhàn rỗi cho Sam Altman mỗi ngày
- Board Nvidia mở điều tra độc lập về Jensen Huang ngày 08/11, CEO thừa nhận ngoại tình nhưng cáo buộc gián điệp vẫn chưa được chứng minh
- Goldman Sachs thu hồi Claude Code khỏi tay banker và trader, chỉ để lại cho 12.000 kỹ sư
Bình luận & Trao đổi