📑 Mục lục chi tiết bài viết (31 mục)
- 1. Lệnh đó là gì, viết đúng ra sao và dán vào đâu
- 1.1 Cú pháp chính xác của token chung
- 1.2 Chừa một phần cho training bằng Allow carve-out
- 1.3 Dán vào đâu trong robots.txt và kiểm tra thế nào
- 2. Đoạn robots.txt copy-paste dùng ngay
- 2.1 Bản chặn toàn bộ site khỏi AI training
- 2.2 Bản chừa press kit và bản kèm rule cũ
- 3. Hãng nào sẽ đọc lệnh này, hãng nào chưa cam kết
- 3.1 Ba hãng đăng bài riêng, còn Anthropic chỉ có thư mailing list
- 3.2 Meta, Apple, Amazon, xAI và Perplexity vẫn chưa cam kết
- 4. Lệnh bắt đầu có tác dụng khi nào, xem bảng mốc thời gian
- 4.1 Bảng mốc thời gian đầy đủ
- 4.2 Trước từng mốc, giữ rule cũ nào
- 5. Chặn training khác gì chặn AI trả lời và chặn search
- 5.1 Training nghĩa là gì theo định nghĩa chung
- 5.2 Grounding và AI answers cần chỉnh riêng ở đâu
- 5.3 Token mới không động tới search và index
- 6. Cạm bẫy hay gặp khi viết rule
- 6.1 Cạm bẫy wildcard khiến User-Agent sao không chặn được training
- 6.2 Xóa rule cũ sớm, nhầm token hãng với token chung và tưởng token chặn crawl
- 7. Giữ trích dẫn trong AI answers được không, Google và Microsoft trả lời khác nhau thế nào
- 7.1 Ở Google, một dòng chặn cả training lẫn Gemini grounding
- 7.2 Ở Microsoft, training và grounding tách riêng kèm câu cảnh báo về inclusion
- 8. Lệnh này có phải luật, có xóa được dữ liệu cũ không
- 8.1 Bản thảo cá nhân, chưa phải chuẩn chính thức
- 8.2 Không chế tài, không xóa dữ liệu cũ, thỏa thuận riêng có thể lấn át
- 9. Checklist làm ngay bây giờ
- 9.1 Hôm nay thêm token và giữ nguyên rule cũ
- 9.2 Trước 01/03/2027 chốt tùy chọn grounding của Microsoft
- Quyết định nhanh trong một phút
- Nguồn tham khảo
Ngày 30/10/2026, Google, Microsoft và OpenAI đăng bài riêng ủng hộ một tín hiệu robots.txt chung để chủ website nói không với AI training, còn Anthropic thì mình tạm chỉ thấy thư Kevin Kelley gửi mailing list ai-control cùng ngày báo đã bắt đầu triển khai, chưa có ngày đi vào hoạt động hay thông báo riêng của công ty, nghe qua thì gọn như chỉ cần dán một dòng là xong, nhưng đó mới là lời hứa theo từng lộ trình riêng, chưa phải tấm khiên chặn ngay, nên anh em vẫn cần biết dán gì, giữ rule cũ nào, và mất gì ở phía AI answers.
Đọc lướt: dán token chung, giữ nguyên rule cũ, và ở Google thì chặn training cũng rút khỏi Gemini grounding.
1. Lệnh đó là gì, viết đúng ra sao và dán vào đâu
Dán đúng thì chỉ cần một group riêng, sai một ký tự thì coi như chưa nói gì.
1.1 Cú pháp chính xác của token chung
Token chung là __usage_ai-training, với hai gạch dưới ở đầu để tránh trùng tên crawler tình cờ, đặt tên theo cách dùng chứ không theo bot nào, bản thảo IETF mục 4.4 cũng ghi token chỉ là tín hiệu về cách dùng nội dung, chứ không ra lệnh cấm crawler truy cập.
1.2 Chừa một phần cho training bằng Allow carve-out
Bản thảo ví dụ chặn toàn site nhưng chừa thư mục press kit, viết bằng Disallow: / kèm Allow: /press-kit/, và carve-out phải viết tường minh vì quy tắc longest-match của RFC 9309 giữ nguyên.
1.3 Dán vào đâu trong robots.txt và kiểm tra thế nào
Anh em dán group token mới vào file robots.txt ở thư mục gốc, đứng thành group riêng chứ đừng nhét chung vào group User-Agent: *, rồi sau khi lưu thì mở lại file thật để kiểm tra, vì thêm token mới là cộng thêm chứ không thay thế file cũ.
2. Đoạn robots.txt copy-paste dùng ngay
Phần này chỉ còn việc copy đúng bản, sai một ký tự là chưa chặn gì.
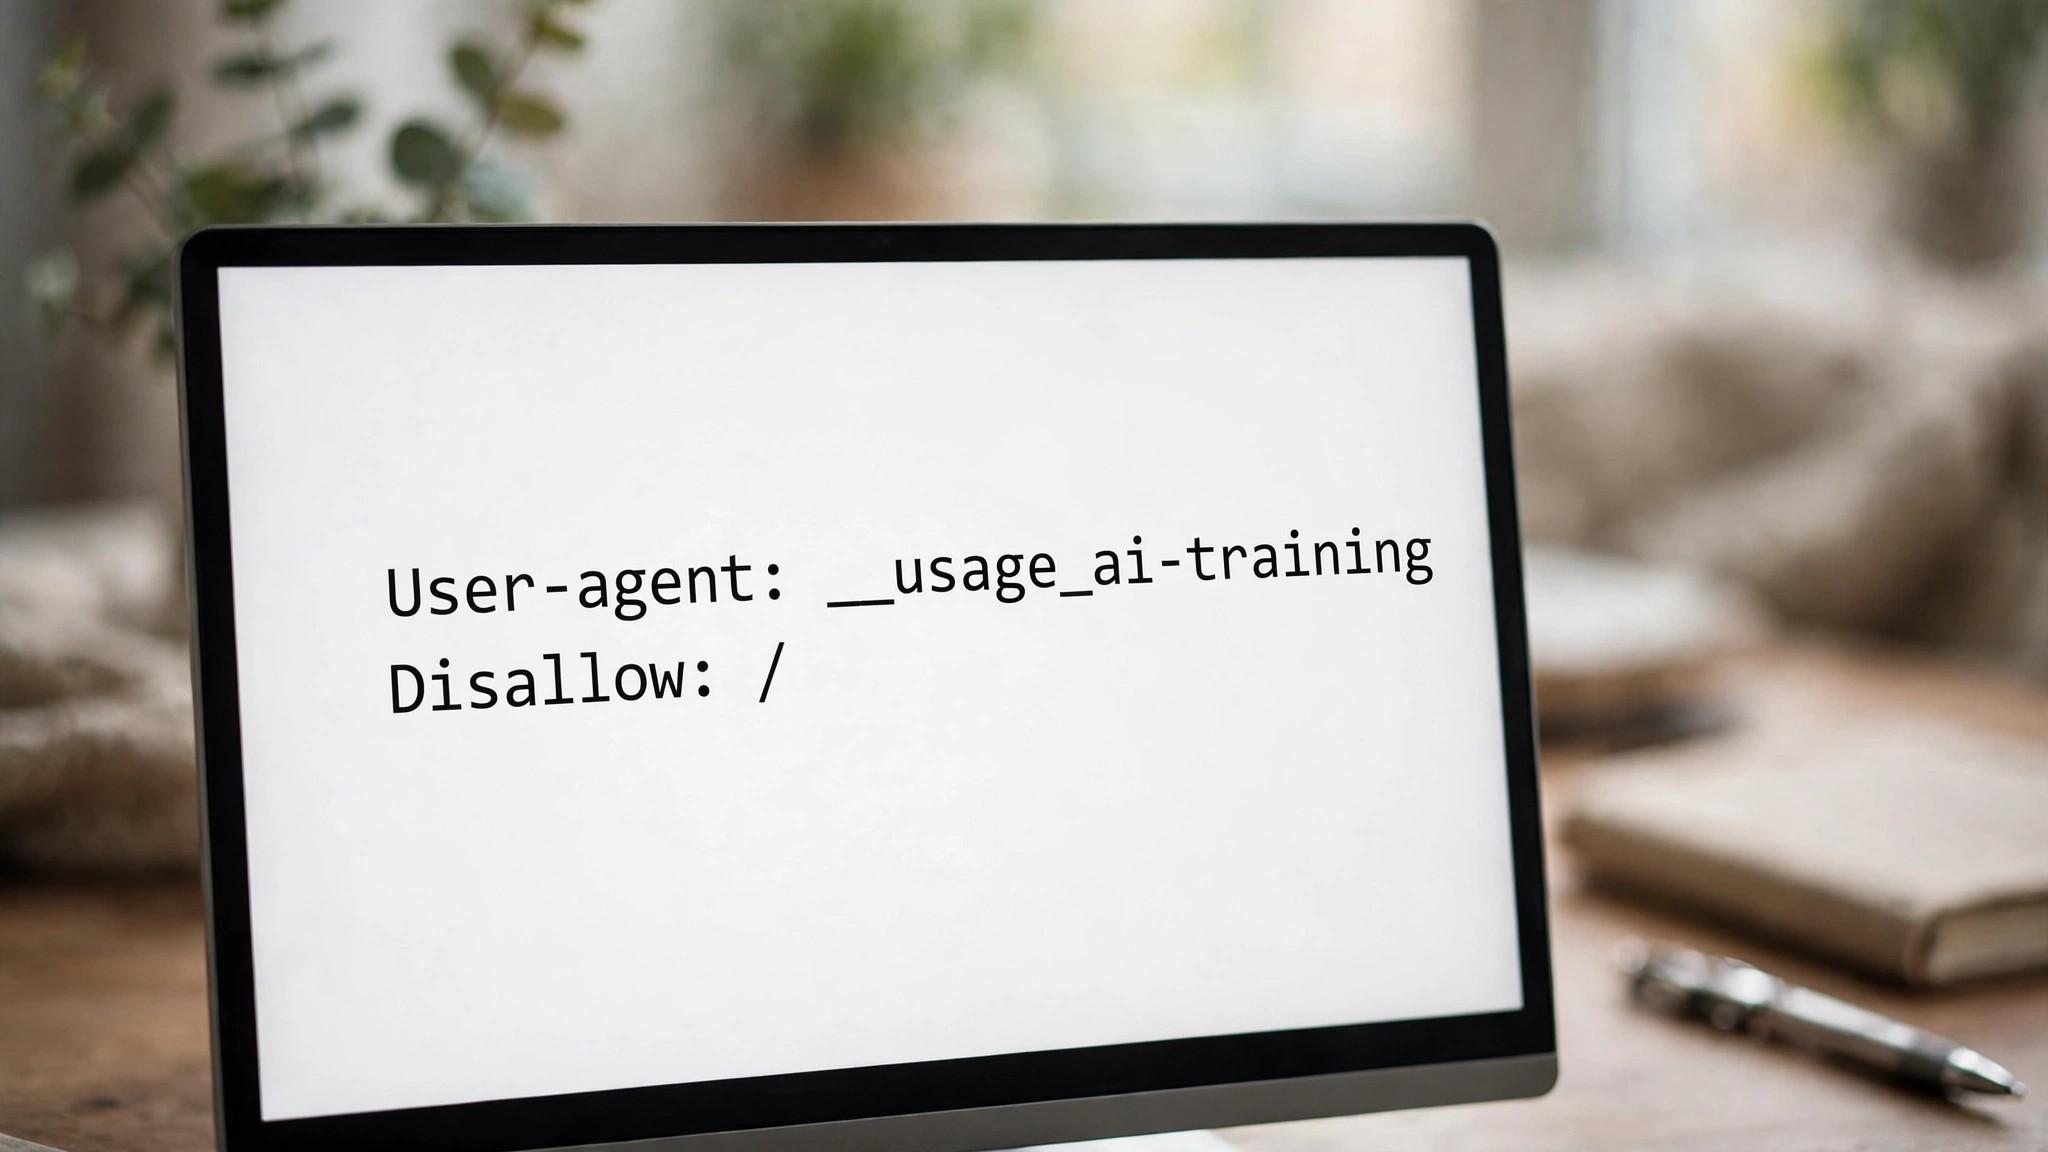
2.1 Bản chặn toàn bộ site khỏi AI training
User-agent: __usage_ai-training
Disallow: /
2.2 Bản chừa press kit và bản kèm rule cũ
Bản chừa press kit:
User-agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Bản đầy đủ nên dùng hôm nay, gồm token mới cộng rule cũ:
User-agent: __usage_ai-training
Disallow: /

User-agent: GPTBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: ClaudeBot
Disallow: /
Tag NoArchive/NoCache ở cấp trang thì anh em cứ giữ nguyên đã, rồi chuyển sang tùy chọn mới của Microsoft trước 1/3/2027.
Dòng Google-Extended thì đừng xóa chỉ vì đã thêm token chung, vì token mới tạm chưa có tác dụng ở mọi hãng.
3. Hãng nào sẽ đọc lệnh này, hãng nào chưa cam kết
Một dòng mà chỉ vài hãng hứa đọc thì tạm chưa thể coi là chặn cả ngành, vì phần còn lại làm theo rule riêng.
3.1 Ba hãng đăng bài riêng, còn Anthropic chỉ có thư mailing list
Ngày 30/10/2026, Google hẹn hỗ trợ đầu năm 2027 qua blog Search Central, còn OpenAI thì hẹn triển khai trong những tháng tới và giữ nguyên control cũ, Microsoft thì theo Search Engine Land và PPC Land trích lại bài Bing Blog mà công bố control training và grounding riêng, còn Anthropic thì tạm chỉ có tín hiệu bắt đầu triển khai qua thư Kevin Kelley gửi mailing list ai-control cùng ngày, chưa có ngày đi vào hoạt động, chứ chưa phải thông báo riêng của công ty.
3.2 Meta, Apple, Amazon, xAI và Perplexity vẫn chưa cam kết
Meta chỉ hoan nghênh tín hiệu chung qua phát ngôn của Andy Stone, mà không nói sẽ tuân theo token. Meta có tên trong bảng cảm ơn, còn Apple, Amazon, xAI và Perplexity thì chưa thấy cam kết trong nguồn đã đọc. Tháng 10/2026 Meta sửa điều khoản dùng nội dung website doanh nghiệp, sau phản ứng thì bỏ chữ “train”, dời hiệu lực sang 20/11/2026.
4. Lệnh bắt đầu có tác dụng khi nào, xem bảng mốc thời gian
Cam kết thì một chuyện, ngày có tác dụng lại là chuyện khác, nên đối chiếu bảng mốc dưới đây rồi chốt.
4.1 Bảng mốc thời gian đầy đủ
| Ngày | Mốc |
|---|---|
| 30/10/2026 | Google, Microsoft, OpenAI đăng bài riêng, Kevin Kelley viết riêng cho mailing list ai-control rằng Anthropic bắt đầu triển khai |
| Những tháng tới sau 30/10/2026 | OpenAI triển khai, chưa có ngày cụ thể |
| 15/12/2026 | Microsoft mở tùy chọn grounding tạm thời trong Bing Webmaster Tools, chỉ cho site đang dùng NoArchive/NoCache |
| Đầu năm 2027 | Google hỗ trợ token chung |
| 01/02/2027 | Microsoft bắt đầu áp dụng training và grounding khi trang được crawl lại |
| 01/03/2027 | Microsoft ngừng đọc NoArchive/NoCache làm tín hiệu training và grounding |
| 03/03/2027 | Control grounding theo cấp trang của Google theo CMA có hiệu lực |
| 03/05/2027 | Bản thảo Kelley hết hạn nếu không sửa đổi |
| 30/09/2027 | Tùy chọn grounding tạm thời của Microsoft hết hạn hoặc sớm hơn khi trang được crawl lại |
Mốc Microsoft trong bảng qua Search Engine Land và PPC Land.
4.2 Trước từng mốc, giữ rule cũ nào
OpenAI giữ GPTBot, Google giữ Google-Extended, Anthropic giữ ClaudeBot, Microsoft giữ NoArchive/NoCache, vì token mới chưa có tác dụng, xóa rule cũ lúc này là tạo khoảng trống.
5. Chặn training khác gì chặn AI trả lời và chặn search
Đây là mục dễ hiểu lầm nhất, vì đọc lướt qua thì nhiều người cứ tưởng một dòng là chặn luôn việc AI trích dẫn bài mình trong câu trả lời.
5.1 Training nghĩa là gì theo định nghĩa chung
Training, theo bản từ vựng AIPREF, là dùng tài sản để thay đổi tham số đã học của model AI tạo sinh, không bao gồm model chỉ làm nhiệm vụ phân loại, xếp hạng hay chấm điểm, OpenAI thu hẹp cách nói thành training cho model nền tạo sinh, điểm này còn là câu hỏi mở.
5.2 Grounding và AI answers cần chỉnh riêng ở đâu
Grounding là hãng lấy trang để trả lời ngay, phần này không nằm trong token training chung, nên phải chỉnh riêng theo từng hãng. Ở Microsoft là tùy chọn Grounding độc lập, ở Google là control Googlebot và Search Console cho AI Overviews và AI Mode cộng với Google-Extended cho Gemini grounding, ở OpenAI là OAI-SearchBot, tách khỏi GPTBot.
5.3 Token mới không động tới search và index
Token training không chặn crawl và không rút trang khỏi index ở Google và Bing, muốn chặn search thì vẫn dùng rule chặn bot tìm kiếm cũ, mà cho phép grounding cũng không đồng nghĩa cho phép training, và ngược lại.
6. Cạm bẫy hay gặp khi viết rule
Viết đúng cú pháp thì tạm chưa đủ, vì thói quen cũ vẫn dễ dính bẫy ngay ở chỗ wildcard.
6.1 Cạm bẫy wildcard khiến User-Agent sao không chặn được training
Bản thảo quy định rõ group wildcard User-Agent: * không được hiểu là khớp với policy token, và nếu không có group nào chứa token thì coi như chưa bày tỏ ý kiến gì, nghĩa là chỉ chặn tất cả bot thì chưa chặn gì ở tầng này, parser cũ cũng không hỏng vì token mới, nó chỉ coi group token là user agent lạ rồi bỏ qua.
6.2 Xóa rule cũ sớm, nhầm token hãng với token chung và tưởng token chặn crawl
Đừng xóa rule riêng từng hãng trước ngày hãng đó hỗ trợ xong, token riêng của hãng cũng không tự động thành tín hiệu chung và ngược lại nên viết cả hai group song song, token thì chỉ là tín hiệu về cách dùng, muốn bot không vào hẳn thì chặn tên bot đó, mà quên đặt lại grounding khi thêm tùy chọn training mới thì có thể đánh rơi hạn chế grounding cũ dựa vào NoArchive/NoCache.
7. Giữ trích dẫn trong AI answers được không, Google và Microsoft trả lời khác nhau thế nào
Đây là chỗ lý thuyết thành tiền và lượt hiển thị thật, vì cùng một dòng mà Google và Microsoft lại xử lý theo hai cách ngược nhau.
7.1 Ở Google, một dòng chặn cả training lẫn Gemini grounding
Ở Google, khi site dùng token chung để chặn training mà không ghi Google-Extended thì Google dự định hiểu đó như thể chủ site đã chặn Google-Extended. Mà Google-Extended bao cả training cho Gemini tương lai, grounding trong Gemini Apps và grounding qua Google Search trên Vertex AI, nên chặn chung ở Google đồng nghĩa rút khỏi cả hai, trừ khi site cho phép Google-Extended tường minh để giữ trích dẫn kèm click, và giá là mở lại training ở Google.
Phần “chặn chung cũng rút khỏi grounding, và Google không có chế độ chặn training nhưng giữ trích dẫn” là cách đọc của PPC Land từ tài liệu Google, chứ không phải câu Google tự tuyên bố. Theo tài liệu Google, chặn hay cho phép Google-Extended cũng không ảnh hưởng tới xuất hiện trên Google Search và không phải tín hiệu xếp hạng.
7.2 Ở Microsoft, training và grounding tách riêng kèm câu cảnh báo về inclusion
Phía Microsoft dễ thở hơn, vì training và grounding tách riêng nên anh em có thể từ chối training mà vẫn cho phép grounding, mặc định cả hai đều Allow. Grounding chỉnh theo cấp trang với ba mức Allow, Disallow và DisallowExtended cho AI Mode, AI Overview, Copilot và Microsoft 365, không bao gồm dịch vụ grounding bên thứ ba, và chỉ có hiệu lực khi trang được crawl lại.
Câu chữ Microsoft ở đây qua Search Engine Land và PPC Land trích lại bài Bing Blog, câu cảnh báo của Microsoft là không lựa chọn nào đảm bảo được đưa vào, được traffic hay được trả tiền, và tùy chọn này không tạo ra thỏa thuận cấp phép hay trả tiền. Chặn grounding làm giảm hiển thị thương hiệu trong trải nghiệm AI, còn cho phép grounding thì đủ điều kiện trích dẫn kèm link.
8. Lệnh này có phải luật, có xóa được dữ liệu cũ không
Câu hỏi cuối cùng về mặt pháp lý, cũng là chỗ quyết định mình nên kỳ vọng bao nhiêu vào một dòng text.
8.1 Bản thảo cá nhân, chưa phải chuẩn chính thức
Bản thảo Kelley là individual submission, trang theo dõi IETF ghi bản thảo không được IETF chứng thực và không có vị thế chính thức, dù tiêu đề ghi intended status là Standards Track. Tác giả duy nhất là Kevin Kelley thuộc Anthropic, nhóm AIPREF họp ngày 21/10/2026 mà chủ tọa nói chưa tuyên bố đồng thuận về gì. Bản thảo hết hạn 03/05/2027 nếu không được sửa đổi, nghĩa là tín hiệu này vẫn đang chuẩn hóa và cách hiểu có thể thay đổi theo thời gian.
8.2 Không chế tài, không xóa dữ liệu cũ, thỏa thuận riêng có thể lấn át
Điều lệ nhóm AIPREF loại trừ cưỡng chế kỹ thuật, bản từ vựng tự nói không đảm bảo ý kiến được tuân theo, ý kiến gắn với thời điểm tài sản được lấy nên không có tác dụng hồi tố, và thỏa thuận riêng có thể lấn át tín hiệu trong file theo mục 4.5 của bản thảo.
Số liệu TollBit tháng 08/2026 qua PPC Land, nguồn đơn lẻ, cho thấy khoảng 15% lượt lấy trang AI ở châu Âu chạm tới URL site đã cấm. Phía hãng gọi đây là bước thực tế cho web mở, phía luật sư và hiệp hội thì nhắc lời hứa tự nguyện khác quyền kiện được, nhà xuất bản thì vẫn muốn được trả tiền.
9. Checklist làm ngay bây giờ
Checklist dưới đây gom việc làm trong hôm nay, việc duy nhất có hạn chót thật sự thì nằm ở mục sau.
9.1 Hôm nay thêm token và giữ nguyên rule cũ
- Thêm group token chung vào
robots.txtở thư mục gốc, thành group riêng. - Giữ nguyên
GPTBot,Google-Extended,ClaudeBotvàNoArchive/NoCache. - Mở lại file kiểm tra group token đứng riêng, không nằm trong wildcard.
- Quyết định có chừa
Allowcho press kit không trước khi lưu.
9.2 Trước 01/03/2027 chốt tùy chọn grounding của Microsoft
- Kiểm tra site có đang dựa vào
NoArchive/NoCachecho training hay grounding không. - Nếu có thì đặt tùy chọn Microsoft trước 01/03/2027, vì tùy chọn chỉ có hiệu lực khi trang được crawl lại.
- Tùy chọn grounding tạm thời mở từ 15/12/2026 chỉ dành cho site dùng
NoArchive/NoCachetính tới ngày đó. - Mốc Microsoft trong mục này cũng qua Search Engine Land và PPC Land.
Quyết định nhanh trong một phút
Nếu chỉ còn một phút thì anh em chỉ cần trả lời bốn câu dưới đây.
Đối chiếu bảng mốc ở mục 4 rồi thì mình chốt thế này: dán token chung ngay vì nó rẻ và gọn, còn rule cũ thì giữ hết tới ngày từng hãng hỗ trợ xong. Đặt tùy chọn grounding của Microsoft trước 01/03/2027 thì cứ đặt nếu site đang dựa vào NoArchive/NoCache, còn cho phép Google-Extended để giữ trích dẫn Gemini kèm click dù biết việc đó mở lại training ở Google thì anh em tự chọn.
Chốt theo cách mình làm, dán token vì nó rẻ và gọn, giữ rule cũ vì nó mới là thứ đang chạy thật hôm nay, và đừng kỳ vọng một dòng text sẽ xóa dữ liệu cũ hay buộc hãng trả tiền, anh em dán xong thì kiểm tra lại file thật rồi chia sẻ trải nghiệm thật ở dưới bài.
Nguồn tham khảo
- IETF, bản thảo Kelley về tín hiệu training: https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
- Google Search Central Blog, bài về control training chung: https://developers.google.com/search/blog/2026/10/ai-training-control
- OpenAI, bài về tín hiệu training chung: https://openai.com/index/helping-websites-express-ai-training-preferences/
- PPC Land, phân tích bốn hãng ủng hộ opt-out chung: https://ppc.land/google-microsoft-openai-and-anthropic-back-one-ai-training-opt-out/
- Search Engine Land, bài về control training và grounding của Microsoft Bing: https://searchengineland.com/microsoft-bing-gives-publishers-more-control-over-how-ai-uses-their-content-499967
- Search Engine Roundtable, bài về control training của Google: https://www.seroundtable.com/google-ai-training-control-42430.html
- Unite.AI, bài về OpenAI tôn trọng tín hiệu robots.txt chung: https://www.unite.ai/openai-to-honor-shared-robots-txt-signal-for-ai-training-preferences/
- Thorsten Meyer AI / Direct Sales Help, phân tích phạm vi opt-out: https://directsaleshelp.com/industry-trends/what-the-four-company-ai-opt-out-covers-and-what-it-doesn-t/
- Zot News, kiểm chứng tin bốn hãng ủng hộ opt-out chung: https://zot.news/article/big-ai-firms-back-shared-publisher-opt-out-standard-abm55
- Skimwire, bài về opt-out robots.txt của bốn hãng: https://www.skimwire.com/ai-training-opt-out-robots-txt-openai-google-microsoft-anthropic/
- Yukesh, bài về Meta gỡ điều khoản training AI: https://www.yukesh.com.np/meta-deletes-ai-scraping-clause
- WebProNews, bài về điều khoản Meta và opt-out: https://www.webpronews.com/meta-updates-terms-to-use-web-content-for-ai-training-shifts-opt-out-to-publishers/
- Unite.AI, bài về Google hỗ trợ control training chung: https://www.unite.ai/google-plans-support-for-shared-robots-txt-ai-training-control/
- Martin Cid, bài về bốn hãng và opt-out robots.txt: https://www.martincid.com/technology-sv/google-openai-anthropic-microsoft-robots-txt-ai-training-opt-out/
- Press Report, bài về phạm vi dữ liệu của opt-out chung: https://press-report.net/ai-news/which-data-does-the-shared-ai-training-opt-out-cover/

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Ram Altman gửi email báo RAM nhàn rỗi cho Sam Altman mỗi ngày
- Board Nvidia mở điều tra độc lập về Jensen Huang ngày 08/11, CEO thừa nhận ngoại tình nhưng cáo buộc gián điệp vẫn chưa được chứng minh
- Goldman Sachs thu hồi Claude Code khỏi tay banker và trader, chỉ để lại cho 12.000 kỹ sư
Bình luận & Trao đổi