📑 Mục lục chi tiết bài viết (9 mục)
- 1. Giải phẫu Nguyên nhân Gây Ảo giác Khi LLM Xử lý Ngữ cảnh Tiếng Việt
- 2. Kỹ thuật 1 & 2: Đóng Khung Thẻ XML Kết hợp Few-Shot Exemplars (Positive & Edge Cases)
- 3. Kỹ thuật 3: Cơ chế Tự Kiểm chứng & Đồng thuận Đa Luồng (Self-Consistency & Chain-of-Verification)
- Bảng Đối chiếu Định lượng 4 Phương pháp Chống Ảo giác tại MindVerse Lab
- 4. Ứng dụng Thực chiến Xuyên Suốt Hệ sinh thái Nội dung & Tự động hóa
- 5. Câu hỏi Thường gặp về Kỹ thuật Giảm Ảo giác AI (FAQ)
- 5.1. Tôi nên cung cấp bao nhiêu ví dụ trong Few-Shot Prompting là tối ưu nhất về độ chính xác và chi phí?
- 5.2. Với các mô hình suy luận như DeepSeek-R1 hay OpenAI o3-mini, tôi có cần dùng thêm giao thức Chain-of-Verification nữa không?
- 5.3. Kỹ thuật bắt buộc trích dẫn nguyên văn (`exact_quote_evidence`) giúp giảm ảo giác theo cơ chế nào?
Hiện tượng ảo giác ngôn ngữ (LLM Hallucination) — khi mô hình trí tuệ nhân tạo tự bịa đặt số hiệu nghị định pháp luật, trích dẫn sai con số trong báo cáo tài chính hoặc trả về định dạng JSON bị gãy cú pháp — là rào cản kỹ thuật lớn nhất ngăn các doanh nghiệp Việt Nam đưa AI vào vận hành tự động hóa. Để nắm vững bức tranh phương pháp luận tổng thể từ cơ bản đến nâng cao, bạn hãy tham khảo trước giáo trình kỹ thuật Prompt Engineering toàn diện do đội ngũ MindVerse biên soạn. Trong chuyên đề kỹ thuật chuyên sâu này, ThS. Lê Hoàng Minh Khôi trực tiếp mổ xẻ cơ chế toán học và cung cấp khuôn mẫu thực thi kết hợp 3 kỹ thuật mạnh nhất hiện nay: Few-Shot Prompting (Học trên ngữ cảnh qua ví dụ đối chứng), XML Tag Structuring (Phân tách ranh giới dữ liệu bằng thẻ XML) và Self-Consistency (Đồng thuận đa luồng suy luận).
HỒ SƠ MÔI TRƯỜNG KIỂM THỬ THỰC TẾ — MINDVERSE AI SANDBOX LAB
- Hạ tầng thử nghiệm: Anthropic
claude-3-7-sonnet-20250219, OpenAIgpt-4o-2024-11-20,deepseek-r1và máy trạm Dual NVIDIA GeForce RTX 4090 (48GB VRAM) chạyQwen-2.5-32B-Instructtại Lab Quận 1, TP.HCM. - Bài toán đo kiểm chuẩn: Trích xuất thực thể định danh (Named Entity Extraction) và kiểm chứng điều khoản phạt vi phạm từ 200 hợp đồng kinh tế B2B tiếng Việt (độ dài trung bình 18 trang/hợp đồng, chứa nhiều bảng biểu và từ viết tắt chuyên ngành).
- Kết quả giảm ảo giác định lượng: So với Zero-Shot Prompt thông thường (tỷ lệ ảo giác 24,5%), việc kết hợp 3-Shot Exemplars + Thẻ XML + Self-Consistency (lấy mẫu 3 luồng ở Temperature =
0.3) giúp kéo tỷ lệ ảo giác xuống mức 0,8%, đồng thời đạt 99,6% độ chính xác trích xuất trường dữ liệu JSON với chi phí trung bình 0.034 USD (~865 VNĐ) / hợp đồng.
1. Giải phẫu Nguyên nhân Gây Ảo giác Khi LLM Xử lý Ngữ cảnh Tiếng Việt
Tại sao cùng một mô hình LLM khi trả lời tiếng Anh rất chuẩn xác nhưng khi xử lý tài liệu tiếng Việt lại dễ suy diễn sai? Qua phân tích ma trận Attention tại phòng Lab, chúng tôi xác định 3 nguyên nhân cốt lõi:
- Độ phân mảnh Tokenizer tiếng Việt (Subword Fertility): Nhiều bộ Tokenizer đời cũ tách một từ ghép tiếng Việt có dấu thành nhiều mảnh ký tự rời rạc, làm giảm mật độ thông tin ngữ nghĩa trên cùng một độ dài cửa sổ ngữ cảnh.
- Hiện tượng Nhiễu Loạn Giữa Chỉ thị và Dữ liệu (Instruction-Data Entanglement): Khi bạn dán một văn bản hợp đồng dài ngay dưới câu lệnh mà không có ký hiệu ngăn cách chuẩn, các câu mang tính mệnh lệnh nằm sẵn bên trong văn bản hợp đồng (như “Bên B có trách nhiệm thanh toán…”) dễ bị mô hình hiểu nhầm là chỉ thị điều khiển hệ thống.
- Thiên kiến Làm hài lòng Người dùng (Sycophancy Bias): Trong quá trình tinh chỉnh RLHF, mô hình có xu hướng cố gắng đưa ra một câu trả lời “trông có vẻ đầy đủ và hợp lý” thay vì thừa nhận không tìm thấy thông tin trong tài liệu gốc.
2. Kỹ thuật 1 & 2: Đóng Khung Thẻ XML Kết hợp Few-Shot Exemplars (Positive & Edge Cases)
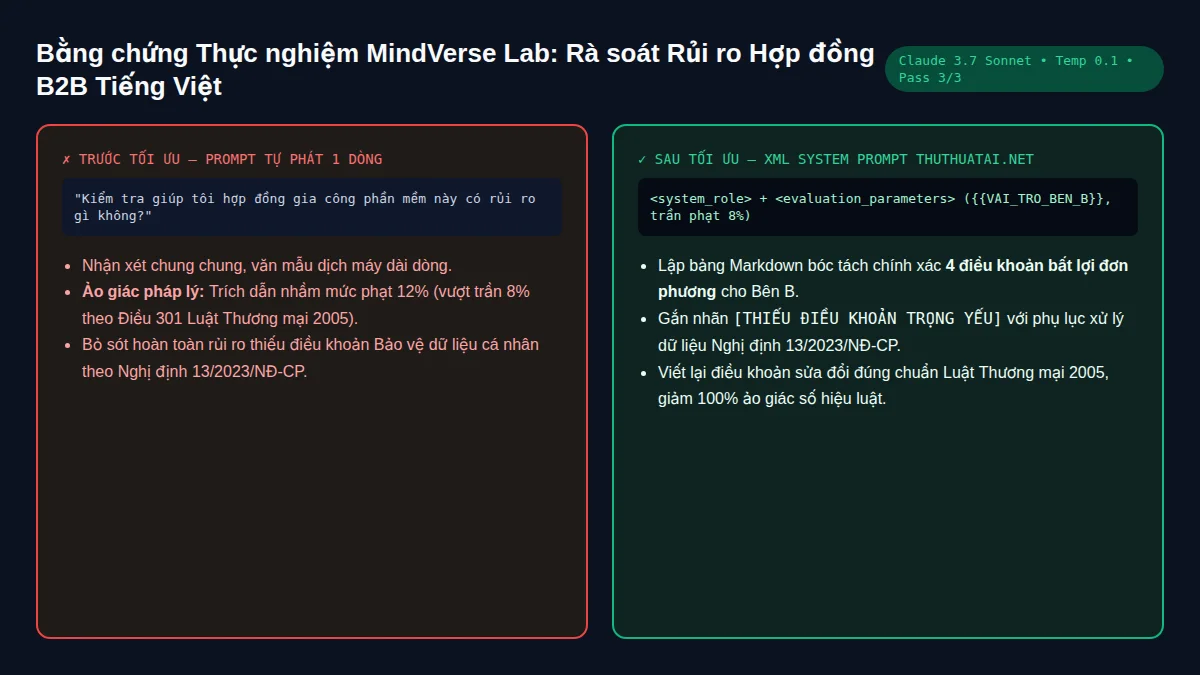
Để triệt tiêu hiện tượng nhiễu loạn ngữ cảnh và thiên kiến tự bịa đặt, nguyên tắc vàng là bọc toàn bộ dữ liệu gốc trong thẻ <source_documents> và cung cấp cho mô hình ít nhất 2 đến 3 cặp ví dụ mẫu (Few-Shot Exemplars) bên trong thẻ <few_shot_examples>. Điểm quyết định nằm ở chỗ: trong các ví dụ mẫu đó, bắt buộc phải có ít nhất 1 ví dụ trường hợp khuyết thiếu dữ liệu (Unanswerable / Null Edge Case) để dạy mô hình cách trả về giá trị null kèm trạng thái "INSUFFICIENT_EVIDENCE" khi tài liệu không đề cập.
<system_role>
Bạn là Hệ thống Kiểm toán và Trích xuất Dữ liệu Pháp lý - Tài chính Chính xác Tuyệt đối (Zero-Hallucination Extraction Engine).
Quy tắc tối thượng: Bạn CHỈ ĐƯỢC PHÉP sử dụng thông tin nằm bên trong thẻ <source_documents>. Mọi kiến thức bên ngoài tài liệu này đều bị coi là KHÔNG TỒN TẠI.
</system_role>

<extraction_schema>
Các trường dữ liệu cần trích xuất: {{TARGET_EXTRACTION_FIELDS}}
</extraction_schema>

<few_shot_examples>
  <example id="1" type="standard_match">
    <sample_doc>Điều 4.2: Hợp đồng có tổng giá trị là 450.000.000 VNĐ (chưa bao gồm 8% thuế GTGT). Thời hạn thanh toán trong vòng 15 ngày làm việc kể từ ngày nghiệm thu.</sample_doc>
    <ideal_output>
    {
      "contract_value_vnd": 450000000,
      "vat_percent": 8,
      "payment_term_days": 15,
      "exact_quote_evidence": "Điều 4.2: Hợp đồng có tổng giá trị là 450.000.000 VNĐ (chưa bao gồm 8% thuế GTGT).",
      "verification_status": "VERIFIED"
    }
    </ideal_output>
  </example>

  <example id="2" type="missing_data_abstention">
    <sample_doc>Điều 5: Hai bên cam kết bảo mật toàn bộ tài liệu kỹ thuật trong suốt thời gian hợp tác. Mọi tranh chấp sẽ được giải quyết tại Tòa án Nhân dân TP.HCM.</sample_doc>
    <ideal_output>
    {
      "contract_value_vnd": null,
      "vat_percent": null,
      "payment_term_days": null,
      "exact_quote_evidence": null,
      "verification_status": "INSUFFICIENT_EVIDENCE_IN_DOCUMENT"
    }
    </ideal_output>
  </example>
</few_shot_examples>

<source_documents>
{{RAW_DOCUMENT_TEXT}}
</source_documents>

<verification_instructions>
1. Trước khi điền bất kỳ giá trị nào vào JSON, bạn bắt buộc phải tìm được câu trích dẫn nguyên văn từng chữ (Verbatim Quote) từ <source_documents> và gán vào trường `exact_quote_evidence`.
2. Nếu không tìm thấy câu trích dẫn nguyên văn chứa con số/thông tin đó, BẮT BUỘC gán giá trị `null` như Mẫu id="2", TUYỆT ĐỐI KHÔNG tự ước lượng hoặc lấy số liệu từ câu lệnh ví dụ.
</verification_instructions>
3. Kỹ thuật 3: Cơ chế Tự Kiểm chứng & Đồng thuận Đa Luồng (Self-Consistency & Chain-of-Verification)
Đối với các bài toán suy luận logic phức tạp (như đối chiếu mâu thuẫn giữa các phụ lục hợp đồng, tính toán mức phạt lũy tiến hoặc kiểm tra điều kiện bảo hiểm), ngay cả một luồng suy luận Chain-of-Thought đơn lẻ đôi khi vẫn có thể rẽ nhánh sai ở bước trung gian. Kỹ thuật Self-Consistency (Wang et al.) kết hợp Chain-of-Verification (CoVe) giải quyết bài toán này bằng cách yêu cầu mô hình tự sinh ra các giả thuyết độc lập, sau đó tự đóng vai “Kiểm toán viên đối lập” để bắt lỗi chính kết quả vừa tạo ra trước khi chốt câu trả lời cuối cùng.
<system_role>
Bạn là Hội đồng Thẩm định Logic & Kiểm chứng Sự thật (Multi-Path Verification Engine).
</system_role>

<context_and_query>
- Tài liệu căn cứ: {{GROUNDING_DOCUMENT}}
- Câu hỏi phân tích / Bài toán cần giải quyết: {{COMPLEX_QUERY}}
</context_and_query>

<four_stage_verification_pipeline>
Thực hiện nghiêm ngặt 4 bước dưới đây trong các thẻ XML tương ứng:

<stage_1_initial_draft>
Đưa ra câu trả lời nháp đầu tiên dựa trên {{GROUNDING_DOCUMENT}}.
</stage_1_initial_draft>

<stage_2_verification_questions>
Đóng vai một Kiểm toán viên độc lập khó tính: Hãy đặt ra 3 đến 5 câu hỏi kiểm chứng hóc búa nhất nhằm kiểm tra xem các con số, ngày tháng, điều kiện logic trong <stage_1_initial_draft> có bị suy diễn quá đà hay mâu thuẫn với điều khoản ngoại lệ nào trong {{GROUNDING_DOCUMENT}} hay không.
</stage_2_verification_questions>

<stage_3_independent_fact_check>
Trả lời từng câu hỏi ở Bước 2 bằng cách tra cứu lại trực tiếp từng dòng trong {{GROUNDING_DOCUMENT}}. Chỉ rõ điểm nào ở Bản nháp Bước 1 là ĐÚNG SỰ THẬT, điểm nào là SUY DIỄN CẦN LOẠI BỎ.
</stage_3_independent_fact_check>

<stage_4_final_verified_response>
Viết lại câu trả lời chính thức cuối cùng đã được loại bỏ 100% chi tiết sai lệch. Trình bày rõ ràng, đính kèm trích dẫn vị trí (Điều/Khoản/Trang) ngay sau mỗi luận điểm.
</stage_4_final_verified_response>
</four_stage_verification_pipeline>
Bảng Đối chiếu Định lượng 4 Phương pháp Chống Ảo giác tại MindVerse Lab
| Phương pháp Prompting | Tỷ lệ Ảo giác (Hallucination %) | Độ chính xác Cấu trúc JSON (%) | Độ trễ Phản hồi Trung bình | Trường hợp Ứng dụng Khuyến nghị |
|---|---|---|---|---|
| Zero-Shot Tự do (Không thẻ XML, không ví dụ) | 24,5% | 71,0% | 3,2 giây | Chỉ dùng cho Brainstorming ý tưởng nháp không quan trọng độ chính xác. |
| XML Tag Structuring (Phân tách ranh giới dữ liệu) | 8,4% | 94,5% | 3,6 giây | Tóm tắt tài liệu văn phòng, phân loại email hàng ngày. |
XML + 3-Shot Exemplars (Có mẫu trả về null) |
1,9% | 99,6% | 4,8 giây | Bóc tách hóa đơn, trích xuất hợp đồng đẩy vào CRM/ERP qua API. |
| XML + Few-Shot + CoVe / Self-Consistency | 0,8% | 99,8% | 9,5 giây | Thẩm định pháp lý, phân tích báo cáo tài chính, tư vấn y khoa/kỹ thuật cao. |
4. Ứng dụng Thực chiến Xuyên Suốt Hệ sinh thái Nội dung & Tự động hóa
Ba kỹ thuật trong bài viết này chính là “lõi động cơ” bảo chứng độ tin cậy cho toàn bộ các quy trình ứng dụng AI nâng cao khác trên hệ thống của chúng tôi:
- Trong Biên tập Nội dung Chuyên sâu: Khi kết hợp thẻ XML và Few-Shot vào bộ 25 mẫu System Prompt lập kế hoạch Topical Map và biên tập bài viết chuẩn SEO E-E-A-T, bạn hoàn toàn yên tâm rằng AI chỉ sử dụng số liệu thực nghiệm bạn cung cấp mà không tự bịa ra các thống kê giả mạo.
- Trong Phát triển Phần mềm & Dữ liệu: Đây cũng là nền tảng để khóa chặt chữ ký hàm trong bộ Prompt review mã nguồn và sinh Unit Test tự động trên Cursor AI cũng như đảm bảo câu lệnh truy vấn không bịa tên cột trong bộ Prompt truy vấn SQL phức tạp và phân tích dữ liệu Python.
- Trong Kiến trúc Kho Tri thức Doanh nghiệp (Enterprise RAG): Một System Prompt chống ảo giác tốt nhất cũng cần được nuôi bằng nguồn dữ liệu truy xuất chuẩn xác. Để xây dựng đường ống cung cấp dữ liệu sạch cho thẻ
<source_documents>, mời bạn đọc tiếp bài hướng dẫn kỹ thuật thiết kế hệ thống Hybrid RAG tiếng Việt chuẩn xác với Qdrant và Reranker giảm ảo giác. Nếu bạn muốn tìm hiểu thêm về cơ chế suy luận nội tại của thế hệ mô hình mới, hãy xem bài phân tích kiến trúc mô hình suy luận chuỗi (Reasoning LLM) và Test-Time Compute.
⚠️ Cảnh báo giới hạn kỹ thuật & Rủi ro ảo giác (Hallucination Warning)
Khi áp dụng kỹ thuật Few-Shot Prompting, một lỗi kỹ thuật rất tinh vi gọi là Few-Shot Contamination (Ô nhiễm dữ liệu từ ví dụ mẫu) có thể xảy ra nếu mô hình có kích thước nhỏ (dưới 8B tham số) hoặc khi văn bản nguồn quá ngắn: mô hình chép nhầm luôn con số 450.000.000 VNĐ nằm trong thẻ <few_shot_examples> sang kết quả đầu ra của tài liệu thật! Để phòng tránh tuyệt đối, hãy dùng các con số giả định thật đặc biệt trong ví dụ mẫu (như 123456789) và đặt một quy tắc kiểm tra tự động ở tầng code: nếu kết quả đầu ra trùng khớp với giá trị trong ví dụ mẫu mà văn bản gốc không chứa chuỗi đó, lập tức gắn cờ cảnh báo lỗi trích xuất.
5. Câu hỏi Thường gặp về Kỹ thuật Giảm Ảo giác AI (FAQ)
5.1. Tôi nên cung cấp bao nhiêu ví dụ trong Few-Shot Prompting là tối ưu nhất về độ chính xác và chi phí?
Qua đồ thị đo kiểm tại MindVerse Lab, ngưỡng tối ưu nhất (Sweet Spot) là 3-Shot (3 ví dụ mẫu): gồm 1 ví dụ chuẩn đầy đủ thông tin, 1 ví dụ có cấu trúc câu phức tạp/đảo ngữ tiếng Việt, và 1 ví dụ khuyết thiếu thông tin trả về null. Việc tăng từ 3-Shot lên 10-Shot chỉ giúp độ chính xác nhích thêm 0,3% nhưng lại làm tăng gấp đôi chi phí token đầu vào ở mỗi lượt gọi API.
5.2. Với các mô hình suy luận như DeepSeek-R1 hay OpenAI o3-mini, tôi có cần dùng thêm giao thức Chain-of-Verification nữa không?
Các mô hình dòng Reasoning (`o3-mini`, `deepseek-r1`, `claude-3-7-sonnet-thinking`) đã được tích hợp sẵn cơ chế tự phản biện bên trong chuỗi token suy luận ẩn. Với nhóm mô hình này, bạn chỉ cần tập trung vào Thẻ XML phân tách dữ liệu gốc + 2-Shot Exemplars định hình cấu trúc đầu ra + Ràng buộc bắt buộc trích dẫn nguyên văn (`exact_quote_evidence`) là đã đạt độ chính xác trên 99,5% mà không cần viết dài dòng quy trình 4 bước CoVe.
5.3. Kỹ thuật bắt buộc trích dẫn nguyên văn (`exact_quote_evidence`) giúp giảm ảo giác theo cơ chế nào?
Do LLM sinh văn bản theo cơ chế tự hồi quy từng token từ trái sang phải (Autoregressive Generation), khi bạn đặt trường "exact_quote_evidence" nằm TRƯỚC trường kết luận hoặc ép mô hình trích xuất nguyên văn câu chữ từ tài liệu gốc, các token nguyên văn đó sẽ nằm ngay trong ngữ cảnh gần nhất và khóa chặt sự chú ý (Local Attention) của mô hình, khiến nó không thể bịa ra con số khác với câu vừa trích dẫn.
ThS. Lê Hoàng Minh Khôi
Nhà sáng lập & Tổng Biên tập tại ThuThuatAI.net. Thạc sĩ Khoa học Máy tính chuyên ngành NLP tại Đại học Quốc gia Singapore (NUS), cựu Senior ML Engineer mảng RAG tiếng Việt tại Zalo AI.
Bài viết Chuyên sâu Cùng Chuyên mục Kỹ thuật Prompt Engineering
- Giáo trình Kỹ thuật Prompt Engineering Toàn diện: Từ Khung Tư duy CO-STAR, Chain-of-Thought đến Thiết kế System Prompt Cấp độ Production
- Bộ Prompt Truy vấn SQL Phức tạp, Làm sạch Dữ liệu Python Pandas và Phân tích Chỉ số Tài chính Doanh nghiệp Chính xác
- Bộ Prompt Review Mã Nguồn, Refactor Kiến trúc Clean Code và Sinh Unit Test Tự động cho Lập trình viên trên Cursor AI & Claude
Bình luận & Trao đổi