📑 Mục lục chi tiết bài viết (25 mục)
- Baidu vừa mở weights cái gì, và vì sao đây chưa phải một chatbot để dùng ngay
- 280B tổng, 14B active mỗi token, pre-train trên 33.5T tokens
- Base model khác chatbot ở những điểm nào
- Ai là người được hưởng lợi thật từ một checkpoint thô
- MMLU 93.3 đẹp thật đấy, nhưng bảng so sánh này đang so với bản cũ
- Bảng điểm 30 benchmark, thắng ở đâu và thua ở đâu
- Vì sao cộng đồng chê bảng so sánh là “so với bản cũ”
- Đọc bảng điểm như người thực chiến, tin được bao nhiêu
- Việt Nam không bị loại khỏi giấy phép, nhưng ngưỡng 50 triệu USD và lệnh cấm distill vẫn áp dụng
- Ai dùng được, ai không, và vị trí của Việt Nam
- Ngưỡng 50 triệu USD hoạt động ra sao, và “Powered by ERNIE” là bắt buộc
- Lệnh cấm distill và điều khoản chấm dứt, cái bẫy ít người đọc
- Tải về rồi dùng ngay được không, và muốn chạy thử thì cần máy cỡ nào
- Tải về và gọi thử bằng Transformers, SGLang, vLLM
- 280GB hay 560GB, và con số 1M context có nghĩa gì
- Muốn dùng thật thì phải huấn luyện thêm bằng fine-tune và Megatron Bridge
- Nén 128 token thành 1, MoE nhiều router và ECHO, kiến trúc này đánh cược vào hiệu quả
- 37 lớp nén 128 token thành 1, 6 lớp giữ lại toàn cảnh
- 512 experts, top-10, và vì sao một router là chưa đủ
- ECHO, mHC, MultiMax và FlashMask-4, những mảnh còn lại của bức tranh hiệu quả
- 16 tháng giữ kín ERNIE 5.0 và 5.1, rồi Kimi mở weights chỉ một ngày trước
- 16 tháng im lặng, ERNIE 4.5 mở còn ERNIE 5.0 và 5.1 giữ kín
- Kimi K3.1 Pro một ngày trước, cùng tuần nhưng khác loại release
- Ai nên dùng ERNIE 5.5 Flash Base, ai nên chờ bản post-trained
- Nguồn tham khảo
Baidu vừa mở weights một model 280B với MMLU 93.3 (Baidu tự đo, chưa kiểm chứng độc lập), nghe qua thì tưởng tải về là có ngay một chatbot khủng để xài, nhưng tải về xong anh em mới thấy mình đang cầm một checkpoint thô cuối pre-training, chưa qua bất kỳ vòng post-training nào, và phần việc khó nhất, từ huấn luyện thêm tới lo giấy phép và phần cứng, vẫn nằm ở phía người dùng.
Thông tin nhanh
– Baidu mở weights ERNIE 5.5 Flash Base ngày 5/11/2026: sparse MoE 280B tổng, 14B active mỗi token, pre-train từ đầu trên 33.5T tokens, context huấn luyện tới 128K, hỗ trợ fine-tune và inference tới 1M token (1,048,576).
– Đây là base model thô, checkpoint cuối pre-training, chưa qua mid-training hay post-training, không có chat alignment, không có chat template, gọi quacompletionsAPI chứ không phảichat/completions.
– Baidu tự đo, chưa kiểm chứng độc lập: MMLU 93.3, đứng đầu 24/30 benchmark, thua 6 benchmark (ChineseSimpleQA, BBH-CoT, INCLUDE-lite, FullStackBench, HELMET-Rerank, InfiniteBench).
– Giấy phép custom v1.0: Territory trừ EU, UK, Hàn Quốc; Việt Nam KHÔNG bị loại; dùng thương mại trên 50 triệu USD doanh thu liên quan/năm cần xin phép bằng văn bản trước; cấm distill sang model khác (§5.5).
– Chạy thử cần phần cứng datacentre: FP8 khoảng 280GB, BF16 khoảng 560GB trước KV cache, đã verify trên NVIDIA GB200 và H100, bản post-trained chưa có ngày ra mắt.
Baidu vừa mở weights cái gì, và vì sao đây chưa phải một chatbot để dùng ngay
Trước khi bàn điểm số hay giấy phép, anh em cần nắm đúng thứ Baidu vừa đưa lên Hugging Face, vì nhầm base model với chatbot là nhầm ngay từ đầu.
280B tổng, 14B active mỗi token, pre-train trên 33.5T tokens
Ngày 5/11/2026, blog chính thức của Baidu lên bài và weights được đưa lên Hugging Face ở hai repo baidu/ERNIE-5.5-Flash-Base bản FP8 và baidu/ERNIE-5.5-Flash-Base-BF16 bản BF16, kèm mirror trên ModelScope. Đây là một text-only sparse MoE, tức model ngôn ngữ thuần văn bản mà mỗi token chỉ kích hoạt một phần nhỏ trong tổng tham số, cụ thể là 280B tổng nhưng chỉ 14B active mỗi token. Model được pre-train từ đầu trên 33.5T tokens bằng optimizer Muon và FP8 mixed precision, context huấn luyện mở dần tới 128K, còn fine-tune và inference hỗ trợ tới 1M token, tức 1,048,576 token.
Bên trong là 43 Transformer layers gồm 1 dense FFN và 42 MoE, hidden size 4096, 64 attention heads, vocab 201,216 theo BPE khoảng 200K. Còn số thì được tách token từ phải sang trái theo nhóm tối đa 3 chữ số, ví dụ 1,234,567 tách thành 1 234 567. Tổng tham số gồm cả embedding và output head, tham số active tính output head nhưng không tính embedding lookup, và cả hai con số 280B và 14B đều chưa tính thêm 0.36B tham số ECHO.
Base model khác chatbot ở những điểm nào
Blog chính thức viết rất rõ, weights này là checkpoint cuối pre-training, trước mọi mid-training và post-training, và có thể dùng làm điểm khởi đầu chung cho domain adaptation, instruction tuning và nghiên cứu RL. Nói cách khác, Baidu đưa cho anh em một cục phôi thô chứ chưa đưa một con chatbot hoàn chỉnh, vì model này không có chat alignment, không có assistant behaviour, không có refusal policy, không có tool-use format và cũng không có chat template, nên anh em serve nó qua completions API chứ không phải chat/completions. AlphaSignal cũng ghi đúng ý này khi nhận xét model không có sẵn hành vi trợ lý.
Ai là người được hưởng lợi thật từ một checkpoint thô
Artiverse và AlphaSignal thì nhìn giá trị thật của release này ở chỗ đây là một research baseline sạch, một checkpoint chưa bị instruction tuning làm nhiễu, để team nghiên cứu đo được tác dụng của từng giai đoạn post-training từ cùng một điểm xuất phát, không phải gỡ bỏ lớp instruction tuning có sẵn rồi mới đo lại từ đầu, và hãng cũng nói rõ đây chỉ là điểm khởi đầu, bản post-trained ERNIE 5.5 Flash sẽ theo sau nhưng chưa có ngày ra mắt. Kỳ vọng “tải về dùng ngay” thì release này không đáp ứng được, và đó cũng là lý do The Decoder mỉa nhẹ rằng Baidu vẫn còn làm AI đấy, nhưng phần việc khó nhất vẫn là của bạn.
MMLU 93.3 đẹp thật đấy, nhưng bảng so sánh này đang so với bản cũ
Điểm số chỉ có nghĩa khi biết ai đo, đo bằng gì và đo với ai, và toàn bộ con số dưới đây đều do Baidu tự đo bằng cùng một harness, cùng prompts, cùng few-shot và cùng LLM judge cho cả 4 model, chưa có bên thứ ba nào tái hiện độc lập tính tới 6/11/2026, theo AlphaSignal và SynthePulse.
Bảng điểm 30 benchmark, thắng ở đâu và thua ở đâu
Bảng chính thức đặt ERNIE cạnh ba base model cùng cỡ, DeepSeek-V4-Flash-Base 284B với 13B active, Hy3-preview-Base 295B với 21B active và MiMo-V2.5-Base 310B với 15B active, và đếm tay từ bảng đó thì ERNIE đứng đầu 24 trên 30 benchmark. Điểm headline MMLU 5-shot EM đạt 93.3 so với DeepSeek 89.4, Hy3 87.5 và MiMo 87.6 (Baidu tự đo, chưa kiểm chứng độc lập), còn MMLU-Redux 94.1, MMLU-Pro 78.4 và CMMLU 90.0 thì cũng dẫn khá xa (Baidu tự đo, chưa kiểm chứng độc lập). Khoảng cách lớn nhất từng hàng so với đối thủ mạnh nhất là MMLU-Pro hơn 9.2 điểm và LiveCodeBench hơn 6.6 điểm theo AlphaSignal.
Nhóm code là nơi ERNIE dẫn rộng nhất, với HumanEval+ 82.3 so với DeepSeek 69.5, MBPP+ 81.5 và LiveCodeBench 40.1 (Baidu tự đo, chưa kiểm chứng độc lập). Nhưng 6 lần thua thì cũng phải kể đủ, cụ thể là ChineseSimpleQA 73.0 thua DeepSeek 75.3, BBH-CoT 89.2 thua Hy3 90.0, INCLUDE-lite 79.5 thua DeepSeek 79.8, FullStackBench 54.6 thua Hy3 56.7, HELMET-Rerank 56.2 thua DeepSeek 60.0 và InfiniteBench 46.5 thua DeepSeek 48.0 (tất cả Baidu tự đo, chưa kiểm chứng độc lập), và 6 lần thua này tập trung ở factual QA tiếng Trung, ranking, long-context cực dài và FullStackBench.
Lưu ý: toàn bộ điểm trong bảng dưới đây là Baidu tự đo, chưa kiểm chứng độc lập.
| Benchmark | ERNIE 5.5 Flash Base | DeepSeek-V4-Flash-Base | Hy3-preview-Base | MiMo-V2.5-Base |
|---|---|---|---|---|
| Exam | ||||
| MMLU 5-shot EM | 93.3 | 89.4 | 87.5 | 87.6 |
| MMLU-Redux 5-shot | 94.1 | 90.9 | 88.7 | 89.4 |
| MMLU-Pro 5-shot | 78.4 | 69.2 | 66.9 | 65.7 |
| CMMLU 5-shot | 90.0 | 89.7 | 89.3 | 87.7 |
| Knowledge | ||||
| SimpleQA 10-shot | 34.1 | 25.9 | 20.8 | |
| ChineseSimpleQA 10-shot | 73.0 | 75.3 | 73.2 | 68.8 |
| PreciseWikiQA 10-shot | 59.3 | 52.0 | 50.3 | 46.0 |
| HotpotQA 10-shot | 57.3 | 51.8 | 50.9 | 50.1 |
| PopQA 10-shot | 52.2 | 48.7 | 49.3 | 45.7 |
| STEM | ||||
| GPQA 5-shot | 60.2 | 55.9 | 50.2 | 51.4 |
| MGSM 8-shot CoT | 87.0 | 84.6 | 76.9 | 83.8 |
| MathBench-CN 5-shot | 80.8 | 78.0 | 75.3 | 65.6 |
| Reasoning | ||||
| BBH direct 3-shot | 77.1 | 69.0 | 67.5 | 68.0 |
| BBH CoT 3-shot | 89.2 | 87.5 | 90.0 | 89.8 |
| WinoGrande 5-shot | 87.8 | 84.9 | 82.4 | 85.2 |
| PIQA 5-shot | 96.0 | 95.0 | 95.2 | 93.6 |
| Multilingual | ||||
| MMMLU-lite 5-shot | 81.0 | 78.5 | 76.1 | 72.2 |
| INCLUDE-lite 5-shot | 79.5 | 79.8 | 77.7 | 74.5 |
| MultiLoKo 5-shot | 43.3 | 42.8 | 39.5 | 36.3 |
| Code | ||||
| HumanEval+ 1-shot | 82.3 | 69.5 | 78.0 | 74.4 |
| MBPP+ 0-shot | 81.5 | 67.2 | 78.3 | 74.3 |
| LiveCodeBench 1-shot | 40.1 | 31.9 | 33.5 | 32.4 |
| FullStackBench 1-shot | 54.6 | 43.3 | 56.7 | 54.1 |
| RepoBench 0-shot EM | 50.3 | 49.1 | 49.1 | 48.9 |
| Long Context | ||||
| HELMET-RAG 2-shot | 71.5 | 68.9 | 67.2 | 69.0 |
| HELMET-Rerank 0-shot | 56.2 | 60.0 | 55.7 | 56.6 |
| HELMET-ICL many-shot | 85.9 | 83.8 | 83.0 | 80.2 |
| RepoQA 0-shot | 91.7 | 81.0 | 91.3 | 56.5 |
| LongBench-v2 0-shot | 48.7 | 44.5 | 39.8 | 44.6 |
| InfiniteBench 0-shot | 46.5 | 48.0 | 33.0 | 46.7 |
Ghi chú: toàn bộ điểm trong bảng là Baidu tự đo, chưa kiểm chứng độc lập, số in đậm là cao nhất từng hàng, và 6 lần thua của ERNIE là ChineseSimpleQA, BBH-CoT, INCLUDE-lite, FullStackBench, HELMET-Rerank và InfiniteBench.
Vì sao cộng đồng chê bảng so sánh là “so với bản cũ”
Trong blog chính thức, ba đối thủ trong bảng được mô tả là những base model mã nguồn mở mới nhất cùng cỡ tại thời điểm release, nhưng thực tế thì cả ba bản mới hơn đều đã ra trước ngày 5/11/2026, cụ thể là DeepSeek-V4.1-Flash-1017 ra ngày 17/10/2026 với 552B MoE và weights MIT, trong khi V4 Flash mà Baidu đem so thì đã retired từ 10/9/2026. Hy4 của Tencent ra ngày 4/11/2026 với weights đã hứa, còn MiMo-V2.6-Flash của Xiaomi ra ngày 22/9/2026 với 309B tổng và 15B active dưới MIT. Điểm này đã được một số người dùng X chỉ ra chỉ vài giờ sau release, theo ghi nhận của SynthePulse và Machine Heart. Cần làm rõ, đây là nghi ngờ về đối tượng so sánh chứ chưa phải bằng chứng ERNIE yếu hơn, vì chưa có số đo nào đặt ERNIE cạnh ba bản mới này.
Mọi suy luận kiểu “so với bản mới thì kết quả sẽ khác” chỉ là suy luận, không phải số liệu hiện có. SynthePulse cũng kết đúng ý này, điều xác nhận được bây giờ là “cái gì đã được mở”, chứ chưa phải “mạnh hơn bao nhiêu”.
Trên Hacker News và Reddit thì mình chưa thấy thread thảo luận riêng nào về ERNIE 5.5 tính tới 6/11/2026, chỉ có một thread cũ từ tháng 6/2025 về ERNIE 4.5.
Đọc bảng điểm như người thực chiến, tin được bao nhiêu
Giới phân tích độc lập thì nhìn bảng này thận trọng hơn headline rất nhiều, vì AlphaSignal lưu ý điểm số có thể đổi theo prompting, sampling, tokenization, context settings và version của harness, còn Unite.AI thì nhận xét so sánh của Baidu phụ thuộc từng task chứ không phải thắng sạch. ERNIE dẫn MMLU và HumanEval+ thì Hy3 lại dẫn FullStackBench, còn DeepSeek dẫn InfiniteBench (tất cả Baidu tự đo, chưa kiểm chứng độc lập). AlphaSignal cũng lưu ý báo cáo của Baidu không tách được đóng góp của dữ liệu pre-training khỏi kiến trúc, scale, tokenizer và phần còn lại của training mixture. Nhìn từ phía dữ liệu thì câu chuyện này lại khớp nhau khá đẹp. Corpus pre-training của Baidu nghiêng hẳn về code quy mô repo, từ commits, issues, PRs và code reviews tới những bản sửa đã qua CI kiểm chứng, cộng thêm dữ liệu long-context. Và chính nhóm code là nơi ERNIE dẫn rộng nhất, với HumanEval+ 82.3 so với DeepSeek 69.5 (Baidu tự đo, chưa kiểm chứng độc lập).
Cảnh báo nhỏ cho anh em, đừng để benchmark làm mờ mắt. Điểm số hiện tại chỉ đủ để nói ERNIE là một base mạnh trong nhóm so sánh cũ mà Baidu chọn, còn để nói “vượt DeepSeek” ở thời điểm hiện tại thì dữ liệu chưa đủ.
Việt Nam không bị loại khỏi giấy phép, nhưng ngưỡng 50 triệu USD và lệnh cấm distill vẫn áp dụng
Mình tạm chưa bàn đến benchmark ở đây vội, cái làm mình chú ý là hình như nhà cung cấp đang ẩn đi một số vấn đề ở giấy phép, và đây mới là phần quyết định anh em có được dùng model này vào việc thật hay không, vì Baidu lần này siết lại thay vì nới ra so với ERNIE 4.5 ngày 30/6/2025, khi đó 10 variants từ 0.3B tới 424B được mở dưới Apache 2.0, còn ERNIE 5.5 Flash Base thì đi kèm một custom license v1.0 ngày 5/11/2026, bản quyền thuộc Baidu 2026, luật áp dụng và tòa độc quyền đặt ở Hong Kong SAR, nên anh em đọc license trước, đừng đọc sau.
Ai dùng được, ai không, và vị trí của Việt Nam
Điều đầu tiên phải đọc là Territory, tức phạm vi lãnh thổ được cấp phép, vì license này cho phép dùng trên toàn thế giới trừ EU, UK và Hàn Quốc, theo §1.11, và mọi hành vi use, modify hay distribute ngoài Territory đều không được cấp phép theo §5.3, nên team nào đặt ở EU, UK hay Hàn Quốc thì coi như đứng ngoài ngay từ cửa, còn tin vui cho anh em Việt Nam là Việt Nam KHÔNG nằm trong vùng cấm.
Trong Territory, Baidu cấp quyền non-exclusive và non-transferable, gồm use, run, reproduce, modify, continued training, fine-tuning, tạo Derivative Models và phân phối cho bên thứ ba, theo §2 và §3, nhưng quyền này đi kèm Exhibit A là Acceptable Use Policy sửa lần cuối ngày 6/11/2026 với 20 điều cấm, từ dùng ngoài Territory, disinformation bầu cử, fake engagement, malware, doxxing, mạo danh tới quyết định high-stakes tự động và mục đích quân sự.
Ngưỡng 50 triệu USD hoạt động ra sao, và “Powered by ERNIE” là bắt buộc
Phần này anh em nên đọc như đọc hóa đơn, vì nó chia ra ba nấc rất rõ. Nấc đầu là Non-Commercial Use thì miễn phí và không cần notice theo §4.1. Nấc hai là Commercial Use từ 50 triệu USD doanh thu liên quan trở xuống trong một năm, tính theo 12 tháng liên tiếp trước thời điểm đánh giá và đánh giá liên tục. Nấc này vẫn miễn phí license charge nhưng bắt buộc hai việc.
Một là hiển thị đúng chữ “Powered by ERNIE” ở vị trí dễ thấy, trên UI, website, trang about hay docs, còn nếu là API hay backend thì ghi trong dev docs hoặc API docs. Hai là gửi one-time use notice tới [email protected] trước lần dùng thương mại đầu tiên, gồm tên operator, tên và version model, sản phẩm hay dịch vụ liên quan cùng mục đích, và contact hợp lệ. Gửi xong là được dùng ngay, không cần chờ Baidu trả lời. Lưu ý là đúng 50 triệu USD thì vẫn thuộc nấc này theo §4.2.
Nấc ba là Commercial Use trên 50 triệu USD thì phải có written authorization riêng của Baidu TRƯỚC khi bắt đầu, hoặc trước khi vượt ngưỡng nếu doanh thu tăng trong lúc đang dùng. Thiếu authorization thì phải suspend phần dùng vượt ngưỡng, phí thì do thỏa thuận riêng, và Baidu không truy thu cho phần dùng hợp pháp trước đó, theo §4.3.
Còn một điều khoản nữa ở §4.5 mà team nào làm thương mại nên biết trước. Baidu được kiểm tra tối đa 1 lần mỗi năm cho mỗi operator từ 50 triệu USD trở lên, trừ khi có căn cứ nghi ngờ vi phạm nghiêm trọng. Việc kiểm tra gồm một compliance statement cùng thông tin hợp lý mà operator cung cấp, toàn bộ được giữ bảo mật, và tài liệu sẽ bị hủy sau khi verification xong hoặc sau 12 tháng. Nên team nào định đưa model này vào sản phẩm thương mại thì đọc trước kẻo mất công tích hợp xong lại vướng ở đúng chỗ này.
Lệnh cấm distill và điều khoản chấm dứt, cái bẫy ít người đọc
Cái bẫy nằm ở §5.5, điều khoản nằm ở phần sau của licence mà ít người đọc tới, nhưng nó cấm dùng Licensed Materials, Derivative Models hay outputs để cải thiện bất kỳ hệ thống AI hay ML nào khác ngoài chính model này hoặc Derivative Models của nó, tức là cấm distillation sang một model không liên quan. Định nghĩa Derivative Model ở §1.5(b) còn gồm cả distillation, knowledge transfer và training on synthetic data, nên anh em đừng có ý định lấy outputs của ERNIE để dạy cho một model khác rồi đem bán, vì đó là vi phạm license ngay cả khi anh em dùng model này đúng Territory và đúng ngưỡng doanh thu.
Thêm hai điều khoản chấm dứt mà anh em nên biết, theo §6.6 thì kiện IP chống lại Licensor sẽ khiến license tự động chấm dứt, còn §7 thì ghi rõ model được cung cấp “AS IS”, không bảo hành, không cam kết hosted inference, compute, training, support hay future versions. RuntimeWire nhận xét quyết định dùng model này là quyết định pháp lý và vận hành chứ không chỉ là quyết định kỹ thuật.
Checklist giấy phép nhanh cho anh em Việt Nam
- Việt Nam KHÔNG bị loại, Territory chỉ trừ EU, UK và Hàn Quốc
- Non-Commercial Use miễn phí, không cần notice
- Commercial Use từ 50 triệu USD trở xuống, miễn phí nhưng bắt buộc ghi “Powered by ERNIE” và gửi one-time use notice tới [email protected] trước lần dùng đầu tiên
- Commercial Use trên 50 triệu USD, cần written authorization trước, thiếu thì phải suspend phần vượt ngưỡng
- Cấm distill, knowledge transfer hay training on synthetic data sang model không liên quan (§5.5)
- Tuân thủ Exhibit A với 20 điều cấm, gồm disinformation bầu cử, fake engagement, doxxing, malware, mạo danh và quyết định high-stakes tự động
- Kiện IP chống lại Baidu thì license tự chấm dứt (§6.6), model cung cấp “AS IS”, không bảo hành (§7)
Tải về rồi dùng ngay được không, và muốn chạy thử thì cần máy cỡ nào
Tới đây anh em đã biết model này là gì và giấy phép cho phép tới đâu, giờ tới câu hỏi thực tế nhất, tải về xong có xài được ngay không, và nếu muốn vọc thì máy phải mạnh tới mức nào, và câu trả lời ngắn gọn là tải thì được ngay, còn xài thì chưa, vì mọi lệnh dưới đây đều lấy đúng từ Hugging Face và blog chính thức, mình chưa tự chạy thử trên máy thật.
Tải về và gọi thử bằng Transformers, SGLang, vLLM
Weights nằm ở hai repo Hugging Face, baidu/ERNIE-5.5-Flash-Base bản FP8 safetensors và baidu/ERNIE-5.5-Flash-Base-BF16 bản BF16 safetensors, kèm mirror trên ModelScope. Cách gọi thử nhanh nhất bằng Transformers là dùng AutoModelForCausalLM với lệnh chính thức như sau, và nhớ giữ add_special_tokens=True khi tokenize vì BOS token là bắt buộc, quên là model chạy sai ngay từ token đầu tiên.
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer

model = AutoModelForCausalLM.from_pretrained("baidu/ERNIE-5.5-Flash-Base-BF16", torch_dtype=torch.bfloat16, device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("baidu/ERNIE-5.5-Flash-Base-BF16")
prompt = "Hà Nội là thủ đô của"
inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=True)
outputs = model.generate(**inputs, max_new_tokens=64)
print(tokenizer.decode(outputs[0]))
Nếu anh em muốn serve model này như một API thì SGLang đã có sẵn Docker image lmsysorg/sglang:dev-ernie-55-flash, với lệnh serve chính thức như sau, chạy trên cổng 30000 và mặc định context 131,072 token.
sglang serve --model-path baidu/ERNIE-5.5-Flash-Base --tp 4 --attn-dp-size 4 --context-length 131072 --max-running-requests 1024 --port 30000
Còn vLLM thì hỗ trợ ngay từ ngày đầu ra mắt, với plugin baidu/vLLM-ERNIE và phiên bản vllm==0.32.0, lệnh serve chính thức như sau, cũng chạy trên cổng 30000 và dùng KV cache FP8.
vllm serve baidu/ERNIE-5.5-Flash-Base --kv-cache-dtype fp8 --enable-expert-parallel --data-parallel-size 4 --max-model-len 131072 --port 30000 --moe-backend humming
Cả SGLang và vLLM đều serve qua endpoint /v1/completions, chứ không phải /v1/chat/completions, và cả hai đều chấp nhận context tới 1,048,576 token nếu anh em cấu hình đủ bộ nhớ.
280GB hay 560GB, và con số 1M context có nghĩa gì
Toán phần cứng thì cứ tính thẳng như đọc hóa đơn, bản FP8 khoảng 280GB còn bản BF16 khoảng 560GB, đó mới chỉ là weights, chưa tính KV cache, activations và overhead, theo ước tính của AlphaSignal thì khớp với phép nhân 280B tham số nhân 1 tới 2 bytes, và model đã được verify chạy trên NVIDIA GB200 và H100, theo Baidu cùng vLLM. Nên đây là model datacentre, không phải model chạy local trên máy cá nhân.
Về con số 1M context, ví dụ vLLM mặc định cap ở 131,072 token, muốn mở lên 1M thì phải set --max-model-len tương ứng và chuẩn bị đủ bộ nhớ, và AlphaSignal cũng lưu ý rằng maximum accepted length chỉ nói serving hỗ trợ nhận tới đó, còn retrieval quality và effective recall trên toàn bộ window thì vẫn phụ thuộc workload. Tức là nhận 1M token vào không có nghĩa là nhớ hết 1M token nào cũng ngon, nên anh em nào định nhồi cả repo code dài vào rồi kỳ vọng model nhớ từng dòng thì nên test kỹ trước khi tin.
Muốn dùng thật thì phải huấn luyện thêm bằng fine-tune và Megatron Bridge
Muốn dùng thật thì anh em phải qua domain adaptation, instruction tuning hoặc RL từ checkpoint thô này, và một lối đi đã có sẵn là NVIDIA Megatron Bridge SFT recipe, gồm ba bước là data prep rồi training rồi export về HF format, với full-model recipe dùng 16 nodes nhân 4 GB300. NVIDIA validate recipe này trên Blackwell GB200 và GB300, còn các components thì hỗ trợ Hopper nhưng Hopper không được validate, nên anh em nào đang có dàn Hopper thì đừng mặc định là chạy ngon.
Bản post-trained ERNIE 5.5 Flash thì Baidu hứa sẽ ra sau nhưng chưa có ngày ra mắt, và trước khi chạy thì nhớ ba lỗi hay gặp nhất, một là quên BOS token, hai là quên cap context mặc định chỉ 131K, ba là thiếu bộ nhớ khi mở 1M.
Nén 128 token thành 1, MoE nhiều router và ECHO, kiến trúc này đánh cược vào hiệu quả
Phần cứng và giấy phép đã rõ, giờ mình quay lại câu hỏi khiến dân kỹ thuật thích thú nhất, Baidu đã đánh cược vào hiệu quả ở đâu trong kiến trúc, và cái cược đó phục vụ mục tiêu gì.
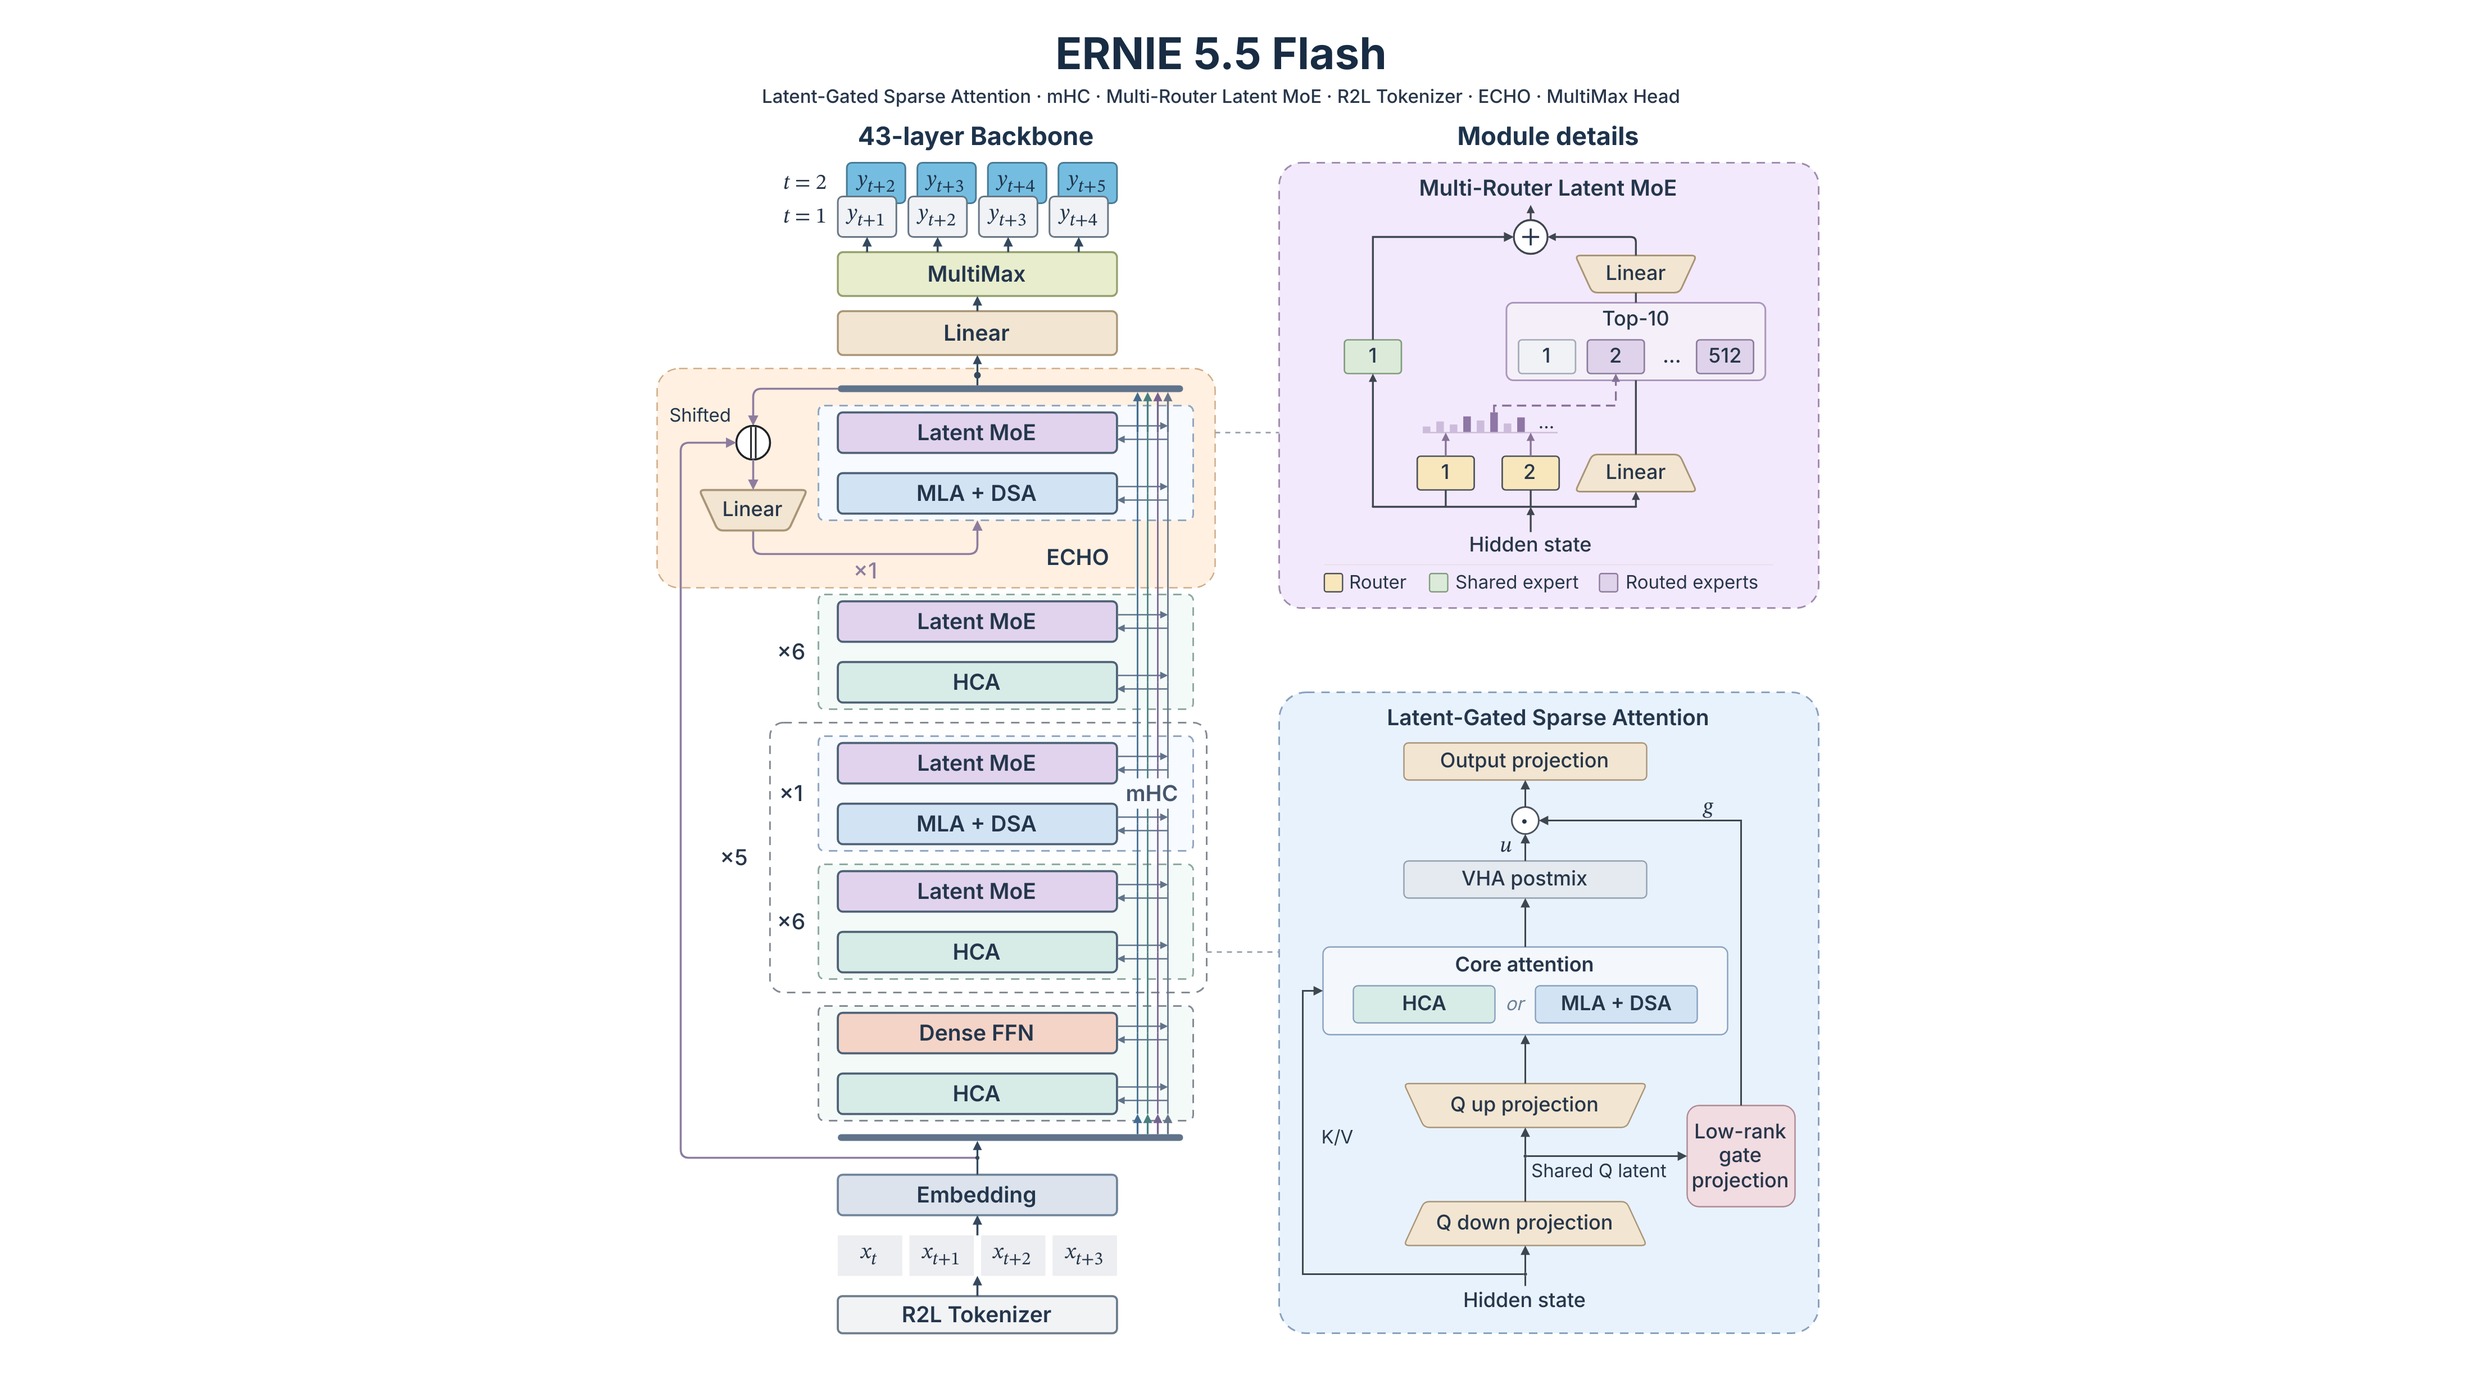
Sơ đồ trên là hình chính thức từ blog của Baidu, chữ trong hình hơi nhỏ nên anh em bấm vào để xem phóng to cho rõ từng khối.
37 lớp nén 128 token thành 1, 6 lớp giữ lại toàn cảnh
Trong 43 layers thì 37 lớp dùng Heavily Compressed Attention, gọi tắt là HCA, mỗi lớp nén mỗi 128 tokens thành một cached entry duy nhất, cộng thêm một short window giữ lại các token gần nhất chưa nén. 6 lớp còn lại dùng Multi-head Latent Attention, gọi tắt là MLA, kết hợp Dynamic Sparse Attention hay DSA, tức là cứ một lớp trong bảy thì giữ token-level access tới toàn bộ context. Theo blog chính thức, 6 lớp MLA-DSA này là đủ để giữ performance mạnh trên 6 long-context benchmarks (Baidu tự đo, chưa kiểm chứng độc lập).
Về kích thước head thì HCA dùng wide 512-dim heads còn MLA dùng narrower 256-dim heads cho cả query, key và value. DSA thì giữ per-query core-attention cost không đổi khi context tăng và khớp dense attention về pre-training loss. Ở cùng một KV-cache budget thì HCA kết hợp MLA vượt HCA kết hợp CSA trong so sánh pre-training của Baidu.
Mình để ý thêm một chi tiết nữa, mỗi attention layer còn có Low-Rank Gated Attention, với gate lấy từ low-rank query latent hẹp hơn hidden state 4 lần nên giảm tới 75% gate-projection weights. Virtual Head Attention hay VHA thì thêm một lớp lightweight low-rank mixing across heads với identity skip, được fused vào attention kernel lúc inference. Gom lại thì toàn bộ phần attention này kể chung một câu chuyện, nén thật mạnh ở phần lớn các lớp nhưng chừa lại vài lớp giữ toàn cảnh để model không bị mù ở context dài.
512 experts, top-10, và vì sao một router là chưa đủ
Mọi layer trừ layer đầu tiên đều dùng MoE, với 512 routed experts chọn top-10 mỗi token cộng thêm 1 shared expert mỗi MoE layer, dùng auxiliary-loss-free và bias-corrected load balancing. Điểm đặc biệt nằm ở latent experts: tokens được project từ 4096 chiều xuống không gian latent 2048 chiều, các experts với intermediate size 2048 chạy trong không gian đó rồi mới qua một shared up-projection trở lại 4096, nhờ vậy mà giảm khoảng một nửa dispatch và combine traffic cùng expert FLOPs so với full-width experts, còn thiết kế Stable LatentMoE thì thêm RMSNorm trước up-projection và dùng SiTU-GLU activations, mỗi routed expert thì có routing weight nhân với một learnable scalar riêng.
Mình thấy lý do hãng đưa ra nhiều router thay vì một router duy nhất nghe rất đời thường nếu ví với chuyện chia việc. Một router duy nhất thì điểm số nó chấm cho từng expert chỉ tương quan yếu với mức hữu ích thật của expert đó, nhất là ở middle và deeper layers, mà expert nào không được chọn thì không nhận gradient nên chọn sai lại càng sai thêm. Nhiều sigmoid routers khởi tạo độc lập thì điểm số tương quan tốt hơn hẳn với mức hữu ích thật của expert, trong khi số experts được kích hoạt, expert FLOPs và communication volume thì không đổi so với single router. Nên đây là một cú sửa thiết kế kiểu ít tốn kém mà trúng đúng chỗ đau.
ECHO, mHC, MultiMax và FlashMask-4, những mảnh còn lại của bức tranh hiệu quả
Mình thích nhất là ECHO, một ý tưởng gọn mà hay. Nó tái dùng chính final layer của backbone để dự đoán future tokens, với single-step ECHO trong pre-training, đồng thời kiêm luôn draft model cho speculative decoding với acceptance rate cao hơn auxiliary MTP module. Tham số ECHO thêm 0.36B này không tính vào con số 280B hay 14B mà anh em vẫn thấy trên headline.
Manifold-Constrained Hyper-Connections hay mHC với expansion rate 4 thì thay residual connection chuẩn bằng 4 parallel residual streams đi qua một constrained mixing matrix. MultiMax output head thì dùng learnable piecewise temperature, được rescaled element-wise trong chunked Triton-fused cross-entropy kernel, và theo Baidu thì nó giảm pre-training loss đáng kể với overhead không đáng kể.
Hạ tầng huấn luyện cũng được thiết kế cùng nhịp với kiến trúc, với Distributed Muon optimizer dùng communication-efficient updates, khi dense và MoE sync được fused vào một collective trên cùng-rank GPUs, cùng memory-balanced sharding để optimizer states trải đều trên các nodes. FlashMask-4 attention kernel xây trên CuTe-DSL cho SM90 và SM100, hỗ trợ head dims tới qk 576 và v 512, vượt FlashAttention-4, với compact O(N) column-wise mask. Trên SM100 thì nhanh hơn FlashAttention-4 MaskMod tới 175% forward và tới 74% backward theo đo của Baidu (Baidu tự đo, chưa kiểm chứng độc lập). Gom lại thì từng mảnh đều phục vụ cùng một mục tiêu, chạy một model 280B mà tốn ít bộ nhớ và ít thời gian hơn.
16 tháng giữ kín ERNIE 5.0 và 5.1, rồi Kimi mở weights chỉ một ngày trước
Một release chỉ thật sự có nghĩa khi đặt cạnh những gì hãng đã không mở trước đó và những gì đối thủ vừa mở ngay trước đó, và ở cả hai phía Baidu đều đang kể một câu chuyện khác với headline “comeback” mà nhiều bài đang dùng.
16 tháng im lặng, ERNIE 4.5 mở còn ERNIE 5.0 và 5.1 giữ kín
Lần mở weights 100B trở lên gần nhất của Baidu là ERNIE 4.5 ngày 30/6/2025, với 10 variants từ 0.3B tới 424B dưới Apache 2.0, rồi ERNIE 5.0 ra mắt tháng 1/2026 với 2.4T tham số unified multimodal và activation dưới 3% nhưng weights không mở. Tiếp theo ERNIE 5.1 ra ngày 8 tới 9/5/2026, được nén từ ERNIE 5.0 còn khoảng 1/3 tổng params và khoảng 1/2 active params, với khoảng 6% pre-training cost của model tương đương, LMArena text rank khoảng 27 và search rank 4 tới 5, nhưng weights cũng không mở. Tính từ tháng 6/2025 tới tháng 11/2026 là khoảng 16 tháng Baidu không mở weights ở tier lớn.
Pattern này nhìn qua thì giống ERNIE 4.5, tức là mở tier trước thay vì mở flagship, nhưng lần này license siết lại thay vì nới ra, theo nhận xét của Unite.AI và RuntimeWire, nên đừng đọc lần mở này như một cú “comeback” hào nhoáng, vì Baidu đang mở một tier hiệu quả để cộng đồng build tiếp, trong khi flagship vẫn nằm trong tay họ.
Kimi K3.1 Pro một ngày trước, cùng tuần nhưng khác loại release
Chỉ một ngày trước Baidu, vào 4/11/2026 lúc 16:00 UTC, Moonshot AI đã đưa weights Kimi K3.1 Pro lên Hugging Face, với 2.8T tổng, 104B activated, 93 layers, 896 experts chọn 16 mỗi token cộng 2 shared, weights MXFP4, 96 shards khoảng 1,561GB, context 1,048,576, hỗ trợ vLLM, SGLang và TokenSpeed, API kimi-k3.1-pro, và custom Kimi K3.1-Pro License với điều khoản MaaS trên 20 triệu USD doanh thu 12 tháng thì cần thỏa thuận riêng.
Góc nhìn hào hứng của Enchilada thì cho rằng trong 24 giờ các lab Trung Quốc đã ship cả một flagship K3.1 Pro đã mở lẫn một base brick để người khác build tiếp. Nhưng Kimi ship một flagship đã post-train còn Baidu ship một base thô, hai release khác loại nhau hoàn toàn, nên đừng gộp thành “hai ông lớn cùng mở flagship” cho gọn câu.
Hy4 của Tencent cũng ra ngày 4/11/2026 với weights đã hứa, trong khi Hy3 là Apache 2.0, lại là một trong ba bản mới mà Baidu không đem ra so sánh. Tuần này đúng là một tuần sôi động của open weights, nhưng mỗi hãng đang chơi một nước cờ khác nhau.
Ai nên dùng ERNIE 5.5 Flash Base, ai nên chờ bản post-trained
Nhóm nên dùng là team nghiên cứu và team có datacentre hardware cùng năng lực post-training, muốn một checkpoint sạch 280B, 14B active, 33.5T tokens để làm domain adaptation, instruction tuning hay RL research, đã đọc kỹ license, vì Việt Nam không bị loại nhưng ngưỡng 50 triệu USD và lệnh cấm distill vẫn áp dụng.
Nhóm nên thử là dev muốn vọc SGLang hay vLLM trên GB200 hoặc H100, chấp nhận FP8 khoảng 280GB hoặc BF16 khoảng 560GB và cap context mặc định 131K, để học kiến trúc, chưa kỳ vọng một chatbot hoàn chỉnh.
Nhóm nên bỏ qua hoặc chờ là người cần chatbot dùng ngay, người chỉ có máy cá nhân, team ở EU, UK hay Hàn Quốc, công ty trên 50 triệu USD doanh thu liên quan chưa có written authorization, và người đang chờ bản post-trained, vì bản đó chưa có ngày ra mắt.
Baidu mở weights, nhưng phần việc khó nhất vẫn là của bạn, và điểm MMLU 93.3 cùng 24 trên 30 lần thắng là Baidu tự đo, chưa kiểm chứng độc lập, nên anh em nào đã thử fine-tune hoặc chạy thử thì chia sẻ trải nghiệm thật ở phần bình luận.
Nguồn tham khảo
- Blog chính thức Baidu ERNIE 5.5 Flash Base
- Hugging Face baidu/ERNIE-5.5-Flash-Base
- LICENSE ERNIE 5.5 Flash Base v1.0
- Unite.AI
- The Decoder
- AlphaSignal
- ChainCatcher ERNIE 4.5
- SynthePulse
- Artiverse
- RuntimeWire
- Binance Square
- KuCoin News
- KuCoin News 16 tháng
- FourWeekMBA Kimi K3.1 Pro
- MLLM Kimi K3.1 Pro
- BenchLM DeepSeek
- Respan best open-source LLMs
- MBSearch guide to Chinese AI models
- Julien Cloud OpenCode models
- AIChatDaily ERNIE Bot
- HowAIWorks ERNIE models
- FelloAI ERNIE 5.1
- Enchilada AI News
- Hacker News ERNIE 4.5 thread

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Ram Altman gửi email báo RAM nhàn rỗi cho Sam Altman mỗi ngày
- Board Nvidia mở điều tra độc lập về Jensen Huang ngày 08/11, CEO thừa nhận ngoại tình nhưng cáo buộc gián điệp vẫn chưa được chứng minh
- Goldman Sachs thu hồi Claude Code khỏi tay banker và trader, chỉ để lại cho 12.000 kỹ sư
Bình luận & Trao đổi