📑 Mục lục chi tiết bài viết (18 mục)
- Chuyện gì xảy ra, và ai bị ảnh hưởng
- Tóm tắt trong 3 câu, một model, 155 phản hồi và đã sửa ngay 9/9
- Ai nằm trong phạm vi, và ai không nằm trong phạm vi
- Vì sao chỉ prompt rất dài mới dính
- Hai con số đứng cạnh nhau, context 1,048,576 token và pool prefill 681,280 token
- Lỗi một token placeholder, request bị từ chối vẫn được chuyển tiếp
- Vì sao session nhiều turn khác prompt đơn, và vì sao test trước launch không bắt được
- Cloudflare xử lý ra sao, theo timeline nào
- Timeline ngày 9/9, từ báo cáo tới khôi phục trong cùng một ngày
- Hai lớp sửa ngày 9/9, và vì sao chỉ tăng pool chưa đủ
- Người dùng thường cần làm gì, và người tự host SGLang phải làm gì
- Người dùng thường gần như chắc chắn không cần làm gì
- Người tự host SGLang, nâng cấp lên v0.5.22 rồi kiểm tra pool đối chiếu context
- Cộng đồng nói gì, và điều gì vẫn chưa rõ
- Tiếng nói chỉ trích, biết mismatch trước launch mới gay gắt nhất
- Tiếng nói thông cảm có điều kiện, prefill pool khác với tổng session
- Điều gì vẫn chưa rõ, và vì sao bài này không đoán
- Bài học đáng giữ lại từ 155 phản hồi
Cloudflare vừa công bố model @cf/zai-org/glm-5.3 trên Workers AI đã trả dữ liệu khách hàng khác trong 155 phản hồi, nhưng anh em đừng vội hoảng, vì vụ này chỉ chạm tới những prompt đơn cực dài, model đã sửa ngay ngày 9/9/2026, còn ngày 26/10 chỉ là lúc mọi bên cùng công khai sau khi sửa, nên đọc tới cuối để biết mình có nằm trong phạm vi hẹp đó không rồi mới lo tiếp cũng chưa muộn.
Thông tin nhanh: @cf/zai-org/glm-5.3, 155 phản hồi, 27/8 tới 9/9/2026, chỉ prompt đơn trên 681,280 token, khôi phục 19:40 ngày 9/9/2026, công bố 26/10/2026.
Chuyện gì xảy ra, và ai bị ảnh hưởng
Trước hết, cứ nắm chắc hai chuyện này đã, chuyện gì xảy ra và mình có nằm trong số đó không.
Tóm tắt trong 3 câu, một model, 155 phản hồi và đã sửa ngay 9/9
Cloudflare công bố ngày 26/10/2026 rằng @cf/zai-org/glm-5.3 trên Workers AI, model của Z.ai, đã trả dữ liệu khách hàng khác trong 155 phản hồi từ 27/8 tới 9/9/2026. Mọi phản hồi bị ảnh hưởng đều tới từ prompt đơn trên 681,280 token, dữ liệu rò rỉ từ request khách hàng khác tới cùng model trước đó. Model sửa và khôi phục ngay 9/9/2026, ngày 26/10 chỉ là công bố phối hợp sau khi sửa.
Ai nằm trong phạm vi, và ai không nằm trong phạm vi
Chỉ người gửi prompt đơn trên 681,280 token tới @cf/zai-org/glm-5.3 trong cửa sổ trên mới có thể nhận phản hồi bị ảnh hưởng, và đơn vị đếm là 155 phản hồi vì Cloudflare không công bố số khách hàng riêng biệt. Mọi model Workers AI khác đều ngoài phạm vi vì deployment disaggregated khác có KV pool lớn hơn context length ở prefill và decode, prompt thường hay session nhiều turn không tự động dính, và đây là rò rỉ xuyên request trong cùng model.
Vì sao chỉ prompt rất dài mới dính
Con số 681,280 token nghe khó hình dung, nhưng hai con số và một lỗi là đủ hiểu.
Hai con số đứng cạnh nhau, context 1,048,576 token và pool prefill 681,280 token
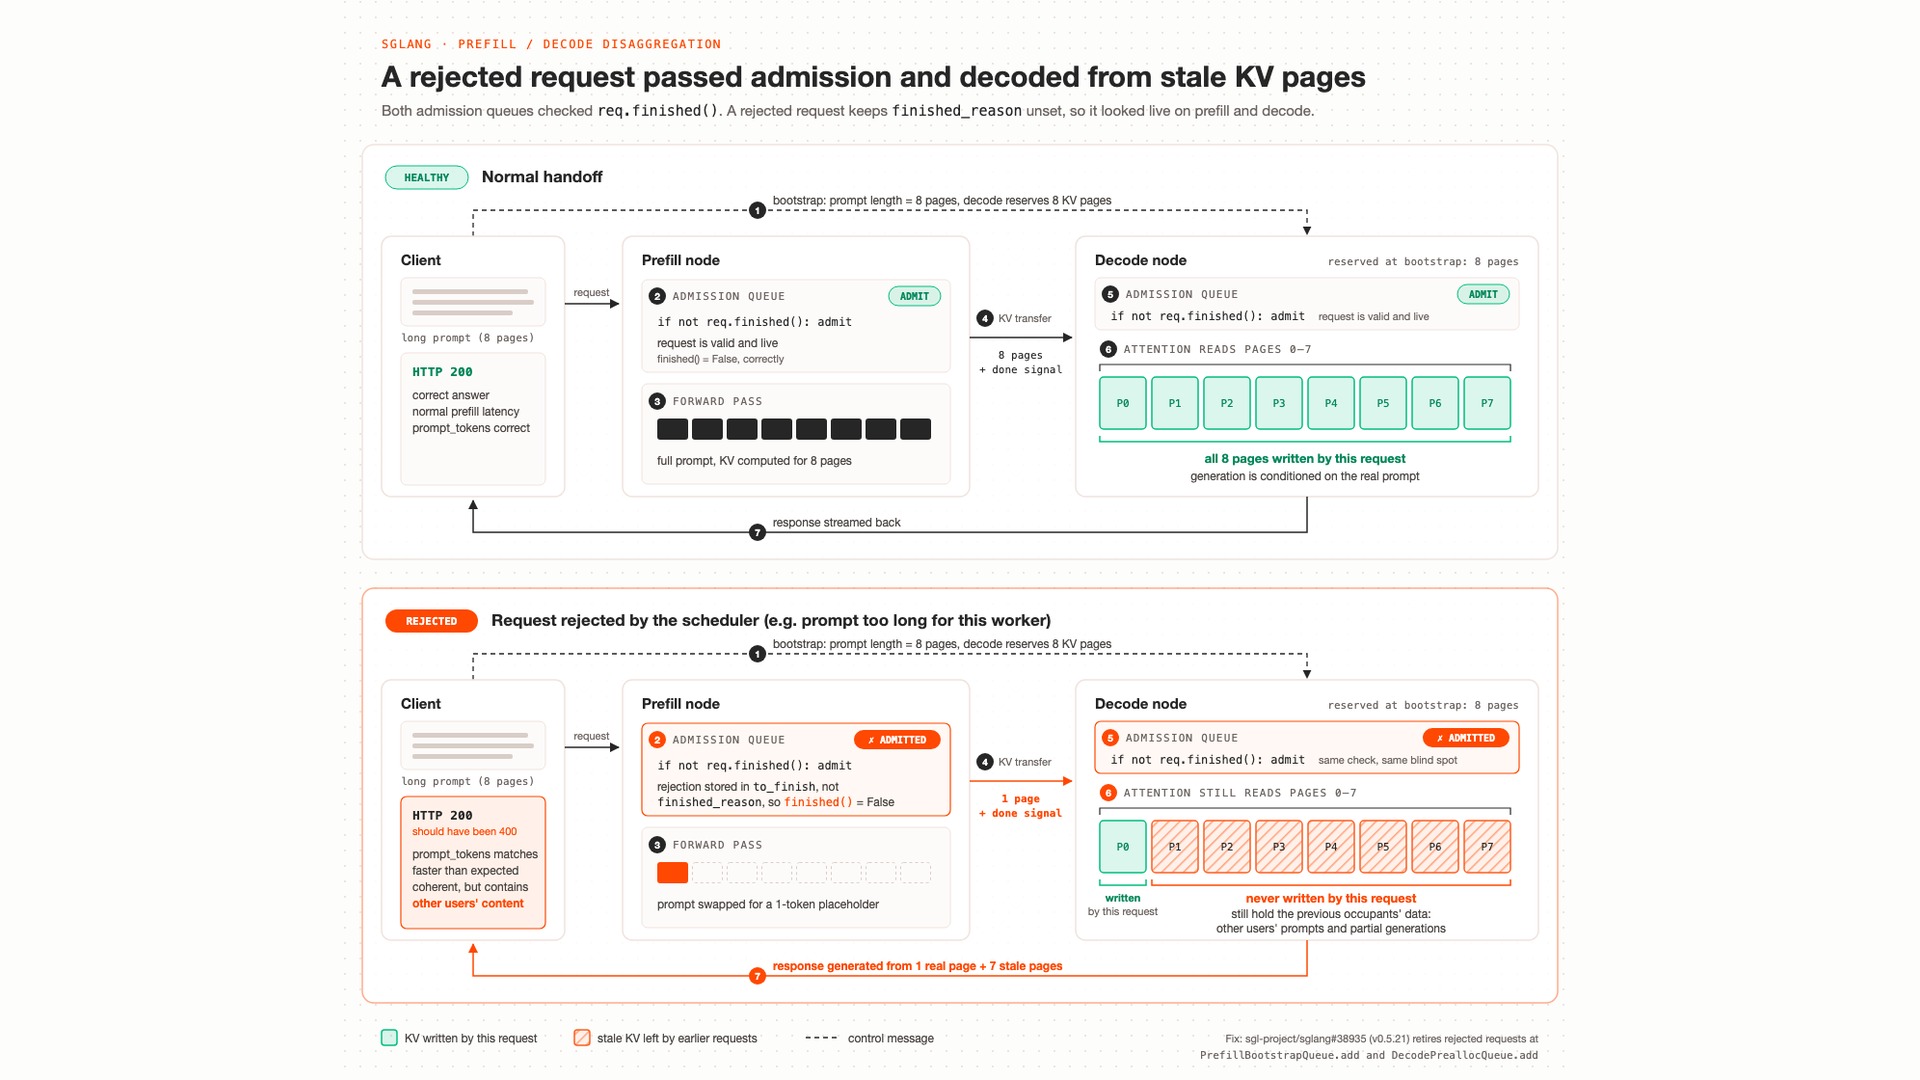
Context window 1,048,576 token nhưng KV pool prefill chỉ 681,280 token, chênh nhau 367,296 token, con số này mình tự tính từ phép trừ. KV cache là kho page GPU cố định mà request sau chỉ ghi đè lên page request trước, nên engine phải theo dõi page nào của ai, và pool size tính lúc khởi động từ bộ nhớ còn lại, khác với giá trị cấu hình như context length, nên Cloudflare tự nhận “Nothing forces the two to agree, and it is our job to check that they do”.
Lỗi một token placeholder, request bị từ chối vẫn được chuyển tiếp
Router báo decode giữ trước 8 page, hàng đợi admission prefill chấp nhận request mà finished() còn trả False, request bị từ chối lưu trạng thái ở to_finish chứ không phải finished_reason nên bị hiểu là chưa xong. Prefill chạy forward pass trên placeholder một token, chỉ gửi một page KV sang decode và báo chuyển xong. Decode mắc cùng lỗi kiểm tra nên chấp nhận bàn giao, rồi sinh token khi đọc cả 8 page, chỉ page đầu là của request này, để client nhận HTTP 200 thay vì HTTP 400, prompt_tokens khớp prompt dài, câu trả lời mạch lạc và nhanh bất thường. Đây là đường rejection xác định ở chế độ disaggregated, còn trên single-node thì cùng đường này trả lỗi đúng.
Vì sao session nhiều turn khác prompt đơn, và vì sao test trước launch không bắt được
Giới hạn pool chỉ áp dụng cho prefill của một prompt đơn, không phải tổng session nhiều turn, và cách giải thích này của Hacker News chỉ phù hợp với cơ chế chính thức, chứ không phải bảo đảm chính thức. Cloudflare tự nhận về quyết định trước launch rằng “We were aware of this mismatch before launch. We expected the engine to return an error for any prompt it could not process, and our long-context tests returned successful responses, so we did not believe this to be an issue.”, và về lỗ hổng test rằng “This was one critical gap in our testing: we only validated HTTP response codes and engine performance at long contexts, without validating model output and coherence.”. Vì vậy test chỉ kiểm tra HTTP status và hiệu năng mới vượt qua đúng trên tín hiệu lỗi giả mạo, và issue SGLang #30233 ngày 6/7/2026 đã mô tả cùng đường này.
Cloudflare xử lý ra sao, theo timeline nào
Cái đáng xem là tốc độ xử lý ngày 9/9 và khoảng cách bảy tuần tới ngày công bố.
Timeline ngày 9/9, từ báo cáo tới khôi phục trong cùng một ngày
Giờ UTC, ngày 9/9 model về private 14:00, rõ root cause 14:35, xong cấu hình 14:52, rebuild kèm patch 19:04, khôi phục 19:40.
| Thời điểm | Diễn biến |
|---|---|
| 27/8/2026 | GLM 5.3 ra mắt, lỗi có sẵn |
| 8/9/2026 23:11 UTC | Báo cáo HackerOne từ Gadi Evron của Knostic |
| 9/9/2026 08:00 UTC | Cloudflare bắt đầu xác minh báo cáo HackerOne |
| 9/9/2026 13:22 UTC | Tuyên bố sự cố sau tái hiện 25 phút |
| 9/9/2026 19:40 UTC | Khôi phục về public |
| 26/10/2026 | Công bố phối hợp cùng nhà nghiên cứu, RadixArk |
Sau ngày 9/9, họp maintainer SGLang ngày 10/9, PR #38935 và PR #39500 merge 16/9, v0.5.21 ra 2/10, v0.5.22 ra 19/10.
Hai lớp sửa ngày 9/9, và vì sao chỉ tăng pool chưa đủ
Lớp cấu hình tăng pool lên khoảng 2.04 triệu token, gấp đôi context length, theo cấu hình GLM 5.2, để prompt hợp lệ luôn vừa pool, còn lớp engine kết thúc request bị từ chối tại hàng đợi admission với lỗi gốc trước bootstrap, cấp phát hay chuyển KV, để pool size không còn là phòng tuyến duy nhất. Cloudflare cảnh báo chỉ dựa vào pool size thì mong manh vì quantization, parallelism hay model version mới đều có thể làm pool thay đổi khó phát hiện.
Người dùng thường cần làm gì, và người tự host SGLang phải làm gì
Tới đây thì chia thẳng hai nhóm người đọc cho dễ theo dõi.
Người dùng thường gần như chắc chắn không cần làm gì
Chưa từng gửi prompt đơn trên 681,280 token tới @cf/zai-org/glm-5.3 trong cửa sổ trên thì không có bằng chứng công bố nào nói anh em bị ảnh hưởng, cách kiểm tra duy nhất có cơ sở là rà log request theo ba điều kiện, model, cửa sổ và kích thước prompt. Có gửi prompt dài trong cửa sổ thì anh em cũng không tự xác nhận được vì không có danh sách theo từng khách hàng, liên hệ support hay xoay credential đều là lời khuyên thận trọng của bên thứ ba, chứ không phải chỉ dẫn Cloudflare, nên đừng xoay mật khẩu hàng loạt. Cloudflare cho biết không tìm thấy bằng chứng về khai thác có chủ đích, các request còn lại phù hợp với cách dùng long-context bình thường, nhưng đây là kết quả điều tra, chứ không phải bảo đảm không ai thấy dữ liệu, vì người nhận 155 phản hồi đó đã nhận dữ liệu khách hàng khác.
Người tự host SGLang, nâng cấp lên v0.5.22 rồi kiểm tra pool đối chiếu context
Anh em chạy disaggregated thì nâng cấp lên v0.5.22 hoặc mới hơn, #36988 trong v0.5.20 retire aborted prefill trước khi kết quả tới decode, #38935 trong v0.5.21 reject at admission trước bootstrap, cấp phát hay chuyển KV, v0.5.21 ra 2/10/2026 có deferred release mặc định, v0.5.22 ra 19/10/2026 gồm #43719, #37077, #43562 và #41128, MORI cần build từ #37077 trở đi, còn #45973 ngày 22/10 ra sau v0.5.22 nên không nằm trong bản đó.
Sau nâng cấp, đo KV pool đối chiếu context length từ engine startup log mọi node sau mỗi thay đổi, nếu pool nhỏ hơn thì hạ context length cho vừa. Chạy deferred release trên cả hai role, giới hạn batch Mooncake, bật –disaggregation-enable-kv-checksum và –kv-canary ở nơi hỗ trợ rồi xác nhận từ log, vì hai cơ chế chưa bao phủ mọi kiến trúc, và theo dõi metric sglang:decode_deferred_kv_release_total{outcome}, hệ thống khỏe thì gần như mọi hold đều giải phóng qua drained. Deferred release cùng checksum chặn thêm lớp race xác suất khi request chết giữa chừng lúc chuyển, khác đường rejection gây ra 155 phản hồi này, và SGLang không backport fix line về nhánh cũ, cặp trộn cũ với mới có thể hỏng drain handshake, còn trên v0.5.19 hoặc v0.5.20 thì đặt SGLANG_DISAGGREGATION_DEFERRED_DECODE_KV_RELEASE=1 trên cả hai server.
Cộng đồng nói gì, và điều gì vẫn chưa rõ
Tới đây thì để cộng đồng lên tiếng, rồi nói thẳng chỗ chưa rõ.
Tiếng nói chỉ trích, biết mismatch trước launch mới gay gắt nhất
Ý kiến trên Hacker News, mình ghi rõ đây là ý kiến chứ không phải sự thật đã kiểm chứng, thì gay gắt nhất là quyết định launch, khi commenter trích câu Cloudflare về việc biết mismatch trước launch và xem đó như lời thừa nhận và so sánh với lỗi buffer overflow. Tiếng chỉ trích thứ hai cũng có cơ sở, commenter cho rằng test với prompt dài đã thấy rò rỉ nhưng hiểu nhầm là thành công, mình đồng tình với nội dung này vì Cloudflare tự nhận đây là lỗ hổng test, nhưng mình không trích con số phần trăm của commenter thành số liệu chính xác, và lập trường của bài giữ cả hai nguyên nhân song song, thay vì chọn một bên để đổ lỗi.
Tiếng nói thông cảm có điều kiện, prefill pool khác với tổng session
Cũng là ý kiến trên Hacker News, commenter giải thích đây nhiều khả năng chỉ là pool prefill GPU, session 1M token bình thường vẫn chạy được, còn commenter khác nói chỉ prefill đơn tới 681k token mới vượt giới hạn, tách biệt khỏi cache hit hay generation. Tranh luận phân bổ lỗi thì một bên nói đổ lỗi sang SGLang là sai chỗ, bên kia nói SGLang đúng là có lỗi, và lập trường của bài là cả hai đều đúng một nửa theo hồ sơ chính thức, lỗi thuộc về đường rejection của SGLang, cấu hình làm đường đó tới được thì thuộc về Cloudflare, và lý do Cloudflare tự nêu là họ kỳ vọng engine trả lỗi khi gặp prompt không xử lý được.
Điều gì vẫn chưa rõ, và vì sao bài này không đoán
Bốn điểm chưa rõ, số khách hàng riêng biệt không được công bố vì Cloudflare chỉ đếm phản hồi, việc thông báo riêng từng người không được nêu trong bài Cloudflare, nội dung chính xác của từng mảnh rò rỉ không được Cloudflare công bố, và bản viết của nhà nghiên cứu Gadi Evron vẫn được SGLang mô tả là sắp ra mắt nên chưa có để trích dẫn.
Bài học đáng giữ lại từ 155 phản hồi
Nhìn lại thì đây là trường hợp hẹp chỉ những prompt đơn cực dài mới chạm tới, đã sửa xong trong ngày, và bài học đáng nhớ nhất nằm ở cách test của Cloudflare.
Nhắc lại cho gọn, @cf/zai-org/glm-5.3 dính 155 phản hồi, chỉ với prompt đơn trên 681,280 token, từ 27/8 tới 9/9/2026, sửa xong 19:40 ngày 9/9/2026, công bố 26/10/2026, người dùng thường gần như không cần làm gì, người tự host nâng cấp lên v0.5.22 hoặc mới hơn và kiểm tra pool đối chiếu context từ log. Bốn điểm vẫn chưa rõ là số khách hàng riêng biệt, việc thông báo riêng từng người, nội dung chính xác của từng mảnh rò rỉ, và bản viết của nhà nghiên cứu Gadi Evron vẫn được mô tả là sắp ra mắt, nên bài này không đoán thêm ngoài những gì đã công bố. Bài học test thì đừng chỉ nhìn HTTP status và hiệu năng vì lỗi này giả mạo đúng tín hiệu đó, mà phải kiểm tra nội dung và tính mạch lạc của output, và nếu từng dùng GLM-5.3 với prompt dài trong cửa sổ này thì chia sẻ trải nghiệm thật ở phần bình luận.
Nguồn tham khảo
- Cloudflare Blog: https://blog.cloudflare.com/kv-cache-exposure-remediation/
- SGLang post: https://www.lmsys.org/blog/2026-10-26-cf-security/
- Hacker News thread: https://news.ycombinator.com/item?id=50252927
- Workers AI GLM-5.3: https://developers.cloudflare.com/workers-ai/models/glm-5.3/

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Ram Altman gửi email báo RAM nhàn rỗi cho Sam Altman mỗi ngày
- Board Nvidia mở điều tra độc lập về Jensen Huang ngày 08/11, CEO thừa nhận ngoại tình nhưng cáo buộc gián điệp vẫn chưa được chứng minh
- Goldman Sachs thu hồi Claude Code khỏi tay banker và trader, chỉ để lại cho 12.000 kỹ sư
i7qbkm