📑 Mục lục chi tiết bài viết (26 mục)
- MIT thực sự tuyên bố gì, và con số 48.1% đến từ thí nghiệm nào
- Tuyên bố trong abstract và bài blog ngày 2/11/2026
- 8 thí nghiệm trong một cái nhìn, và bảng phân loại của Honnibal
- Thí nghiệm sửa Qwen thực chất đã làm gì
- Honnibal và Goedecke thực sự phản đối điều gì
- Honnibal nói bài MIT gộp hai kỹ thuật dưới một cái tên
- Goedecke: đây là việc của người giỏi
- Điểm nào mỗi bên đúng, và điểm nào bài MIT tự nhận
- Vì sao 48.1% là sửa lỗi
- Chính tác giả MIT đã viết rõ, bản sửa chỉ gỡ vòng lặp
- Thí nghiệm đối chứng Gemma 3 270M
- Đọc con số 48.1% thế nào cho đúng
- Willison tái hiện được gì trên laptop, và phần nào vẫn chưa ai tái hiện
- Simon Willison chạy lại thí nghiệm đoán game bằng Qwen 3.8 27B
- Van der Hoef mở rộng lên 36 mạng, Astra vẫn nhất nhưng lỗi có quy luật
- Phần nào của câu chuyện vẫn chưa ai tái hiện được
- Checkpoint trên Hugging Face cho thấy gì, và giới hạn của việc kiểm chứng đó là gì
- Ahsen Khaliq chạy lại toàn bộ MATH-500 và ra 51.0%
- Giới hạn của việc kiểm chứng checkpoint
- Anh em tự kiểm tra trong 3 bước
- “Weight-space programming” thực ra là gì, và còn gì chưa có câu trả lời
- Weight-space programming, nói lại cho người dùng thực tế
- Schmidhuber và câu hỏi “ai làm trước”
- Bốn câu hỏi về Astra vẫn chưa có câu trả lời
- 48.1% là thật, và nó chứng minh ít hơn headline nói
- Nguồn tham khảo
Ngày 2/11/2026, blog MIT CSAIL công bố GPT-6 Astra sửa weights của Qwen3.5-0.8B, MATH-500 nhảy từ 7.9% lên 48.1% [tự báo cáo (MIT logs)], và ngay hôm sau phe phản biện do Matthew Honnibal dẫn đầu đã lên tiếng. Mình đã kể lại claim gốc trong bài viết trước rồi, giờ tới lượt xử án, con số thì thật, nhưng thứ nó chứng minh thì ít hơn headline nói rất nhiều.
Thông tin nhanh
– Bài gốc: blog MIT CSAIL ngày 2/11/2026, Rikiya Takehi, Jayden Teoh, Alex Zhang, Omar Khattab, “Sparks of Weight-Space Programming”, chưa peer review, chưa có arXiv (tính tới đầu 3/11) [tự báo cáo (MIT logs)].
– Con số headline: Qwen3.5-0.8B, MATH-500 từ 7.9% lên 48.1% ở 50 forward passes [tự báo cáo (MIT logs)]; checkpoint chạy lại cho 51.0% [chạy lại checkpoint (HF 51.0%)].
– Phản biện chính: Matthew Honnibal (3/11) gọi cách đóng gói là “massively misleading” [ý kiến]; Sean Goedecke (3/11) nói một ML researcher giỏi đều làm được các task này; Simon Willison (3/11) tái hiện thí nghiệm đọc weights bằng Qwen 3.8 27B trên laptop, đúng 3/4 game [tự báo cáo 1 lần thử (Willison)].
– Kết luận ngắn: bản sửa gỡ một vật cản (vòng lặp suy luận), không thêm kiến thức toán mới, tác giả MIT tự viết “Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked”.
MIT thực sự tuyên bố gì, và con số 48.1% đến từ thí nghiệm nào
Trước khi cãi nhau về đúng sai, mình cần đọc lại xem bài MIT viết gì thật, vì tranh cãi sau đó không phải về con số mà về cách một câu trong abstract gộp hai thứ khác nhau lại làm một.
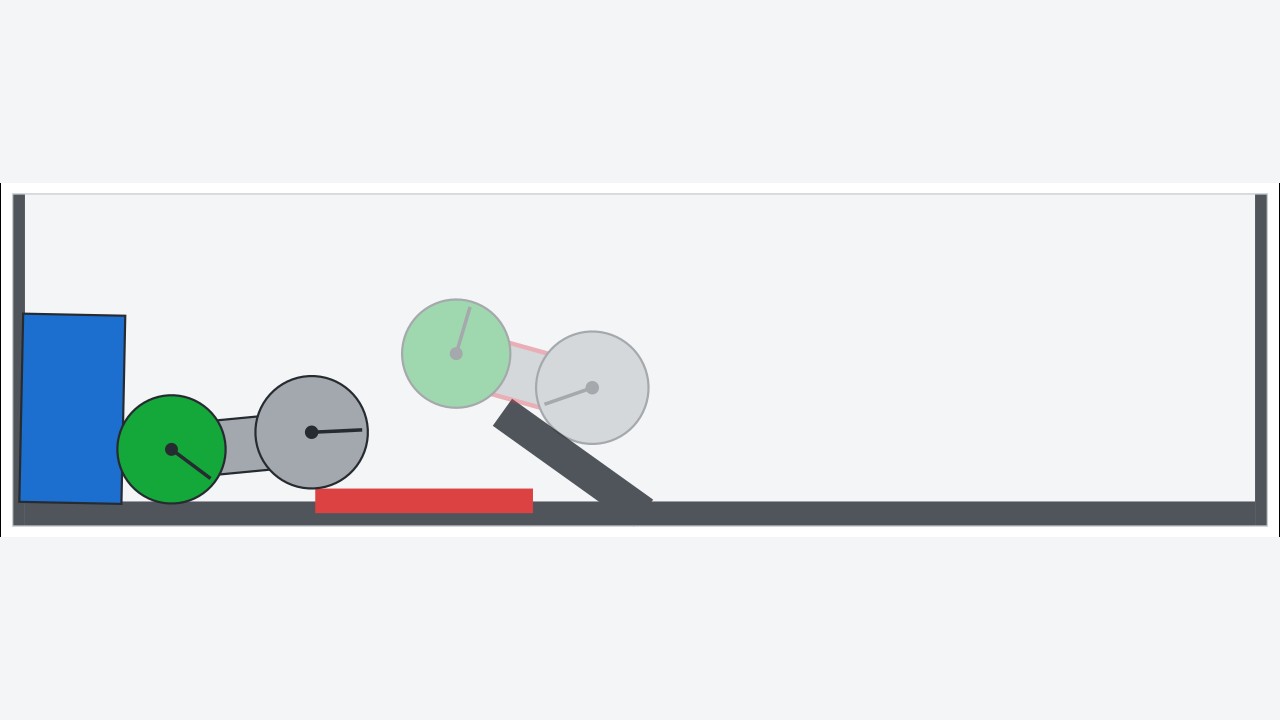
Ảnh thật từ blog gốc MIT, bản render tĩnh của cảnh xe trong môi trường Kinetix ở thí nghiệm 4.
Tuyên bố trong abstract và bài blog ngày 2/11/2026
Ngày 2/11/2026, Rikiya Takehi, Jayden Teoh (đồng tác giả chính), Alex Zhang và Omar Khattab ở MIT CSAIL đăng bài “Sparks of Weight-Space Programming” kèm toàn bộ logs trên GitHub. Câu mở đầu trong abstract viết rằng “Just by looking at the raw weights, GPT-6 Astra can tell what a network was trained to do” [tự báo cáo (MIT logs)], một câu rất gọn, rất kêu, và cũng chính là câu gây ra gần như toàn bộ rắc rối sau đó.
Định nghĩa của nhóm MIT thì thế này, weight-space programming nghĩa là một LLM đọc và viết trực tiếp weights của một mạng, không qua optimizer, không dùng gradient descent, và chính tác giả cũng tự gọi đây là “very early results”, thừa nhận năng lực còn hạn chế vì context length và harness. Cùng ngày 2/11, checkpoint Qwen đã sửa được đưa lên Hugging Face lúc 22:12 UTC [theo maccus.fr], và cần nhắc rõ, bài này chưa phải paper peer-reviewed, cũng chưa có arXiv tính tới đầu 3/11.
Cộng đồng Hacker News sau đó chỉ ra rằng từ “Likewise” trong abstract [ý kiến (HN)], một từ nối tưởng vô hại, lại gánh cả việc nối thí nghiệm đọc weights thô với thí nghiệm sửa Qwen thành một mạch, và mình chỉ ghi nhận đây là ý kiến cộng đồng, không dùng điểm số Hacker News làm bằng chứng vì hai nguồn ghi con số khác nhau.
8 thí nghiệm trong một cái nhìn, và bảng phân loại của Honnibal
Bảng dưới đây là xương sống của toàn bài, anh em đọc lướt thì cứ giữ bảng này trong đầu rồi đọc tiếp, vì mọi lập luận ở các mục sau đều bám vào nó. Bảng do Matthew Honnibal lập ra trong bài phản biện ngày 3/11 [ý kiến (Honnibal)], gồm 10 mục tính cả 7a, 7b và 8b.
| Thí nghiệm | Cách làm | Kết quả |
|---|---|---|
| Exp 1, đoán game, 17,253 weights | Đọc weights thô, không tool | Đúng 4/4 |
| Exp 2, đoán hình diffusion, 23,824 weights | Đọc weights thô, không tool | Đúng 3/3, vẽ outline thay vì hình đầy |
| Exp 3, ngôn ngữ LM nhỏ 7.16M weights | Python tới 100 lần chạy, không chạy mạng | Đúng cả 3 mạng trong cả 2 lần thử, tìm đúng induction head (Python 2.1/3.1/3.5, romaji 3.3, tiếng Anh 3.1), độ tin cậy tự báo 0.48 tới 0.62 |
| Exp 4, sửa policy xe kẹt dốc, 171,664 weights | Đọc weights thô, không tool | Gốc 0/256 episode thành công, sửa 3.5% weights trong 1 lần thử rồi thành công 1,024/1,024 episode |
| Exp 5, viết mạng MinAtar từ số 0 | Viết weights dạng text trong 1 reply | Breakout 517.4 so với PPO-100M 15.8 và PPO-500M 25.3, Seaquest 53.1 so với 5.6 và 88.9, Asterix 53.2 so với 25.8 và 55.2 |
| Exp 6, viết mạng Go 9×9, 1,480,274 weights | Sandbox Python, 0 tới 50 forward passes | 0 pass thắng hơn nửa số ván trước 2 mạng PPO nhỏ, 50 pass thắng mạng PPO cùng cỡ train 20 triệu ván |
| Exp 7a, phân biệt model nịnh | Python, chạy mô hình | Thất bại 4/4 lần thử, bản nịnh theo 100% gợi ý sai, bản thật chỉ theo 1 tới 3% |
| Exp 7b, phân biệt model nịnh bằng attention | Chạy 2 mô hình, chỉ xem attention | Đúng 3/3 cặp, head 10.2 ở bản nịnh dành 85.7% attention cho câu trả lời của user so với 0.75% ở bản thật |
| Exp 8, sửa Qwen3.5-0.8B | Python kernel, tới 50 forward passes | MATH-500 7.9% lên 48.1% ở 50 passes, 12.3% ở 10 passes, 14.1% ở 25 passes; GSM8K 13.8% lên 67.1% (25.7% ở 10 passes, 25.1% ở 25 passes); IFEval 21.0% lên 62.3% (49.0% ở 10 passes, 39.9% ở 25 passes); chạm giới hạn token 93.0% xuống 33.1% (87.2% ở 10 passes, 86.4% ở 25 passes) |
| Exp 8b, đối chứng Gemma 3 270M | Python kernel, tới 50 forward passes | MATH-500 6.8% lên tối đa 7.7% |
Nhìn vào bảng thì câu kết của Honnibal hiện ra rất rõ, ông viết rằng “The ‘just by looking at the raw weights’ setting (raw floats in context, no tools, no running the network) only appears in experiments 1, 2 and 4, on networks of 17K-172K weights” [ý kiến (Honnibal)]. Tức là kiểu đọc weights thô đúng nghĩa, không tool, không chạy mạng, chỉ xuất hiện ở ba thí nghiệm trên các mạng nhỏ ấy, còn mọi thí nghiệm trên language model thật đều phải dùng Python, và Simon Willison cũng đồng ý rằng bài báo đã gộp hai chủ đề đáng lẽ phải tách riêng [ý kiến (Willison)].
Thí nghiệm sửa Qwen thực chất đã làm gì
Thí nghiệm 8 làm việc hoàn toàn khác với kiểu đọc weights thô. Astra được cho một Python kernel trên weights của Qwen3.5-0.8B, không có GPU, cùng 7,469 bài luyện từ GSM8K và 7,275 bài từ MATH, toàn bộ đều lấy từ tập train, với ngân sách 10, 25 rồi 50 forward passes, mỗi pass mô hình trả lời tới 512 bài hoặc đọc tới 1,024 đoạn text, batch trung bình 64 seq, tối đa 512 [tự báo cáo (MIT logs)].
Không có training, không có gradient, đánh giá trên MATH-500, GSM8K và 6 benchmark khác, thinking bật, tối đa 32,768 token, Astra không bao giờ thấy đề test, sampling temp 0.6, top-p 0.95, top-k 20, presence penalty 1.5, mỗi điểm trung bình nhiều mẫu, MATH-500 lấy 4 mẫu mỗi bài, GSM8K và IFEval lấy 2, AMC23 lấy 16, MMLU-Pro lấy 1 trên 1,000 câu cố định [tự báo cáo (MIT logs)].
Vấn đề của Qwen gốc thì rất cụ thể, nó bị kẹt vòng lặp suy luận, 85/96 câu trả lời luyện tập đầu tiên chạy tới giới hạn 32,768 token, và 93% câu MATH-500 chạm giới hạn token, rồi Astra truy vết vòng lặp về một “hướng” do MLP ở layer 15 và 19 viết ra, trừ hướng đó khỏi 64 cột output ở mỗi layer, tổng 131,072 weights, tức 0.016%, trong đó 130,188 weights thực sự khác sau khi làm tròn [theo experiment README qua R&D World].
Cả quá trình tốn 80 lần chạy Python trong 20.3 giờ, gồm 4.7 giờ gián đoạn dịch vụ [theo R&D World]. MATH-500 nhảy vọt ở mốc 50 passes sau hai mốc 10 và 25 passes gần như đứng yên, một đường đi gập ghềnh cho thấy đây giống một lần “trúng” đúng bản sửa hơn là cải thiện dần đều.
Honnibal và Goedecke thực sự phản đối điều gì
Tới đây thì câu hỏi đổi từ “con số có thật không” sang “bài MIT đóng gói con số đó kiểu gì”, và đây là chỗ Honnibal với Goedecke, hai người viết phản biện cùng ngày 3/11, mỗi người đâm vào một điểm khác nhau, và cả hai đều không phủ nhận con số 48.1% [ý kiến (Honnibal, Goedecke)].
Honnibal nói bài MIT gộp hai kỹ thuật dưới một cái tên
Matthew Honnibal, tác giả spaCy và đồng sáng lập Explosion, đăng bài phản biện ngày 3/11/2026, gọi cách đóng gói của bài MIT là “massively misleading” [ý kiến (Honnibal)]. Bài MIT gộp hai thứ khác nhau dưới một cái tên “Weight-Space Programming”, một bên là đọc weights thô không dùng tool, chỉ ở thí nghiệm 1, 2 và 4 trên các mạng 17K tới 172K weights, một bên là dùng Python và chạy mô hình, là mọi thí nghiệm trên language model thật kể cả Qwen, nên độc giả đọc abstract dễ tưởng thí nghiệm Qwen cũng làm chỉ bằng cách nhìn weights thô, thực tế thì khác hẳn.
Ông viết nguyên văn: “What the Qwen result actually shows is that Astra can be prompted to devise and perform tasks that a human ML engineer could do”, tức là kết quả Qwen cho thấy Astra làm được việc của một ML engineer, tự lập kế hoạch, viết code phân tích, chạy mô hình, tìm lỗi rồi vá weights, chứ không chứng minh một năng lực “gestalt” duy nhất về weights, và bảng 10 mục của ông, đã trình bày ở mục 1, chính là bằng chứng cho luận điểm này.
Ông vẫn thừa nhận rằng “AI models of a year or two ago would have failed at all these tasks”, nên dù cách đóng gói có lệch thì năng lực agent của Astra vẫn là thứ thật.
Goedecke: đây là việc của người giỏi
Sean Goedecke đăng bài phản biện cùng ngày 3/11/2026, và ông đi vào từng việc cụ thể thay vì cãi về tên gọi. Đoán game quy về tính L2 norm của weights lớp đầu theo từng ô grid, khoảng 3 dòng Python, vì input channels đã được gán nhãn sẵn và layout game lộ rõ trên heatmap, paddle nằm ở hàng dưới thì là Breakout, mê cung thì là Pac-Man [ý kiến (Goedecke)], và ông viết: “It’s neat that Astra was able to calculate the norms in its head without executing Python, but not that impressive”.
Sửa Qwen thực ra là playbook quen thuộc, viết 4 cặp text lặp và không lặp, đo weights nào góp phần gây lặp, cắt dần rồi thử lại, tương đương kỹ thuật steering và ablation mà giới interp vẫn dùng từ lâu để gỡ hành vi khỏi model mở [ý kiến (Goedecke)], và ông kết luận: “Again, this is exactly what a competent human researcher could have and would have done”. Ông nói thêm: “I think a smart human ML researcher could perform all of these tasks”, và so sánh sửa weights trực tiếp với patch binary đã biên dịch, ấn tượng thật, nhưng cách tốt nhất vẫn là viết source rồi biên dịch lại, tức là train bình thường.
Rồi trong phần edit sau khi đọc phản hồi trên Hacker News, ông viết rõ “To be clear, I am very impressed!”.
Điểm nào mỗi bên đúng, và điểm nào bài MIT tự nhận
Honnibal đúng về framing, Goedecke đúng về tính “làm được bằng tay người” của từng bước, và MIT đúng về số liệu cùng việc Astra tự làm trọn chuỗi agent, thứ mà model một hai năm trước không làm được [ý kiến (Honnibal, Goedecke, Willison) và tự báo cáo (MIT logs)].
Bài MIT còn tự báo cả thất bại của mình, sycophancy 4 lần không phân biệt được, Gemma không cải thiện được, và Carl Franzen của VentureBeat đặt khung “model repair” thay cho kiểu nói “giỏi toán gấp 6 lần”, ông viết: “The experiment therefore demonstrated a form of model repair. It did not establish that Astra had inserted six times as much mathematical knowledge into Qwen” [ý kiến (VentureBeat)]. Anh em cứ mang theo khung 4 câu hỏi kiểm tra của Max Nardit khi đọc tiếp, trước khi tin con số 48.1% thì hỏi, được dùng công cụ gì, có vòng feedback không, baseline hỏng tới đâu, và có vượt ra ngoài một trường hợp không [ý kiến (Nardit)].
Vì sao 48.1% là sửa lỗi
Đây là mục quan trọng nhất cho anh em nào chỉ đọc một mục, vì nó trả lời thẳng câu “Qwen có giỏi toán gấp 6 lần không”, và câu trả lời nằm ngay trong chính bài MIT, ở thí nghiệm đối chứng mà nhiều bài đưa tin đầu tiên đã bỏ qua.
Chính tác giả MIT đã viết rõ, bản sửa chỉ gỡ vòng lặp
Trích nguyên văn để anh em tự đọc: “Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked” [tự báo cáo (MIT logs)], và họ còn viết thêm một câu cùng ý, cũng đáng trích trọn vẹn: “Fixing loops, however, is not the same as making a model better at math: it lets the model finish answers it could already work out”.
Cơ chế thì đã kể ở mục 1, Qwen gốc bị kẹt vòng lặp suy luận, 93% câu MATH-500 chạm giới hạn token 32,768, nên nhiều câu nó vốn giải được đã không kịp trả lời, và bản sửa trừ hướng lặp ở layer 15 và 19, 131,072 weights, tức 0.016%, trong đó 130,188 weights thực sự khác sau khi làm tròn [theo experiment README qua R&D World], giúp model hoàn thành câu trả lời thay vì lặp tới hết token.
IFEval củng cố thêm điểm này, một benchmark không liên quan gì tới toán mà tăng từ 21.0% lên 62.3%, gần gấp 3, vì vòng lặp đâu phải vấn đề riêng của toán, nên sửa nó thì task nào cũng hưởng lợi, và đó chính là dấu hiệu của “model repair” theo khung của VentureBeat [ý kiến (VentureBeat)].
Thí nghiệm đối chứng Gemma 3 270M
Gemma 3 270M là thí nghiệm đối chứng quyết định cách hiểu 48.1%, nên mình đưa thẳng số liệu của nó ra đây, kể cả phần bất lợi cho phe MIT. Gemma 3 270M bản instruction-tuned, hiếm khi lặp, chỉ 8.5% câu chạm giới hạn token so với 93% của Qwen [tự báo cáo (MIT logs)], MATH-500 gốc 6.8%, sau sửa thì 5 passes cho 7.0%, 10 passes cho 7.6%, 25 passes cho 7.7%, 50 passes cho 7.0%, không lần nào hơn khoảng 1 điểm, và Astra tự báo mức tăng này là “not established”.
Lý do theo bài MIT thì cũng rõ ràng, lỗi Gemma gặp là lỗi suy luận thường, tính sai, bước đại số sai, không có một thành phần duy nhất để tắt. Sampling theo model card với temp 1.0, top-k 64, top-p 0.95, tối đa 8,192 token. Kết luận rút ra thì gọn lắm, bản sửa gỡ một vật cản chứ không thêm năng lực mới, model nào không có vật cản đó thì cũng chẳng cải thiện được. Một chi tiết nữa đáng ghi, thread công bố của Takehi đã bỏ qua kết quả âm tính Gemma, theo tài khoản @1a3orn dẫn qua VentureBeat [ý kiến (VentureBeat)].
Đọc con số 48.1% thế nào cho đúng
Đọc con số 48.1% cho đúng thì có ba điểm cần giữ trong đầu. Điểm đầu tiên, 48.1% là số thật trong logs và đã được chạy lại gần đúng ở 51.0% [tự báo cáo (MIT logs) và chạy lại checkpoint (HF 51.0%)], chi tiết chạy lại nằm ở mục 5.
Rồi điểm thứ hai, mức tăng không mượt theo passes, 12.3% ở 10 passes, 14.1% ở 25 passes rồi nhảy lên 48.1% ở 50 passes, cho thấy một lần “trúng” bản sửa đúng chứ không phải cải thiện dần đều [tự báo cáo (MIT logs)].
Và điểm cuối cùng, GSM8K và IFEval cùng tỉ lệ chạm giới hạn token đều kể cùng một câu chuyện, gỡ kẹt chứ không phải dạy toán, số liệu đầy đủ nằm trong bảng ở mục 1 [tự báo cáo (MIT logs)].
Làm theo ngay, anh em cứ cầm khung 4 câu hỏi của Nardit ở mục 2 mà soi bất kỳ headline AI nào khoe điểm số, và áp vào Qwen thì đáp án là có Python và 50 passes, có vòng feedback, baseline hỏng nặng vì lặp, nhưng chưa vượt ra ngoài một trường hợp vì Gemma đã thất bại.
Willison tái hiện được gì trên laptop, và phần nào vẫn chưa ai tái hiện
Phản biện bằng lời thì vẫn là lời, nên mục này mình xem phần kiểm chứng bằng tay, một người chạy lại thí nghiệm đọc weights trên laptop của mình, và một người khác mở rộng nó lên 36 mạng, để xem nửa “đọc weights” của claim đứng vững tới đâu.
Simon Willison chạy lại thí nghiệm đoán game bằng Qwen 3.8 27B
Simon Willison đăng bài ngày 3/11/2026, dùng đúng prompt từ repo logs, chỉ khác weights, tức là cùng một đề bài đoán game, chỉ thay model chấm bài [tự báo cáo 1 lần thử (Willison)]. Kimi K3.1 Pro qua OpenRouter đoán đúng Breakout sau 9m41s với 19,493 reasoning tokens. Còn Qwen 3.8 27B bản Q4_K_M khoảng 17GB chạy bằng LM Studio, phải dùng context dài vì context mặc định 8,192 token bị lỗi, cho kết quả Pac-Man 72% sau 46m12s với 43,506 reasoning tokens, Pong 75% sau 1h4m54s, Breakout 88% sau 52m25s, và Freeway sai, đoán thành “A simplified Pac-Man-like grid game”, mỗi game chỉ 1 lần thử, đúng 3/4 game.
Thái độ của Willison vừa khen vừa giữ khoảng cách, đúng kiểu người vừa chạy thử xong, ông viết “This is impressive” nhưng cho rằng một người đủ kinh nghiệm với giấy bút cũng có thể làm được nếu đủ kiên nhẫn [ý kiến (Willison)], và ông kết lại: “It’s a cool paper, but some of the wider commentary I’ve seen around it does not feel justified. I’m not ready to declare that the age of source code is over and our future involves incomprehensible machines editing their own model weights in incomprehensible ways”, và Explainx cũng lưu ý rằng mỗi game chỉ 1 lần thử nên đây là hands-on anecdote, không phải benchmark [ý kiến (Explainx)].
Điểm đáng chú ý nhất với mình là thời gian suy luận, hàng chục phút mỗi game, gần một giờ cho Pong, tức là đây không phải kiểu “nhìn weights một cái là biết ngay”.
Van der Hoef mở rộng lên 36 mạng, Astra vẫn nhất nhưng lỗi có quy luật
Wolter van der Hoef đăng bài ngày 4/11/2026, lặp lại thí nghiệm 1 trên 36 mạng mới, 12 game gồm 4 game gốc và 8 game mới, với các cặp giống nhau như Freeway và Frogger, Snake và Maze, Pac-Man và Sokoban, 3 mạng mỗi game, khoảng 1 tỷ bước môi trường mỗi mạng, đúng prompt, kiến trúc và PPO hyperparameters gốc, code và data công khai tại github.com/wohoef/name-the-game [tự báo cáo (van der Hoef)].
Kết quả thì GPT-6 Astra đúng 27/36, tức 75%, GPT-6.1 Sol 24/36, GPT-6.1 Terra 17/36, DeepSeek V4 Flash 32/72 vì trả lời 2 lần mỗi mạng, Qwen 3.8 27B qua OpenRouter chỉ đúng 4/36, so với 3/4 của Willison chạy local, mẫu nhỏ, nhiễu lớn, và DeepSeek trả lời 2 lần mỗi mạng nhưng chỉ 13/36 lần hai đáp án trùng nhau, DeepSeek viết khoảng 42,000 output tokens mỗi đáp án trong khi Astra trung bình chỉ 2,300 [tự báo cáo (van der Hoef)].
Lỗi của Astra tập trung ở Maze, Snake và Sokoban, trượt cả 3 seed mỗi game [tự báo cáo (van der Hoef)], và tác giả nghi ngờ LLM chỉ tìm layout game và chiến lược chung rồi chọn game quen thuộc giống layout đó. Còn thí nghiệm thì “don’t establish whether that is what the LLMs are doing” [ý kiến (van der Hoef)], và một giới hạn nữa là game do tác giả tự implement, không phải code gốc, mạng Freeway thì học chiến lược “đi lên” gần như hằng số nên đoán đúng cũng không chứng minh khôi phục được hành vi tránh xe.
Phần nào của câu chuyện vẫn chưa ai tái hiện được
Phần chưa ai tái hiện được thì cũng cần ghi rõ, chưa có ai tái hiện độc lập bản sửa Qwen bằng Astra, chỉ có chạy lại checkpoint đã sửa, xem mục 5 [tự báo cáo (MIT logs) và chạy lại checkpoint (HF 51.0%)], và cũng chưa có peer review, chưa có bài arXiv tính tới đầu 3/11 theo maccus.fr. Willison tái hiện thí nghiệm 1 bằng model khác, 3/4 đúng, 1 lần thử mỗi game, đây là replication của nửa “đọc weights”, không phải của bản sửa Qwen [tự báo cáo 1 lần thử (Willison)], và van der Hoef mở rộng thí nghiệm 1, không chạm tới thí nghiệm 8 [tự báo cáo (van der Hoef)].
Ranh giới đứng vững tới lúc này gồm ba điểm, thứ nhất, đọc weights thô trên mạng nhỏ là có thật, thứ hai, viết mạng từ số 0 là có thật nhưng có giới hạn, số liệu đầy đủ nằm trong bảng ở mục 1 [tự báo cáo (MIT logs)], và thứ ba, sửa Qwen là có thật về mặt số liệu, xem mục 5, và anh em đừng đọc “tái hiện 3/4” thành “tái hiện toàn bộ câu chuyện”.
Checkpoint trên Hugging Face cho thấy gì, và giới hạn của việc kiểm chứng đó là gì
Sau hai mục phản biện và tái hiện, anh em có quyền hỏi “vậy con số 48.1% có bịa không”, và câu trả lời nằm ở một việc rất cụ thể, có người đã tải checkpoint đã sửa về, xác minh từng tensor rồi chạy lại toàn bộ MATH-500, và kết quả còn cao hơn con số tác giả công bố một chút.
Ahsen Khaliq chạy lại toàn bộ MATH-500 và ra 51.0%
Ahsen Khaliq ở Hugging Face đã dựng lại checkpoint từ logs bằng script apply_edit.py, xác minh SHA-256 từng tensor, rồi chạy lại toàn bộ MATH-500, 500 bài nhân 4 mẫu bằng 2,000 generations, 43.4M token, 51 phút trên H200, dùng vLLM 0.33.0 và math-verify 0.9.0, đúng protocol bài gốc. Kết quả 51.0%, với 31.6% câu chạm giới hạn token [chạy lại checkpoint (HF 51.0%)], so với 48.1% của tác giả và 33.1% chạm giới hạn token [tự báo cáo (MIT logs)], tức là con số chạy lại còn cao hơn một chút, không thấp hơn.
Chỉ có 2 tensor khác bản gốc, model.language_model.layers.15.mlp.down_proj.weight và model.language_model.layers.19.mlp.down_proj.weight, base revision 2fc06364715b967f1860aea9cf38778875588b17, checkpoint lên Hugging Face ngày 2/11 lúc 22:12 UTC [theo maccus.fr], license Apache 2.0, demo live tại akhaliq/weight-space-programming-demo. Checkpoint là thật, số liệu là thật, nên 51.0% là điểm tựa để bài này không bị đọc thành “bài gốc là bịa”, và cũng là lý do vì sao Honnibal và Goedecke phản đối cách đóng gói chứ không phản đối con số.
Giới hạn của việc kiểm chứng checkpoint
Nhưng giới hạn cũng rõ ràng không kém, bản chạy lại này chỉ kiểm chứng checkpoint đã sửa, không tái hiện lại quá trình Astra sửa. Maccus.fr nhấn mạnh “the method itself has had no outside review” [ý kiến (maccus.fr)], tức là phương pháp tự nó vẫn chưa có ai ngoài nhóm tác giả rà soát lại, và chưa ai chạy lại Astra từ đầu để sửa Qwen [tự báo cáo (MIT logs) và chạy lại checkpoint (HF 51.0%)].
Có hai chi tiết chỉ có một nguồn thứ cấp chưa đối chiếu, “158 lượt đối thoại” và “whitespace-tail degeneration ở 51/1,152 outputs”, mình ghi ra đây để anh em biết mà không dùng làm fact chính, vì một nguồn thì chưa đủ để tin. So sánh với Willison thì càng thấy rõ ranh giới, Willison tái hiện phương pháp thí nghiệm 1 bằng model khác, còn Khaliq chỉ chạy lại checkpoint thí nghiệm 8, hai việc khác nhau hoàn toàn, đừng gộp thành “đã có người tái hiện độc lập toàn bộ”.
Anh em tự kiểm tra trong 3 bước
Anh em muốn tự kiểm tra thì cũng không cần tin lời ai, cứ làm 3 bước này là đủ. Bước 1, đọc bảng phân loại thí nghiệm của Honnibal ở mục 1, xem thí nghiệm nào dùng tool, thí nghiệm nào không [ý kiến (Honnibal)]. Bước 2, tải checkpoint RikiyaT/Qwen3.5-0.8B-weight-space-programming trên Hugging Face, kiểm tra 2 tensor layer 15 và 19 khác bản gốc, base revision 2fc06364715b967f1860aea9cf38778875588b17 [chạy lại checkpoint (HF 51.0%)].
Bước 3, đối chiếu kết quả MATH-500 51.0% với 48.1% của tác giả và 31.6% chạm giới hạn token với 33.1% gốc, rồi tự hỏi “nếu đây là gỡ kẹt thì model nào khác cũng có kẹt tương tự không” [chạy lại checkpoint (HF 51.0%) và tự báo cáo (MIT logs)]. Ba bước này không cần chạy lại Astra, không cần GPU khủng, chỉ cần đọc bảng, mở model card và đối chiếu số, và đó là cách kiểm chứng vừa sức nhất cho anh em dùng model mở nhỏ.
“Weight-space programming” thực ra là gì, và còn gì chưa có câu trả lời
Gom hết số liệu và phản biện ở các mục trên lại, mình mới dám trả lời câu cuối, cái tên “weight-space programming” này thực ra chỉ thứ gì, và vì sao cả hai phe đều đúng một phần mà vẫn chưa ai có câu trả lời cuối cùng.
Weight-space programming, nói lại cho người dùng thực tế
Định nghĩa của MIT anh em đã đọc ở mục 1, LLM đọc và viết trực tiếp weights của một mạng, không qua optimizer, không dùng gradient descent [tự báo cáo (MIT logs)]. Diễn giải thực tế thì cần tách làm hai, với mạng nhỏ từ 17K tới 172K weights thì đọc weights thô không tool là có thật, ở thí nghiệm 1, 2 và 4, còn với language model thật thì Astra làm việc như một agent dùng Python và chạy mô hình, tự lập kế hoạch, viết code phân tích, tìm lỗi rồi vá weights [tự báo cáo (MIT logs) và ý kiến (Honnibal)].
Bài học thực hành cho anh em chạy model mở nhỏ thì rất đáng tiền, trước khi fine-tune, hãy tìm xem model có đang kẹt ở một vật cản đơn giản không, vòng lặp, token </think> có xác suất quá thấp theo bình luận trên Hacker News về mechanistic interpretability [ý kiến (HN)], steering vector hay ablation, vì gỡ kẹt có thể rẻ hơn train lại rất nhiều [ý kiến (Goedecke, Nardit)]. Nhưng đừng kỳ vọng vá weights thay cho train khi model thật sự thiếu năng lực, Gemma là bằng chứng [tự báo cáo (MIT logs)].
Nhóm MIT cũng đang xây benchmark và harness chuẩn cho Weight-Space Programming, một tín hiệu cho thấy chính tác giả cũng coi đây là khởi đầu, chưa phải kết luận.
Schmidhuber và câu hỏi “ai làm trước”
Phần này chỉ là một nốt tranh luận về tính mới, không dùng làm bằng chứng kỹ thuật, và mình kể ngắn cho đủ bức tranh. Jürgen Schmidhuber gọi hướng tiếp cận này là “old hat” trên X, viện dẫn công trình fast-weight thập niên 1990 của ông, còn Omar Khattab đáp rằng nhóm có trích các bài đó và gọi chúng là “far ahead of its time” [ý kiến (Schmidhuber, Khattab), dẫn lại cấp 2 qua The Decoder].
Trạng thái kiểm chứng thì cần ghi rõ, mình chưa đọc trực tiếp post X gốc hay bài The Decoder, chỉ ghi nhận ở mức “Schmidhuber nói vậy, Khattab đáp vậy theo The Decoder” [ý kiến (Schmidhuber, Khattab), dẫn lại cấp 2].
Bối cảnh học thuật thì thế này, Schmidhuber 1991 tới 1993 đề xuất mạng “chậm” học bằng gradient descent để lập trình fast weights của mạng khác qua các outer product cộng dồn, ngày nay gọi là keys và values, và bài 2021 của Schlag, Irie và Schmidhuber chứng minh tương đương hình thức giữa linear transformer và fast-weight controllers. Nhóm MIT có trích dẫn dòng công trình này trong bài gốc [tự báo cáo (MIT logs) và ý kiến (Schmidhuber)], và điểm mới theo Khattab là mức độ LLM hiện tại dịch được giữa ngôn ngữ con người và con số của mạng, một ý kiến về tính mới, không phải số liệu.
Bốn câu hỏi về Astra vẫn chưa có câu trả lời
Còn bốn câu hỏi chưa có câu trả lời, và mình liệt kê đủ cả bốn để anh em mang về. Thứ nhất, peer review, chưa có, cũng chưa có arXiv tính tới đầu 3/11 [tự báo cáo (MIT logs)].
Thứ hai, tái hiện bản sửa Qwen bằng Astra, chưa ai làm, chỉ có chạy lại checkpoint 51.0% [chạy lại checkpoint (HF 51.0%)]. Thứ ba, ranh giới áp dụng, Gemma thất bại cho thấy vá weights chỉ hiệu quả khi có một vật cản duy nhất để gỡ, chưa biết ranh giới này rộng tới đâu [tự báo cáo (MIT logs)].
Và thứ tư, cơ chế “hiểu” weights hay chỉ đoán layout, van der Hoef nghi ngờ LLM chỉ đoán layout rồi chọn game quen thuộc, thí nghiệm chưa chứng minh được cơ chế [ý kiến (van der Hoef)].
Willison để lại một câu vừa đủ làm điểm dừng cho mục này, ông viết rằng mình “not ready to declare that the age of source code is over” [ý kiến (Willison)], và Honnibal thì nhắc rằng model một hai năm trước đã thất bại ở mọi task này, nên dù framing có lệch thì năng lực agent vẫn đáng chú ý [ý kiến (Honnibal)]. Anh em muốn tự kiểm tra thì quay lại 3 bước ở mục 5, hoặc chia sẻ trải nghiệm thật nếu từng vọc model mở nhỏ và gặp vòng lặp tương tự.
48.1% là thật, và nó chứng minh ít hơn headline nói
Gom lại, MATH-500 từ 7.9% lên 48.1% ở 50 passes là thật trong logs và chạy lại được 51.0% ở checkpoint [tự báo cáo (MIT logs) và chạy lại checkpoint (HF 51.0%)], nhưng đó là gỡ vòng lặp ở layer 15 và 19, không phải Qwen giỏi toán gấp 6 lần, và Gemma gần như không cải thiện là bằng chứng đối chứng. Nhớ một dòng ở bảng Honnibal, chỉ thí nghiệm 1, 2 và 4 đọc weights thô không tool, còn thí nghiệm Qwen dùng Python và 50 forward passes [ý kiến (Honnibal)].
Willison tái hiện được nửa đọc weights trên laptop [tự báo cáo 1 lần thử (Willison)], nhưng chưa ai tái hiện bản sửa Qwen, chưa peer review.
Chốt lại cho anh em, khi thấy headline AI khoe điểm số, anh em hỏi 4 câu của Nardit ở mục 2, rồi tự kiểm tra bằng 3 bước ở mục 5, và nếu từng vọc model mở nhỏ thì bình luận chia sẻ trải nghiệm thật bên dưới, vì ranh giới của vá weights vẫn đang chờ những lần thử tiếp theo trả lời.
Nguồn tham khảo
- Blog MIT CSAIL, Sparks of Weight-Space Programming
- Matthew Honnibal, The Astra post is misleading
- Sean Goedecke, LLMs are not superhuman at reading and writing neural network weights
- Simon Willison, Qwen 3.8 27B on my laptop can interpret model weights, too
- Wolter van der Hoef, Sparks of Weight-Space Programming, 36 networks later
- Hugging Face, RikiyaT/Qwen3.5-0.8B-weight-space-programming
- VentureBeat, MIT researchers used GPT-6 Astra to edit Qwen weights
- Max Nardit, What each experiment measured
- Explainx, Weight-space programming, GPT-6 Astra edits Qwen weights
- LetsDataScience, GPT-6 Astra edited 0.016 percent of Qwen weights
- R&D World, MIT team says GPT-6 Astra can fix an AI model by editing its weights
- GitHub, lm_understand-logs
- Hacker News, thread phản biện Honnibal
- Hacker News, thread phản biện Goedecke
- Maccus, GPT-6 Astra Qwen weights
- arXiv, Linear transformers and fast-weight controllers
- Wikipedia, Weight-space programming

Tuấn Prompt
Thợ săn AI thực chiến của ThuThuatAI.net. Chuyên bóc tách tool, prompt và model AI mới — cái nào có lệnh cài, có giá, có số liệu kiểm chứng được thì mới lên bài. Viết như nói chuyện với anh em: có chuyên môn, có hài hước, và nói thẳng chỗ nào chưa kiểm chứng.
Bài viết Chuyên sâu Cùng Chuyên mục Tin tức AI
- Ram Altman gửi email báo RAM nhàn rỗi cho Sam Altman mỗi ngày
- Board Nvidia mở điều tra độc lập về Jensen Huang ngày 08/11, CEO thừa nhận ngoại tình nhưng cáo buộc gián điệp vẫn chưa được chứng minh
- Goldman Sachs thu hồi Claude Code khỏi tay banker và trader, chỉ để lại cho 12.000 kỹ sư
Bình luận & Trao đổi